Blog
 Public
- 24 Oct, 2026
Tripo P2.0 y el flujo de trabajo de Astra: generación e integración de assets 3D en Blender y Unity
Los flujos de trabajo 3D generativos están evolucionando desde la creación aislada de modelos hacia pipelines de assets integrados. El último modelo fundacional 3D nativo de Tripo, P2.0, está diseñado para generar mallas de triángulos o cuadriláteros con funciones como densidad de polígonos configurable, separación de partes, Smart UVs y edición regional de mallas. En combinación con Astra, estos assets se pueden ensamblar, riggear, animar e integrar en escenas interactivas mediante software profesional como Blender y Unity. Esta división del trabajo permite a los creadores centrarse en componentes concretos mientras Astra se encarga de coordinar las tareas posteriores, garantizando que la geometría generada admita de forma eficaz los requisitos de rigging, animación y producción en tiempo real.Publicación en X: https://twitter.com/luccacerf/status/2096308567863079420El flujo de trabajo funciona generando las partes individuales por separado, lo que da a los creadores un control preciso sobre la forma y los detalles. Por ejemplo, un creador puede generar el cuerpo, la cabeza y el pelo de un personaje como assets independientes, usando Tripo P2.0 o el modelo H3.1, que se centra en el alto nivel de detalle. Después, Astra ayuda a ensamblar estos componentes en Blender y gestiona la transición al rigging y la animación. Este enfoque modular permite a los usuarios perfeccionar o regenerar componentes concretos sin reiniciar todo el proceso de generación del asset. La capacidad de Astra se basa en razonar sobre tareas 3D y en ejecutar código o scripts para manipular assets, lo que la convierte en una herramienta potente para coordinar procesos complejos de varios pasos en entornos 3D consolidados.Publicación en X: https://twitter.com/Stefan_3D_AI/status/2096481425050743048Las aplicaciones prácticas de este flujo de trabajo ya han surgido en la comunidad. El creador Ring Hyacinth usó Nano Banana para las imágenes de referencia, Tripo P2.0 para el modelado y Codex para construir una escena de «Alicia en el País de las Maravillas» con efectos e interacciones. Del mismo modo, Lucca Cerf, que no tiene experiencia en desarrollo de juegos ni en diseño, utilizó un pipeline de Astra → Tripo P2.0 → Blender → Unity para crear un juego de fans de World of Warcraft. Con solo tres prompts, Cerf terminó el proyecto en unos 90 minutos. Estos ejemplos demuestran que la combinación de Tripo y Astra permite a personas sin experiencia previa en 3D crear rápidamente escenarios interactivos complejos y prototipos jugables.Las especificaciones técnicas de los modelos de Tripo están pensadas para estar listas para producción. La serie P optimiza la estructura de la malla, la topología y la capacidad de edición, mientras que la serie H prioriza la fidelidad en formas complejas. Los usuarios pueden gestionar la densidad de polígonos, elegir entre topología de triángulos o de cuads mediante Smart Mesh, y generar texturas y materiales. Las funciones de rigging y animación automáticos están disponibles para personajes, y los ajustes de exportación permiten controlar con precisión la escala, la orientación y los puntos de pivote al llevar los assets a Blender o a motores de juego. Este nivel de control garantiza que los assets generados cumplan los estándares técnicos exigidos por los motores en tiempo real y las aplicaciones DCC profesionales.El control de calidad sigue siendo un aspecto crítico del flujo de trabajo, ya que la IA acelera la creación pero no elimina la necesidad del criterio artístico. Tras el ensamblaje, los creadores deben revisar las proporciones, la alineación, las siluetas y las conexiones entre componentes. La animación exige evaluar la deformación en zonas como los hombros, los codos, las rodillas y la expresión facial. Aunque el flujo de trabajo encaja en las etapas de producción iniciales e intermedias, como la ideación, el prototipado y la previsualización, los estudios profesionales aún pueden perfeccionar los assets principales con herramientas DCC. El objetivo es hacer accesible la generación 3D de alta calidad sin exigir que cada creador se convierta en especialista en 3D, de modo que los artistas puedan centrarse en la dirección creativa y en la integración en sistemas artísticos cohesionados.
- Public
- 24 Oct, 2026
Ya están disponibles las grabaciones de JetBrains GameDev Day 2026: soluciones técnicas clave para el desarrollo moderno de videojuegos
El archivo completo de JetBrains GameDev Day 2026 ya está disponible en YouTube. Es un recurso exhaustivo para los desarrolladores que se enfrentan a retos reales de producción. El evento se celebró el 28 de septiembre y reunió a expertos de la industria para debatir las herramientas y metodologías que configuran el panorama actual de la ingeniería de videojuegos. Las sesiones se centran en la aplicación práctica: desde la integración de sistemas de entidades y componentes (ECS) en juegos en vivo hasta el uso de la IA para la generación procedimental de contenido. Los desarrolladores que siguieron la transmisión en Belgrado o Limassol, o quienes se perdieron el evento en directo, ahora pueden revisar el material a su propio ritmo para comprender mejor los flujos de trabajo y las herramientas del desarrollo moderno.Una parte significativa del contenido técnico se centra en la integración de la IA en los flujos de desarrollo existentes. Una de las sesiones clave muestra cómo la compatibilidad de TeamCity con Model Context Protocol y su interfaz de línea de comandos (CLI) llevan los procesos de integración continua directamente al entorno de desarrollo. Tomando como ejemplo un proyecto en Unity, la presentación demuestra cómo investigar los fallos de compilación e interactuar con los flujos de CI sin tener que cambiar constantemente entre distintas herramientas. Además, otra charla analiza los flujos de trabajo con agentes adaptados específicamente para Unreal Engine, que utilizan Rider, ACP y habilidades propias del motor. Estas demos ilustran cómo los agentes de IA pueden desenvolverse en arquitecturas de motor complejas, generar código en C++, investigar cierres inesperados y automatizar diversas tareas de desarrollo, yendo más allá de la simple asistencia en la escritura de código hacia una resolución de problemas más autónoma.Para los equipos que trabajan con assets de gran tamaño, la sesión sobre Lore VCS, el sistema de código abierto de Epic Games, ofrece información valiosa sobre la gestión de archivos de varios gigabytes que cambian a diario. A diferencia de los sistemas de control de versiones tradicionales, diseñados para código, Lore divide los archivos en fragmentos con direccionamiento por contenido, de modo que solo se transfieren las partes modificadas de un asset. En el debate se explica cómo las cachés de borde pueden llenarse bajo demanda en lugar de precargarse, y se incluyen instrucciones para desplegar el sistema con el módulo de Lore en AWS Cloud Game Development Toolkit. Este enfoque resuelve uno de los principales cuellos de botella del desarrollo de videojuegos actual, donde la gestión de assets suele ralentizar la colaboración y los procesos de compilación. Comprender estos mecanismos es fundamental para los estudios que quieran optimizar su infraestructura y reducir los costes de almacenamiento y de ancho de banda.La optimización del rendimiento y la depuración siguen siendo temas centrales, con sesiones detalladas sobre perfilado en Unreal Engine y depuración entre lenguajes. Uno de los ponentes utiliza el perfilado en directo para mostrar cómo pequeñas decisiones de ingeniería se acumulan hasta convertirse en cuellos de botella en la jugabilidad, y demuestra flujos de trabajo prácticos de optimización con Unreal Insights y Rider. Otra sesión aborda el complejo escenario en el que el cliente está escrito en C# y el servidor en C++, y muestra cómo depurar ambos entornos de ejecución a la vez con Rider y CLion. Este enfoque permite a los desarrolladores leer los datos que cruzan el límite del protocolo y determinar qué entorno de ejecución causa los problemas. Se subraya el límite entre entornos de ejecución como zona crítica de investigación, lo que ofrece un método estructurado para resolver errores que abarcan varios lenguajes y entornos.El evento también incluyó análisis en profundidad de integraciones específicas de motores y de automatización de la interfaz de usuario. Una sesión destacada presentó un flujo de trabajo de Figma a Unity que ha evolucionado a lo largo de años de uso en producción y que ahora funciona a través de un agente de IA mediante MCP. Los ponentes abordaron los fundamentos de diseño que hacen posible esta automatización, las lecciones aprendidas al construir el sistema y una prueba comparativa de qué tareas de integración de UI puede gestionar hoy el agente y cuáles siguen requiriendo intervención humana. Otra charla se centró en incorporar ECS a un juego en vivo de mercado masivo sin reescribir el motor, y trató estrategias de migración por etapas, compromisos en la disposición de la memoria y los beneficios de un enfoque híbrido que combina ECS con código heredado. Estas sesiones ofrecen estrategias prácticas para modernizar bases de código existentes sin perder estabilidad en productos en vivo.
- Public
- 24 Oct, 2026
NVIDIA TensorRT 11.1: Global Performance Tuner para la optimización automática de motores con control de la precisión
El despliegue de redes neuronales es, en esencia, un problema de compilación en el que no existe una única estrategia óptima para todos los modelos. Cuando NVIDIA TensorRT construye un motor de inferencia, toma decisiones interdependientes sobre las transformaciones del grafo, la fusión de kernels, la ubicación de la memoria y la cuantización. Este proceso, conocido como planificación (scheduling), influye considerablemente en el rendimiento final de la inferencia. Distintas opciones de planificación pueden conservar la semántica del modelo y, sin embargo, dar resultados de velocidad muy diferentes. Como estos efectos están relacionados entre sí y dependen de cada modelo, a menudo solo se aprecian una vez construido y medido el motor completo. Esto hace cada vez más difícil predecir la mejor estrategia a medida que se diversifican los modelos y los entornos de despliegue.Figura 1. Una receta fija única no escala ante preferencias de clientes contradictoriasHistóricamente, TensorRT se basaba en modelos internos de indicadores clave de rendimiento (KPI) para identificar patrones optimizables, que luego se codificaban como heurísticas en la estrategia de planificación predeterminada. Aunque esto permitía a los usuarios beneficiarse automáticamente del conocimiento experto, surgió un problema de escalabilidad. Una heurística diseñada para un tipo de modelo podía provocar una degradación del rendimiento en otro, lo que obligaba a añadir excepciones adicionales. Esto hacía que la lógica de planificación fuera compleja y difícil de ampliar. Global Performance Tuner, presentado en TensorRT 11.1, resuelve este problema al abandonar una única receta fija. En su lugar, trata el flujo del compilador como una receta base con «especias» configurables, lo que permite al sistema adaptar la ruta de optimización a las características específicas de cada modelo de entrada, ya sea un grafo ONNX o una red creada mediante la API de TensorRT.Figura 2. Ajuste el sabor para cada clientePara formalizar este enfoque, el sistema utiliza un marco matemático que separa la generación de candidatos de su selección. El espacio de modelos está formado por todas las entradas posibles, mientras que el espacio de soluciones contiene todas las salidas ejecutables, como los motores de TensorRT o las secuencias serializadas de kernels de GPU. Un algoritmo de construcción (builder) asigna a cada modelo un conjunto de candidatos, limitado por un umbral de tolerancia de error. Este umbral garantiza que los pares entrada-salida se mantengan dentro de límites aceptables, evitando que optimizaciones agresivas incumplan los requisitos de la aplicación. El objetivo del algoritmo de construcción es generar un conjunto amplio de candidatos que incluya la solución óptima, definida como la ejecución factible más rápida que cumple los criterios de precisión. Esta abstracción permite analizar con rigor cómo influyen las distintas rutas de construcción en el tiempo de ejecución final.A continuación, un algoritmo de búsqueda opera sobre este conjunto de candidatos para seleccionar la mejor solución. Idealmente, este algoritmo realizaría una evaluación exhaustiva de todos los candidatos para encontrar el de menor tiempo de ejecución. Sin embargo, en la práctica, los presupuestos de tiempo de construcción suelen limitar la profundidad de esta búsqueda. Por tanto, el compilador en su conjunto se representa como una tupla formada por un constructor (builder) y un buscador (searcher). La dificultad radica en crear un constructor óptimo que haga alcanzable la solución óptima global. Dado que no existe una única ruta de construcción universal que sirva para todos los modelos, el sistema debe admitir rutas de construcción personalizables. Esto significa que la secuencia de pasadas del compilador, que transforman las representaciones intermedias en ejecutables finales, puede variar. Distintos modelos pueden alcanzar su mejor rendimiento mediante secuencias de transformaciones diferentes, incluso en la misma GPU de destino.Global Performance Tuner aprovecha estas rutas de compilación personalizables para realizar un ajuste automático del rendimiento. Para cada candidata generada por las distintas rutas, el tuner valida los resultados según el criterio de precisión especificado. Después mide el rendimiento de inferencia de extremo a extremo de las soluciones viables. Entre todas las candidatas que cumplen los requisitos de precisión, el sistema elige la que tiene el menor tiempo de ejecución. Este enfoque garantiza que las mejoras de rendimiento no se logren a costa de la fidelidad del modelo. Al tratar el proceso de compilación como una búsqueda entre múltiples rutas de compilación posibles, y no como un único camino fijo, TensorRT 11.1 ofrece un método escalable para optimizar cargas de trabajo de aprendizaje profundo en modelos y configuraciones de hardware diversos.Esta metodología resuelve la limitación principal de los enfoques anteriores, en los que un cambio para un modelo podía degradar el rendimiento de otro. Al mantener estable el pipeline base y hacer configurables las decisiones de planificación, el sistema puede manejar con eficacia modelos nuevos con preferencias desconocidas. Ofrece distintas variantes de optimización, descarta las que no superan las comprobaciones de precisión y conserva la configuración con mejor rendimiento. Es análogo a un chef que ofrece muestras gratuitas a un cliente nuevo para encontrar la combinación de condimentos que prefiere, en lugar de imponerle una única receta estándar. El resultado es un proceso de compilación más robusto, que se adapta a las necesidades específicas de cada red neuronal y garantiza que los desarrolladores obtengan la mayor velocidad de inferencia posible sin comprometer la precisión que exigen sus aplicaciones.
- Public
- 23 Oct, 2026
Barreras estructurales para la adopción masiva de gafas de RA ópticas con pantalla transparente
El sector de la realidad aumentada óptica con pantalla transparente (see-through RA) atraviesa actualmente un importante giro estratégico. Durante años, la industria intentó obtener capacidades de RA a partir de visores de RV de gama alta, buscando un amplio campo de visión y funciones complejas, lo que daba lugar a dispositivos voluminosos y caros. Este enfoque se ha estancado en gran medida. La trayectoria actual consiste en ir construyendo a partir de gafas de IA solo con audio, como las Meta Ray-Ban Wayfarers, que han alcanzado un punto de inflexión crítico en los envíos anuales: aproximadamente 10 millones de unidades. Este volumen es una referencia clave para el mercado masivo. En cambio, los envíos de visores de RV han caído desde el máximo de 10 millones de unidades en 2021 hasta entre 3,5 y 6 millones en 2026, lo que indica que ir más allá del segmento de entusiastas sigue siendo un obstáculo considerable para los dispositivos inmersivos.Una de las barreras principales, y a menudo subestimada, para la adopción por parte del consumidor es la integración de lentes graduadas. Para los usuarios que necesitan corrección visual, las gafas de RA actuales suponen una pesadilla logística y ergonómica. A diferencia de las gafas de IA sin pantalla, en las que se pueden montar lentes graduadas estándar cortadas localmente para encajar en la montura, los dispositivos de RA con pantalla suelen requerir que las lentes graduadas se peguen en fábrica a las guías de ondas. Este proceso crea un SKU único para cada cliente, lo que conlleva plazos de entrega largos, de semanas. Además, estas graduaciones integradas a menudo no corrigen adecuadamente el astigmatismo ni la visión bifocal. Existen soluciones de lentes con clip de terceros, pero son demasiado voluminosas para funcionar como gafas normales, lo que limita su utilidad al ámbito empresarial o al contexto de la RV, y no al uso cotidiano del consumidor.Las tecnologías de pantalla necesarias para unas gafas de RA viables atraviesan un estancamiento significativo. Las pantallas MicroLED a todo color, que son esenciales para una buena legibilidad en exteriores, tardan en llegar a la producción. Los rumores actuales indican que, aunque algunos fabricantes podrían iniciar la producción a corto plazo, la resolución sigue siendo baja, normalmente en torno a 640 por 480 píxeles. Esta resolución de clase VGA es comparable a los estándares de los ordenadores personales de la década de 1980 y resulta insuficiente para consumir texto o contenido multimedia de alta fidelidad. La falta de micropantallas a todo color y de alta resolución implica que los dispositivos de RA actuales no pueden competir con la nitidez visual que los usuarios esperan de los smartphones o las tabletas modernos, lo que limita aún más su atractivo para el público general.Las cadenas de suministro de componentes sufren una presión creciente debido a la demanda explosiva de infraestructura de IA. El enorme consumo de semiconductores por parte de los centros de datos de IA ha absorbido la capacidad de fabricación disponible, dejando menos recursos para los fabricantes de electrónica de consumo. Esta escasez afecta a la disponibilidad de procesadores, memoria y otros componentes críticos necesarios para las gafas de RA. Además, la incorporación de cámaras introduce un compromiso complejo. Aunque las cámaras permiten funciones avanzadas como la localización y el mapeo simultáneos (SLAM), aumentan de forma considerable el consumo de energía, el tamaño y el peso. Un módulo de cámara puede consumir tanta energía como la propia pantalla, lo que dificulta mantener el formato de unas gafas normales y, al mismo tiempo, ofrecer una batería que dure todo el día.El sector debe evitar la trampa de centrarse en una única métrica, como el coste, para impulsar la adopción. Aunque el precio es un factor, es secundario frente a la funcionalidad y la usabilidad. Ejemplos históricos, como el Apple II y el Macintosh original, muestran que los precios iniciales elevados son aceptables si el producto ofrece un valor único. Intentar crear un dispositivo de bajo coste con una funcionalidad limitada supone una mala asignación de recursos. El desafío es sistémico: resolver un problema técnico, como el brillo de la pantalla, a menudo agrava otros, como el consumo de energía o la generación de calor. Existen aproximadamente entre diecisiete y veinte barreras importantes que deben resolverse de forma simultánea, entre ellas la transparencia, el brillo ocular, los artefactos de las redes de difracción y el oscurecimiento en exteriores.Para poder llevarlas todo el día, el dispositivo debe funcionar como unas gafas normales cuando está apagado. Si provoca distorsiones o una mala corrección de la visión cuando está inactivo, no cumple el requisito básico de ser unas gafas. Los usuarios no están dispuestos a quitarse las gafas y guardarlas en un estuche protector, lo que anula el sentido de un dispositivo vestible. Además, la integración de la pantalla con el mundo real degrada, por su propia naturaleza, la calidad de ambas imágenes. La presencia física de la óptica entre el ojo y el mundo introduce reflejos y artefactos. Por lo tanto, el desarrollo de gafas de RA requiere un enfoque holístico que aborde la fidelidad óptica, la comodidad ergonómica, la compatibilidad con la graduación y la disponibilidad de componentes como un único sistema interconectado, y no como una serie de problemas aislados.
- Public
- 23 Oct, 2026
Guía estratégica para desarrolladores de XR que entran en el mercado chino
El sector de la realidad inmersiva está definido actualmente por dos grandes potencias: Estados Unidos y China. Mientras que el mercado estadounidense está bien documentado, China sigue siendo un misterio para muchos desarrolladores occidentales debido al «Gran Cortafuegos» y a la abundancia de desinformación. Los medios tecnológicos occidentales suelen difundir narrativas inexactas, por ejemplo, sobre la existencia de un sistema universal de puntuación de crédito social o de un metaverso basado en WeChat, algo que no se corresponde con la realidad de quienes trabajan dentro del país. China tiene una población de 1400 millones de personas, de las cuales 870 millones tienen entre 15 y 59 años, lo que representa una enorme oportunidad para los equipos cualificados. Sin embargo, para tener éxito hay que dejar atrás los rumores y entender que el ecosistema local funciona con principios fundamentalmente distintos a los de Occidente.Creado con una imagen proporcionada por PicoA diferencia de Occidente, en China nunca hubo un «momento Quest», en el que un único visor de consumo combinara un precio asequible con una biblioteca de contenido sólida y propiciara su adopción masiva. Meta tiene prohibida la venta allí, y Pico, el competidor más cercano, cambió su enfoque estratégico poco después del lanzamiento de Pico 4, lo que dejó un casi vacío en el mercado de consumo de RV. Como resultado, un juego de éxito diseñado para el hogar, similar a Beat Saber, puede no encontrar una audiencia viable en el segmento de consumo local. En cambio, el éxito comercial en China, en línea con las tendencias generales de Asia Oriental, se debe a las experiencias de arcade fuera del hogar. Estas atracciones de RV están por todas partes: se encuentran en centros comerciales de casi todas las grandes ciudades, desde simples configuraciones con asiento hasta arenas de disparos contra zombis a escala de habitación. Aunque el hardware de estos arcades no siempre es de la última generación, la enorme densidad y accesibilidad de estos locales los convierten en el principal motor de ingresos del contenido de RV.Además de los arcades tradicionales, las instalaciones de RV a gran escala han ganado una popularidad considerable. Estos locales cuentan con grandes salas donde varios usuarios juegan simultáneamente experiencias individuales, con avatares de silueta blanca para moverse unos alrededor de otros sin chocar. El sector B2B también sigue activo, y la formación en RV tiene una importancia particular, aunque la inversión se ha enfriado a medida que se ha desvanecido el entusiasmo inicial por el metaverso. Actualmente, el foco de la industria se desplaza hacia las gafas inteligentes, que ganan prestigio a medida que los visores de RV pierden parte de la atención de los inversores. Grandes corporaciones como Huawei y Alibaba participan activamente; esta última lanzó recientemente unas gafas con seguimiento ocular para potenciar las capacidades de la IA. Empresas consolidadas como Rokid y RayNeo amplían sus gamas de dispositivos, mientras numerosas startups llegan al mercado con productos de nicho, desde asistentes de IA hasta usos especializados, como la natación.El auge de las gafas inteligentes está estrechamente ligado a la explosión de la IA en China, donde empresas como ByteDance desarrollan modelos de vanguardia comparables a los de OpenAI, y DouBao funciona como equivalente local de ChatGPT. Aunque aún no está claro cómo pueden los desarrolladores aprovechar plenamente este impulso de las gafas inteligentes, la infraestructura se está construyendo. Para los desarrolladores que quieran entrar en este mercado, el consejo más importante es conseguir un socio local o una red de contactos de confianza. Un socio local conoce el panorama regulatorio, las reglas no escritas del mercado y los matices culturales que pueden determinar el éxito o el fracaso del lanzamiento de un producto. Puede ayudar con la protección de la propiedad intelectual, el marketing y la adaptación del contenido a las normativas regionales específicas. Existen empresas especializadas que pueden tomar un juego de RV occidental, adaptarlo al público chino y encargarse de la distribución, incluida su adaptación a entornos de arcade si es necesario.Cortesía de Antony VitilloAdemás, diversos aceleradores e incubadoras, como los de Hangzhou, dan una cálida bienvenida a los emprendedores occidentales y, en ocasiones, ofrecen fondos regionales u oficinas subvencionadas para ayudarlos a desenvolverse en el complejo ecosistema tecnológico. La confianza es fundamental en estas relaciones: se recomienda buscar presentaciones a través de redes de confianza en lugar de contactos en frío. Igualmente importante es la localización del contenido. Distribuir contenido en inglés en China resulta ineficaz: los juegos, las presentaciones y los vídeos para redes sociales deben estar en mandarín. Aunque las herramientas de traducción con IA mejoran, siguen siendo torpes y propensas a errores, por lo que los hablantes de mandarín son indispensables para las interacciones en persona, sobre todo en los stands de las ferias. Los matices culturales también cuentan, como demostró el éxito de omitir los tutoriales a favor de pasar directamente a jugar durante una presentación en Nanchang en 2019, lo que prueba que el conocimiento local de las preferencias de los usuarios es vital para lograr su implicación.
- Public
- 23 Oct, 2026
VRChat añade seguimiento facial nativo a nivel de SDK en la beta abierta
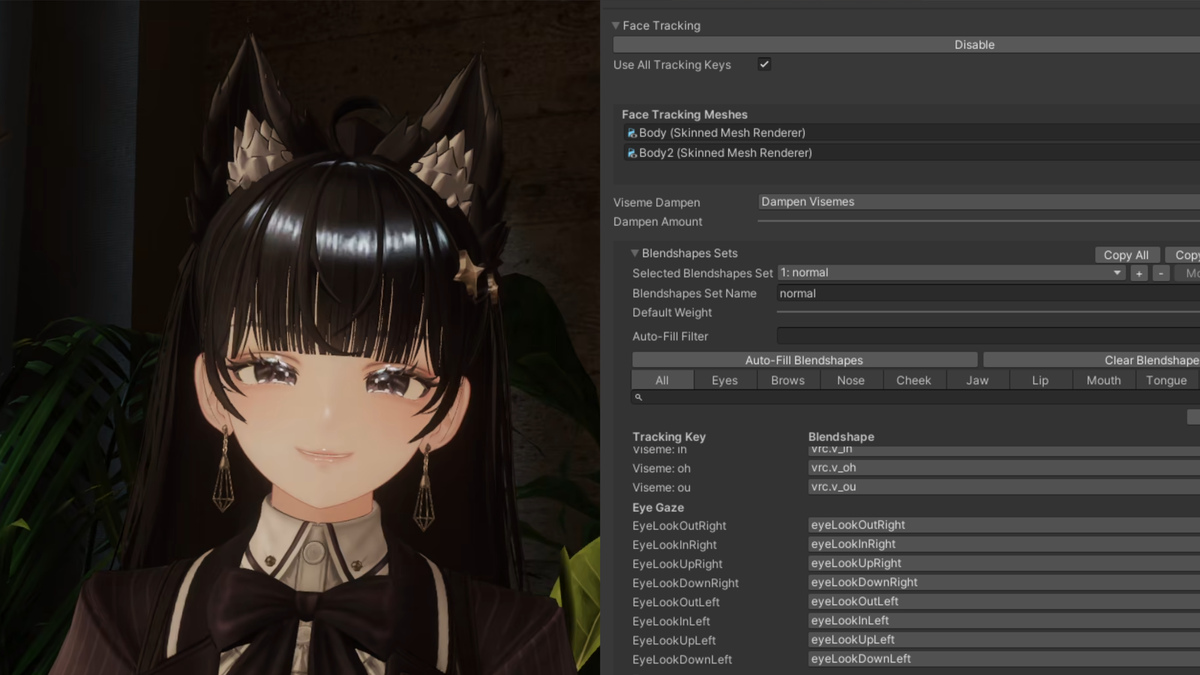
VRChat ha incorporado compatibilidad con el seguimiento facial nativo a nivel de SDK para avatares en el cliente Open Beta y en la versión beta del Avatars SDK. Aunque la plataforma ya admitía técnicamente el seguimiento ocular y facial desde hacía años mediante Open Sound Control y VRCFaceTracking, una aplicación creada por la comunidad, los avatares no contaban hasta ahora con capacidades nativas de seguimiento facial completo. Los usuarios tenían que configurar plugins para lograr expresiones detalladas, ya que la compatibilidad nativa se limitaba a la mirada básica y al movimiento de los párpados mediante los datos de Eye Tracking. Esta nueva implementación elimina esa dependencia y permite gestionar la animación facial de forma más directa y eficiente dentro de la estructura principal del software.El último cliente Open Beta en Steam y la versión 3.10.6-beta.1 del Avatars SDK permiten crear el seguimiento facial a nivel de SDK, denominado inicialmente High Fidelity Face Tracking. Ahora los creadores pueden configurar las expresiones faciales mediante una sección específica del componente Avatar Descriptor. El sistema asigna las expresiones a blendshapes y a parámetros del animador, y es compatible con el estándar Unified Expressions de VRCFT. Se integra sin fisuras con los visemas controlados por audio, la mirada y los párpados de VRChat, aunque por ahora no admite Blended Shapes ni Simplified Parameters. Esta integración nativa simplifica el proceso de creación y garantiza una mejor compatibilidad entre distintas configuraciones de avatares, sin necesidad de complejas configuraciones externas.Una ventaja importante de esta actualización es el seguimiento facial sincronizado en red, que no consume el presupuesto de parámetros sincronizados del avatar. Esta reducción de la carga de parámetros sincronizados se traduce en un mejor rendimiento general y en expresiones faciales visualmente más coherentes para otros usuarios en el espacio compartido. El sistema admite varios métodos de entrada, incluidos protocolos OSC como VRCFT en su última versión beta en Steam. También se integra con la función Selfie Expression de VRChat, que permite a los usuarios reflejar sus expresiones faciales en sus avatares en PC de escritorio y dispositivos Android mediante una webcam o la cámara frontal, lo que mejora la accesibilidad para quienes no tienen visores de RV específicos.La compatibilidad con el hardware varía, y actualmente pocos visores ofrecen tanto soporte de hardware como API de terceros para el seguimiento ocular y el seguimiento facial basado en cámara. Entre las opciones más populares están Pico 4 Pro y Enterprise, Meta Quest Pro y Samsung Galaxy XR. Para otros dispositivos, como Meta Quest 3 y 3S, existen soluciones de código abierto y creadas por la comunidad, mientras que VRCFT puede transmitir datos de dispositivos que solo ofrecen seguimiento ocular, como Bigscreen Beyond 2e. Creator Hash ha actualizado varios paquetes de avatares populares de Booth con variantes beta que utilizan esta nueva funcionalidad del SDK, lo que permite a los propietarios actuales cambiar de inmediato al sistema de seguimiento mejorado.Las próximas Meta VR Glasses incorporan soporte de hardware tanto para el seguimiento ocular como para el seguimiento facial basado en cámara, con sensores específicos para los ojos y cámaras orientadas hacia abajo para captar las señales del rostro. Sin embargo, a diferencia de Meta Quest Pro, Meta no ofrecerá en el lanzamiento acceso mediante API de terceros a la fuente de datos del seguimiento facial visual. Los desarrolladores solo tendrán acceso al seguimiento ocular y deberán recurrir a fuentes de datos controladas por audio, conocidas como Audio to Expressions. El seguimiento facial basado en cámara quedará restringido al uso propio de Meta, por ejemplo, para avatares holográficos realistas. Esta limitación ha causado frustración entre los desarrolladores, y Dilmer Valecillos, Meta Developer Advocate, ha reconocido los comentarios recibidos. Una solicitud de API basada en cámara en el sitio web Meta VR Developer está actualmente en lista de espera, lo que indica que el acceso para terceros llegará, pero sin un plazo definido.
- Public
- 23 Oct, 2026
Apple permite a organizaciones y centros educativos comprar suscripciones en volumen
Las organizaciones y los centros educativos ya pueden comprar suscripciones de renovación automática a apps en volumen mediante la compra de varias licencias. Esta función está diseñada para entidades que usan Apple Business o Apple School Manager, y les permite descubrir y comprar suscripciones directamente. Al adquirir el número necesario de licencias mediante una sola Apple In-App Purchase, las organizaciones pueden asignar y gestionar el acceso con sus herramientas de gestión de dispositivos existentes. El sistema ofrece flexibilidad: los administradores pueden añadir o quitar licencias en cualquier momento para ajustarse a las necesidades operativas actuales, sin renegociaciones complejas ni transacciones independientes para cada usuario.La compra de varias licencias para suscripciones está activada de forma predeterminada en App Store Connect, por lo que tu suscripción está disponible a la vez en Apple Business, Apple School Manager y el App Store estándar. Los desarrolladores mantienen el control total y pueden modificar estas opciones de disponibilidad en cualquier momento según su estrategia de distribución. La plataforma también admite suscripciones para grupos, lo que introduce un nuevo nivel de flexibilidad para el uso de consumidores y equipos pequeños. A partir del 28 de octubre de 2026, los desarrolladores podrán configurar y probar compras en grupo en su Apple Account de Sandbox para prepararse para el próximo lanzamiento. Este invierno, las compras en grupo estarán disponibles en el App Store, de modo que los usuarios podrán comprar varias licencias e invitar a otras personas a acceder a la suscripción, ampliando así el alcance de los modelos de negocio basados en suscripciones.
- Public
- 23 Oct, 2026
Vector Gear: un visor de RV totalmente abierto para makers y entusiastas
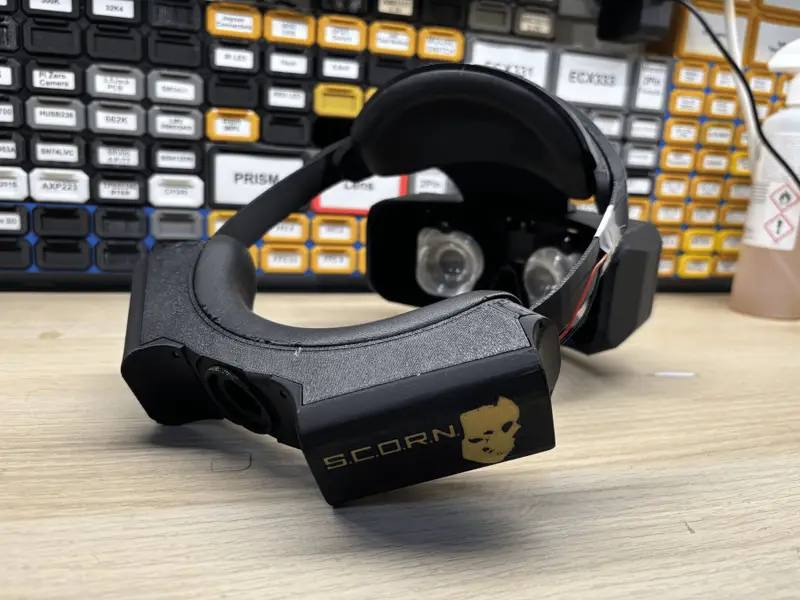
Walker Industries, un equipo de entusiastas de la RV de Japón, ha lanzado una campaña en Kickstarter para Vector Gear, un visor de RV de gama media totalmente abierto. El proyecto busca crear un dispositivo que se pueda personalizar por completo: tanto el hardware como el software están a disposición del público. Este enfoque permite a desarrolladores y usuarios modificar cualquier aspecto del sistema, desde el sistema operativo base hasta los componentes físicos. La compañía describe el proyecto como la realización de un sueño de hace mucho tiempo: crear un visor que no esté limitado por restricciones propietarias y ofrecer una plataforma transparente para la innovación y la experimentación en el ámbito de la XR.El Vector Gear se posiciona como el dispositivo estrella de la gama, ya que funciona tanto de forma autónoma como conectado a un PC. Junto a él, la campaña ofrece el Andromeda, pensado exclusivamente para PC-VR y disponible en dos versiones: una económica y otra con mayor resolución. Las especificaciones del Vector Gear son comparables a las de los líderes actuales del mercado, como el Quest 3, con una resolución y unas capacidades de chipset similares. A pesar de que el dispositivo lo desarrolla un equipo pequeño con un presupuesto limitado, cuenta con una amplia gama de funciones que compiten con las propuestas de grandes corporaciones. El objetivo es ofrecer un alto rendimiento sin el enorme coste que suele asociarse al desarrollo de este tipo de hardware.Una característica destacada del Vector Gear es su sistema integrado de seguimiento facial, llamado «Shinra Meisin», desarrollado por el propio equipo. Este sistema está diseñado para animar los avatares de los usuarios en plataformas sociales de RV como VRChat, transmitiendo los datos mediante OSC. Además, el visor y los mandos utilizan un sistema de seguimiento propio llamado «AstroSLAM». A diferencia del seguimiento inside-out estándar, los mandos incorporan cámaras propias que permiten colocarlos de forma versátil, incluso cuando se sostienen detrás de la cabeza o se usan para el seguimiento de objetos en accesorios. Este sistema de seguimiento es totalmente compatible con SteamVR, lo que garantiza una amplia compatibilidad con los títulos de PC-VR existentes y ofrece una base sólida para el desarrollo de nuevas aplicaciones.El ecosistema de software es igual de ambicioso y gira en torno a un sistema operativo personalizado llamado XRUIOS, basado en Arch Linux. Diseñado específicamente para RV, este sistema permite a los usuarios organizar objetos 3D para crear entornos de inicio personalizados, ejecutar widgets y abrir aplicaciones tanto de Steam como de un lanzador propio de Walker. Incluye integración con FEX, que permite ejecutar aplicaciones x86 estándar en la arquitectura ARM64 Linux. Uno de los widgets más notables es un emulador de MS-DOS, que permite ejecutar juegos antiguos. El sistema también incluye el «Yuuko Protocol», una herramienta multiplataforma que crea una experiencia cohesionada entre dispositivos y permite continuar sin interrupciones la reproducción de contenido multimedia o el acceso a archivos entre el visor, el teléfono inteligente y el PC.El precio del Vector Gear es de 980 dólares, mientras que los modelos Andromeda cuestan 650 y 1250 dólares, con descuentos en las versiones devkit para montar uno mismo. Se espera que la entrega a todo el mundo se realice en mayo de 2027, aunque se reconocen posibles retrasos. El proyecto se dirige a makers, entusiastas hardcore e instituciones de investigación que necesitan capacidades de personalización total y garantías de privacidad de los datos. Aunque Steam Frame ofrece una alternativa similar, si bien menos abierta, el Vector Gear se distingue por estar diseñado para poder desmontarse y modificarse por completo. Este nivel de apertura lo convierte en una herramienta única para quienes desean implicarse a fondo en las capas de hardware y software de la realidad virtual, apoyando un enfoque de desarrollo de XR impulsado por la comunidad.
- Public
- 22 Oct, 2026
Unity MethodReload: iteraciones más rápidas al evitar la recarga de dominio
Unity ha lanzado MethodReload, un paquete experimental diseñado para eliminar los tiempos de espera asociados a la recarga de dominio durante el desarrollo. Tradicionalmente, modificar el código de juego en el editor provoca un desmontaje completo y una reinicialización del Mono AppDomain, un proceso que puede cortar el impulso creativo. En los dispositivos la situación es aún peor, ya que IL2CPP no admite en absoluto la recarga de dominios, por lo que cada cambio exige recompilar por completo el reproductor. MethodReload resuelve este problema al permitir que los desarrolladores actualicen al instante el cuerpo de métodos concretos, de modo que las largas esperas de compilación se reducen a cuestión de segundos. Esta capacidad ya está disponible para su uso inmediato y busca agilizar el ciclo de iteración, tanto en las pruebas dentro del editor como en dispositivos.El paquete, que se encuentra en la versión 0.7.0-exp.1, se distribuye en el espacio de nombres com.unity.pipeline y requiere Unity 6.0 o posterior. Para usar esta función, los desarrolladores deben marcar determinados métodos con el atributo [MethodReload] antes de entrar en el modo Play o de compilar un reproductor. Este atributo debe estar presente en tiempo de compilación, porque la lógica de despacho se integra directamente en el bytecode del método. Solo son aptos para este tratamiento los métodos públicos de instancia o estáticos que devuelvan void o IEnumerator; cualquier otra firma se omite durante la compilación y se muestra una advertencia. Este requisito de precompilación garantiza que el entorno de ejecución pueda identificar correctamente qué métodos son candidatos a la actualización en vivo, sin interferir con el flujo de compilación estándar.Una vez colocados los atributos, el flujo de trabajo consiste en iniciar el MethodReload Watcher, que se encuentra en Project Settings, en los apartados Pipeline y Editor. En el Editor, al entrar en el modo Play se activa el sistema, lo que permite compilar e inyectar en tiempo real cualquier cambio en el código etiquetado. Para las pruebas en dispositivos, los desarrolladores deben compilar un player de desarrollo con el controlador Pipeline de tiempo de ejecución habilitado y conectarse mediante el Profiler o la ventana Console. Cuando se guarda un archivo que contiene un método etiquetado, el Editor lo compila usando las definiciones de preprocesador del player y envía la actualización a todos los dispositivos conectados. Este proceso no requiere reiniciar la aplicación y permite un ciclo de retroalimentación fluido. Además, hay comandos de Unity CLI disponibles para los flujos de trabajo en terminal, que permiten activar recargas de archivos o carpetas concretos directamente desde la línea de comandos.A pesar de su ventaja en velocidad, MethodReload funciona con limitaciones estrictas. Solo modifica los cuerpos de los métodos etiquetados y deja intactos los puntos de llamada, los campos y la estructura de los tipos. Por lo tanto, los desarrolladores no pueden añadir campos ni clases nuevos mediante una recarga. El intérprete ejecuta un subconjunto de C#, que excluye ciertas funciones complejas, aunque admite primitivos, bucles, delegados y corrutinas. Un analizador de Roslyn incluido en el paquete señala en el IDE la sintaxis no admitida. En los dispositivos con IL2CPP, el intérprete solo puede llamar a las API que ya estén referenciadas en la compilación; si faltan miembros, se producirán excepciones. Además, el código interpretado se ejecuta más despacio que el compilado, una contrapartida que solo afecta a las compilaciones de desarrollo. Las compilaciones de lanzamiento no incluyen el intérprete, de modo que no hay ningún impacto en el rendimiento en producción.Por dentro, MethodReload combina la interpretación de IL con el tejido de código en tiempo de compilación. Cada método etiquetado contiene un prólogo que consulta un registro para comprobar si hay una sustitución disponible. Si existe, el intérprete ejecuta el nuevo bytecode de IL; si no, se ejecuta el código compilado original. Esta arquitectura permite que IL2CPP compile el intérprete junto con el resto del juego, de modo que pueda ejecutarse en dispositivos sin servidores externos ni puertos abiertos. Aunque las herramientas existentes de la Asset Store ofrecen compatibilidad total con C# en el Editor, fallan en las compilaciones con IL2CPP. MethodReload cubre ese vacío y ofrece una solución viable para iterar en dispositivos. Para los desarrolladores cuyos problemas se concentran sobre todo en el Editor, las herramientas existentes pueden seguir siendo preferibles, pero para quienes apuntan a dispositivos con IL2CPP, MethodReload ofrece un camino único y potente hacia ciclos de desarrollo más rápidos.
- Public
- 22 Oct, 2026
Unity CLI: más de 200 millones de eventos generados por agentes de IA
Unity CLI es un único archivo binario que instala y gestiona Unity desde el terminal. Con la incorporación del paquete Pipeline, permite que scripts, sistemas de integración continua y agentes de código controlen una instancia de Editor en ejecución. Desde julio, más de 226 000 usuarios con la sesión iniciada han utilizado esta herramienta y han generado más de 200 millones de eventos. Los datos indican un patrón de trabajo claro: los desarrolladores configuran el entorno manualmente, mientras que la mayor parte del trabajo operativo se delega en agentes automatizados.Entre el 20 de julio y el 13 de octubre de 2026, alrededor del 98% de las ejecuciones de CLI procedieron de agentes de código y otras herramientas de automatización. La escritura manual en el terminal representó solo el 0,2% de los eventos, y los flujos de CI, el 0,3%. La pequeña proporción restante de ejecuciones no encaja en estas categorías concretas. Esta distribución pone de manifiesto un cambio en los hábitos de desarrollo: el terminal se usa principalmente para la preparación y la configuración iniciales, y no para una interacción manual continua con el motor.Cuando los desarrolladores interactúan manualmente, sus acciones se centran en la preparación. Las tareas habituales incluyen instalar el paquete Pipeline, abrir un proyecto con la versión correcta del Editor, iniciar sesión y configurar el agente para que apunte a Unity. Tras configurar la skill de la CLI, los desarrolladores ceden el control al agente. Este enfoque garantiza que Unity se integre sin fricciones en el ecosistema del agente que el desarrollador ya ha elegido, de modo que la IA asuma las tareas posteriores sin obstáculos.El propio comando unity representa más del 80 % de todos los eventos registrados. La CLI se utiliza principalmente para ejecutar acciones dentro de un Editor en funcionamiento, con comprobaciones ocasionales de su estado. Los desarrolladores han iniciado más de 1,3 millones de sesiones MCP, que es el modo que usan los agentes para conectarse a Unity mediante la CLI, y han abierto proyectos más de 150 000 veces. Este volumen de interacción subraya el papel de la CLI como puente central entre los flujos de trabajo basados en IA y el entorno de desarrollo de Unity.El uso se disparó tras el lanzamiento de los plugins oficiales de Unity para Claude Code, Codex y, recientemente, Grok. Estos plugins proporcionan a los agentes skills escritas por los equipos de Unity, incluidas capacidades específicas para manejar la CLI. El comando unity setup claude instala el plugin necesario para Claude Code, que también funciona dentro de la extensión de VS Code. Los agentes sin plugins oficiales, como Cursor y Cline, pueden operar igualmente a través de la CLI. Claude Code es el agente más utilizado, seguido de Codex, y las mayores bases de usuarios se encuentran en Estados Unidos, Japón, Corea del Sur y Alemania.
- Public
- 22 Oct, 2026
Aceleración de la carga de datos en la GPU con NVIDIA KvikIO y GPUDirect Storage
NVIDIA Magnum IO GPUDirect Storage (GDS) resuelve el cuello de botella que supone mover grandes conjuntos de datos desde el almacenamiento hasta los aceleradores, al habilitar una ruta de datos directa que evita el almacenamiento intermedio en la memoria de la CPU. A medida que los modelos de IA y los conjuntos de datos de entrenamiento crecen de forma exponencial, el movimiento eficiente de los datos resulta fundamental para mantener las GPU abastecidas. Aunque la interfaz principal de GDS es la API de C cuFile, Python sigue siendo el lenguaje dominante en el desarrollo moderno de IA. NVIDIA KvikIO cierra esta brecha al ofrecer interfaces de alto nivel e idiomáticas en Python y C++ para la E/S de archivos de alto rendimiento. La biblioteca se sitúa por encima de cuFile y ofrece controles adicionales sobre cómo se ejecutan las solicitudes de E/S, lo que permite a los desarrolladores gestionar la ruta de datos sin tener que recurrir a código C de bajo nivel.Figura 1. Flujo de ejecución correcto de una lectura con KvikIOLa arquitectura incluye dos puntos de decisión distintos para la selección de la ruta de transferencia de datos. En primer lugar, KvikIO determina si envía la solicitud a través de cuFile o utiliza su propia ruta de compatibilidad POSIX, que emplea la memoria del host como etapa intermedia. Esta elección depende del ajuste compat_mode, que puede tomar los valores AUTO, ON u OFF. En el modo AUTO, KvikIO intenta usar cuFile, pero recurre a POSIX si no está disponible. En segundo lugar, cuando cuFile recibe la solicitud, decide si utiliza la ruta acelerada GDS o su propia ruta de compatibilidad con almacenamiento intermedio en la CPU, según el soporte del sistema y la configuración. Por lo tanto, llegar a la API de cuFile solo confirma la selección de KvikIO, pero no garantiza que se haya usado la ruta acelerada GDS. Los desarrolladores deben verificar la ruta final para asegurar un rendimiento óptimo.Para empezar, configure un entorno de Python e instale la compilación de KvikIO para CUDA 13 con el comando pip install kvikio-cu13, que incluye CuPy como dependencia. Antes de realizar operaciones de entrada y salida, revise la configuración activa con la API de valores predeterminados de KvikIO. Entre los ajustes clave están compat_mode, que indica el modo activo, y gds_threshold, el tamaño mínimo de solicitud que se envía a cuFile. En el sistema de prueba, el umbral es de 16 KiB, lo que significa que las lecturas más pequeñas se realizan directamente por la ruta POSIX de KvikIO. Estos ajustes se pueden controlar mediante variables de entorno como KVIKIO_COMPAT_MODE y KVIKIO_GDS_THRESHOLD. Además, el script gdscheck.py permite verificar los componentes de GDS instalados, los sistemas de archivos compatibles y la configuración activa de cuFile en la plataforma.Para leer datos en la memoria de la GPU, asigne un array de CuPy del tamaño adecuado y use el gestor de contexto kvikio.CuFile para realizar la lectura. Por ejemplo, para leer un archivo de 1 GiB hay que crear un búfer de CuPy de 1 GiB y pasarlo al método read. Para verificar la ruta de transferencia de datos, active las estadísticas de ejecución de cuFile definiendo la variable de entorno CUFILE_STATS_LEVEL=3 y ejecutando el script en modo interactivo. A continuación, use gds_stats para inspeccionar los contadores. En la salida de cada GPU, nvfs cuenta las operaciones que usan el módulo del kernel nvidia-fs (ruta acelerada), mientras que posix cuenta las operaciones que usan la ruta de compatibilidad. Con la configuración predeterminada, una lectura de 1 GiB se divide en 256 operaciones de 4 MiB cada una, todas con nvfs=256 y posix=0, lo que confirma que se usó la ruta acelerada.Es posible un control adicional modificando por separado los ajustes de KvikIO y de cuFile. Definir KVIKIO_COMPAT_MODE=off obliga a KvikIO a usar cuFile, mientras que CUFILE_FORCE_COMPAT_MODE=true obliga a cuFile a usar su ruta de compatibilidad, lo que hace que aparezcan contadores posix en las estadísticas. Por el contrario, KVIKIO_COMPAT_MODE=on omite cuFile por completo y utiliza el backend de KvikIO con almacenamiento intermedio en la CPU. Además de la selección de la ruta, los parámetros de ejecución de cufile.json controlan cómo se procesan las solicitudes. KvikIO divide las operaciones grandes en tareas según KVIKIO_TASK_SIZE, que luego se envían a cuFile. cuFile puede dividir aún más estas solicitudes según su grupo interno de hilos y min_io_threshold_size_kb. Por ejemplo, una solicitud de 1 GiB con un tamaño de tarea de 4 MiB genera 256 solicitudes independientes a cuFile, cada una de las cuales se procesa como una sola pieza.Si KvikIO envía a cuFile una única solicitud grande (por ejemplo, de 1 GiB), cuFile puede dividirla en partes más pequeñas para su procesamiento en paralelo, limitado por el número de hilos de trabajo y por max_request_parallelism. En una configuración con cuatro hilos de trabajo, una solicitud de 1 GiB se divide en cuatro partes de 256 MiB. Dado que el búfer de destino no está registrado para DMA desde el almacenamiento, cuFile utiliza un búfer intermedio de GPU registrado y copia los datos en bloques de no más de 16 MiB. El parámetro min_io_threshold_size_kb influye en la planificación de las solicitudes; por ejemplo, una solicitud de 16 MiB puede dividirse en dos partes de 8 MiB para cumplir el umbral. KvikIO forma parte de las bibliotecas CUDA-X y se ha utilizado en cuDF, cuCIM y cuPhoton para acelerar la ingesta de datos en formatos Parquet, ORC e imágenes científicas. Comprender estas capas permite a los desarrolladores ajustar el rendimiento de la E/S para cargas de trabajo concretas.