Blog
 Public
- 18 Nov, 2026
Revopoint MIRACO 2: escáner 3D portátil con Gaussian Splatting y Scan-to-CAD
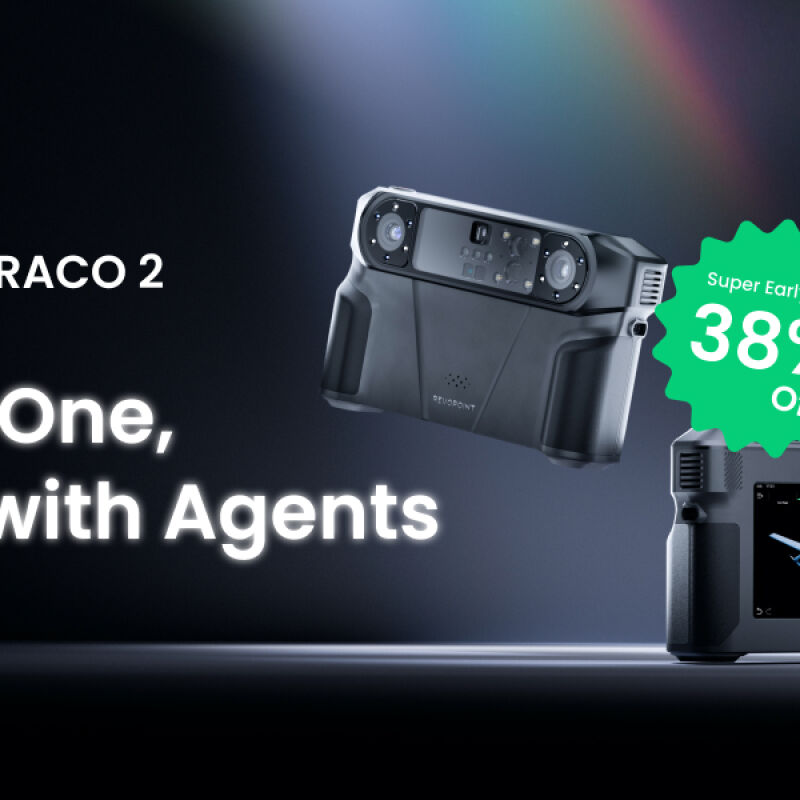
Revopoint lanzará MIRACO 2 en Kickstarter el 18 de noviembre de 2026. Es un escáner 3D portátil todo en uno: puede con piezas mecánicas pequeñas, con objetos muy detallados, con personas y esculturas, y también con espacios grandes. El dispositivo de mano, de 960 gramos, calcula la profundidad por sí mismo, procesa nubes de puntos, muestra vistas previas de los escaneos y permite realizar ediciones sencillas. De ello se encargan una CPU de ocho núcleos y una NPU de seis núcleos. El escáner funciona en tres configuraciones. En el modo autónomo (Standalone Mode), el escaneo, la previsualización, el procesamiento y el ajuste se realizan en una pantalla táctil AMOLED de seis pulgadas con resolución 2K. En el modo inalámbrico (Wireless PC Mode), el escáner se conecta a una estación de trabajo por Wi-Fi 6, y en el modo por cable (Wired PC Mode) lo hace mediante USB-C 3.0, lo que garantiza un trabajo estable centrado en el rendimiento. Con un PC equipado con una GPU potente, el escaneo láser multilínea alcanza hasta 120 fotogramas por segundo. Las aportaciones limitadas Super Early Bird comienzan en 1425 $, con un descuento de hasta el 38 %.El escáner cuenta con seis modos para distintos tamaños, materiales, niveles de detalle y condiciones de captura. Un láser azul cruzado de 34 líneas cubre superficies más grandes, y un láser paralelo de 15 líneas se dirige a los detalles finos. Un láser azul de una sola línea se ocupa de huecos estrechos y geometrías rehundidas. El modo Full-Field HD captura detalles sin los pasos más lentos del láser de precisión, y VCSEL Rapid es adecuado para objetos grandes. Hybrid HD combina la captura detallada con un seguimiento fiable y alcanza hasta 10 millones de puntos por segundo. La precisión de un solo fotograma llega a 0,02 mm en el modo láser multilínea. Entre los objetos compatibles se mencionan metales reflectantes, objetos oscuros, estructuras complejas y cuerpos humanos. El volumen mínimo de escaneo recomendado es de 10 × 10 × 10 mm. Con el kit opcional Photogrammetric Metrology Kit, el máximo aumenta hasta 5 × 5 × 5 metros. Al conectarse a un PC, los modos de láser de líneas admiten el seguimiento sin marcadores de objetos con textura.Las nubes de puntos en bruto suelen requerir fusión, limpieza, comparación o reconstrucción antes de resultar útiles para el diseño, la fabricación o la inspección. Revopoint aborda esta fase con Revo Agents, un ecosistema para trabajar con datos 3D del mundo real basado en agentes. En lugar de un procesamiento manual paso a paso, se controla mediante comandos en lenguaje natural. Entre los planes figuran la fusión de nubes de puntos en tiempo real, la conversión automática Scan-to-CAD y el análisis de tolerancias Scan-to-Inspection. Por ejemplo, el usuario podrá pedir al sistema que convierta una parte concreta de un escaneo en geometría CAD. También será posible comparar un escaneo con un modelo de referencia para encontrar diferencias dimensionales. El objetivo es reducir el trabajo repetitivo entre la captura y la labor de ingeniería. Aun así, la geometría CAD, las tolerancias y los resultados de la inspección deben seguir siendo validados por una persona.Para el desarrollo de videojuegos, VFX, XR, la preservación digital del patrimonio y la visualización, MIRACO 2 cuenta con un sistema de dos cámaras RGB. La cámara de corto alcance de 2 MP captura los objetos cercanos, y la de largo alcance de 50 MP, los objetos grandes y los entornos. Al conectarse a un PC, el dispositivo admite 3D Gaussian Splatting a escala física real. Exporta modelos en formato .splat a escala uno a uno con las dimensiones reales, para proyectos de XR, documentación espacial y gemelos digitales. El 3DGS conserva los espacios reales con todo su detalle visual, sin reconstruirlos como polígonos. Para la edición, la animación, la simulación y la producción de videojuegos siguen siendo necesarias las mallas convencionales. La función AI Segmentation elimina los puntos del entorno que sobran, y AI Cropping aísla el sujeto para su posterior procesamiento.El mismo dispositivo sirve para distintos flujos de trabajo. Un diseñador puede reconstruir componentes de un prototipo en CAD, y un equipo de control de calidad, comprobar una pieza fabricada frente a su modelo de referencia. Un artista de VFX puede escanear un objeto para una producción, y un creador de XR, conservar una ubicación como un Gaussian Splat a escala real. MIRACO 2 está preparado para su uso en interiores y exteriores con una luz ambiental de hasta 100 000 lux. Su batería de 10 000 mAh dura unas tres horas y admite carga rápida de 65 W. Habrá dos configuraciones: 16 GB de RAM con 256 GB de almacenamiento, o 32 GB de RAM con 512 GB de almacenamiento.
- Public
- 18 Nov, 2026
Daviator acelera VASP en las GPU de NVIDIA: cálculo por lotes de puntos k y precisión mixta
Para entrenar potenciales interatómicos de aprendizaje automático (MLIP) se necesitan decenas y cientos de millones de cálculos DFT de energías, fuerzas y tensiones. Lo más habitual es obtenerlos con VASP, el principal código DFT de ondas planas. En estas tareas suelen usarse celdas unitarias pequeñas y mallas densas de puntos k, y las GPU quedan infrautilizadas. El port de VASP a OpenACC procesa los puntos k de forma secuencial, por lo que en los sistemas pequeños cada paso lanza cientos de kernels diminutos y la sobrecarga de lanzamiento se come todo el tiempo. Un sistema de un solo átomo de hierro con 752 puntos k se calculaba en la GPU 8 veces más lento que en la CPU, y los investigadores tenían que repartir las tareas a mano según su tamaño. Además, el FP64 está estancado: el rendimiento en FP64 de Hopper, Blackwell y Rubin no crece, mientras que el FP32 sigue aumentando. La RTX PRO 6000 tiene una relación FP32:FP64 de 64:1.Figura 1. Comparación del rendimiento en FP64 y FP32 en distintas GPU de NVIDIADaviator es una biblioteca de kernels de GPU de NVIDIA que sustituye los bucles por punto k por operaciones por lotes. Su base es un solucionador de Davidson por lotes que usa FFT por lotes, GEMM por lotes y kernels propios. Al haber menos lanzamientos, la ocupación de los SM se acerca a la saturación, y los datos permanecen en la memoria de la GPU. VASP conserva el bucle SCF, la mezcla, la simetría y la entrada/salida, mientras que Daviator se conecta en límites de llamada bien definidos. Se activa mediante el microservicio NVIDIA ALCHEMI VASP con el parámetro LDAVIATOR=True en INCAR e intercepta el solucionador de Davidson (ALGO = Normal). No hace falta modificar los archivos de entrada existentes. El ejemplo usa un único átomo de Fe con ISPIN = 2, NBANDS = 12, PREC = Accurate y una malla de 30x30x30 centrada en el punto Gamma.Algunos kernels están especializados para determinados tamaños de lote y pueden compilarse en el primer uso. Por eso, en los scripts de los trabajos conviene apuntar CUDA_CACHE_PATH a un almacenamiento rápido, como /tmp/cudacache, y no a $HOME, y establecer CUDA_CACHE_DISABLE=0. Los cálculos se lanzan como de costumbre, por ejemplo mpirun -np 1 vasp_std. Por ahora solo se admite un nodo; el modo multinodo, vasp_ncl y vasp_gam están previstos. Como referencia se tomó VASP 6.6.0 en CPU y con OpenACC en H100/H200 y B200. Un átomo de hierro se calcula más de 2 veces más rápido que en CPU. LiFePO4 con r2SCAN acelera el solucionador de Davidson 22 veces, y el GaAs dopado con Bi de 64 átomos reduce el tiempo de cálculo en más de un 85%. Incluso un sistema de 348 átomos con un solo punto k mejora, de modo que ya no hace falta clasificar los trabajos por tamaño. Según las estimaciones para conjuntos de datos, el tiempo hasta el resultado se reduce hasta 22 veces y el coste hasta un 75% en comparación con la CPU.Figura 2. Comparación de VASP OpenACC v6.6.0 estándar, VASP OpenACC (OpenMP/MPS) con dos parámetros optimizados (número de procesos MPI e hilos OpenMP) y VASP con compatibilidad con Daviator: tiempo de ejecuciónDaviator por lotes sigue calculando en FP64, y crear un solucionador de Davidson de precisión mixta no es sencillo. Si se pasan los kernels a FP32 y se compara el resultado con FP64, solo se obtiene «pasa» o «no pasa». Sin embargo, los fallos ocultos, como la deriva de la energía, una convergencia incorrecta o trayectorias de DM divergentes, pueden parecer perfectamente verosímiles. Por eso se usa un tipo genérico de coma flotante con número configurable de bits de mantisa y de exponente. Con él se determina la precisión mínima necesaria para cada kernel y se decide si pasarlo a FP32, reescribirlo o dejarlo como «isla» FP64. Los resultados dependen de los datos de entrada y del umbral. La instrumentación debe abarcar también las dependencias y las funciones matemáticas, y las ejecuciones instrumentadas, que son lentas, pueden paralelizarse en recursos de HPC. Se empieza con conversiones FP64↔FP32 alrededor de la ruta crítica y con kernels de tipo configurable, y después, iteración tras iteración, se reducen las regiones FP64.Figura 3. Número de bits de mantisa y de exponente necesarios para un kernel de reducción instrumentado, medido con la implementación del proceso de análisis descrito basada en VerificarloEl análisis basado en Verificarlo mostró que las FFT, la aplicación del hamiltoniano y la actualización de los orbitales se pueden pasar a FP32. El problema de valores propios en el subespacio, las energías, los criterios de convergencia y los GEMM altos y estrechos con los que se construyen las matrices del subespacio se mantuvieron en FP64. Estos GEMM del método de Rayleigh-Ritz alimentan un solucionador de valores propios sensible, por lo que se aplica un algoritmo split-k: los productos escalares se calculan por bloques en FP32 y la suma final se realiza en FP64. El umbral EDIFF de VASP es por defecto de 10-4 eV y puede bajar hasta 10-6 eV o menos, mientras que FP32 ofrece unas 7 cifras significativas. El solucionador mixto converge hasta 10-4-10-6 eV según los datos de entrada, y por debajo del nivel de ruido de FP32 el cálculo continúa en FP64. En GaAsBi-64, FP32 da una aceleración de 2 veces con EDIFF = 10-5 eV, y la combinación FP32→FP64 con 10-8 eV funciona 1,5 veces más rápido que FP64 puro.Figura 5. a) GEMM ingenuo para matrices altas y estrechas: los productos escalares generan sumas largas en FP32, y para alcanzar la precisión objetivo se requiere FP64; b) Algoritmo de precisión mixta que ejecuta GEMM pequeños en FP32 con acumulación finalEn H100 y H200, donde los Tensor Cores FP64 igualan a FP32 en rendimiento, la ganancia es pequeña. En cambio, en la RTX PRO 6000 el solucionador de Davidson en FP32 funciona de 3 a 7 veces más rápido, y el cálculo completo, aproximadamente 2 veces. La precisión mixta se activa con el parámetro LDAVIATOR_MIXED_PRECISION (0 significa FP64). Cada paso iónico comienza con almacenamiento en FP32 hasta alcanzar DAVIATOR_EDIFF_FP32 o DAVIATOR_SWITCH_TO_FP64_AFTER_STEP; para la mayoría de los datos de entrada sirve un valor de 10-4-10-5. El ejemplo establece EDIFF = 5e-07, LDAVIATOR = True, LDAVIATOR_MIXED_PRECISION = True, DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2 y DAVIATOR_EDIFF_FP32 = 5e-05. Se necesita una licencia de VASP, y Daviator con precisión mixta funcionará en cualquier GPU de NVIDIA a través del microservicio ALCHEMI VASP.Figura 4. Disposición en memoria de los formatos de número de coma flotante más habituales
- Public
- 18 Nov, 2026
Apple anuncia los 45 finalistas de los App Store Awards 2026
Apple ha anunciado los 45 finalistas de los App Store Awards de este año. Los han elegido los editores de App Store de todo el mundo, valorando la experiencia de usuario, el diseño, la innovación técnica y el impacto cultural. La lista corta incluye apps y juegos para iPhone, iPad, Mac, Apple Vision Pro, Apple Watch, Apple TV y Apple Arcade, además de una categoría independiente de «Impacto cultural». Los ganadores se darán a conocer en las próximas semanas. Carson Oliver, vicepresidente de App Store, destacó los juegos basados en mundos imaginativos y en el juego compartido, así como las apps que ayudan a las personas a aprender nuevas habilidades y a apoyar a sus comunidades.Entre las apps para iPhone, los finalistas son ElevenReader, que lee textos en voz alta con voces de IA de sonido natural, (Not Boring) Camera, que convierte el teléfono en una cámara de estilo clásico personalizable, y Raylie, un acompañante guiado y personalizado para los vuelos. Los juegos nominados para iPhone son BALL x PIT, DAVE THE DIVER y Gambonanza, que le da la vuelta al ajedrez tradicional. Entre las apps para iPad figuran Cosmos, Kiddopia y Mockup, una herramienta para diseñar sitios web y apps, y entre los juegos están Aniimo, Arknights: Endfield y Where Winds Meet.La lista de Mac incluye Paste, Things 3 y Ulysses, mientras que Big Walk, Blue Prince y Crimson Desert compiten por el título de mejor juego para Mac. Los finalistas de Apple Arcade son Perchang World, PowerWash Simulator y Pusheen's Place. En Apple Watch, Bevel convierte los datos de entrenamiento en información útil, Moonlitt sigue los eventos lunares y StressWatch muestra en tiempo real el nivel de estrés. Los nominados para Apple TV son Case Solved: The London Files, Letterboxd y Pocket Casts.En computación espacial, los finalistas entre las aplicaciones para Apple Vision Pro son Adobe Premiere, donde el vídeo se edita en un amplio lienzo espacial, MLB, que retransmite béisbol con vista desde detrás del «home», y Museas, que convierte el salón en una galería de arte. Entre los juegos para Vision Pro, los finalistas son Cueva de las Manos, con rompecabezas de luz y sombra, Ping Pong Club, dedicado al tenis de mesa, y Spatial Ops, donde los tiroteos en primera persona se desarrollan en la propia casa del jugador.La categoría más grande es «Impacto cultural». Sus aplicaciones son Brilliant para aprender matemáticas y ciencias, chilli para la acción política en defensa del clima, Hearing Buddy para personas sordas o con dificultades auditivas, Karrot para la economía circular entre vecinos, setlog para unas redes sociales más auténticas y Unedo, donde se aprende español a través de la cultura. Sus juegos son and Roger, Consume Me, sobre los trastornos de la conducta alimentaria, PancitoMerge, que celebra la gastronomía mexicana, Sago Mini Jinja's Garden para jugar en familia, Spilled!, sobre la limpieza de aguas contaminadas, y la acogedora Tiny Bookshop.
- Public
- 18 Nov, 2026
Playtest de tu primer juego: un ciclo de trabajo para creadores en solitario y para quienes hacen juegos con IA
Un playtest es sencillo: alguien que no hizo el juego lo juega, el creador observa y después modifica el juego según lo que ha visto. No hacen falta equipo, presupuesto ni conocimientos de programación. Hacen falta una versión jugable, una o dos preguntas claras y unas cuantas personas ajenas al proyecto. Se puede trabajar así tanto en el desarrollo tradicional como con un creador de juegos con IA como Unity Spark.Las pruebas tienen dos objetivos distintos. El primero es técnico: que nada se congele, que los botones respondan, que no haya tirones y que no se pueda caer fuera del mundo. Gran parte de esto se puede comprobar a solas. El segundo es humano: ¿entienden los jugadores qué hacer y se siente el juego como se pretendía? Aquí hacen falta personas ajenas, porque el creador nunca puede vivir el juego por primera vez y rellena los huecos sin darse cuenta. El momento también importa. Empieza en cuanto funcione la acción principal, aunque tenga arte provisional y no haya sonido. Si los jugadores van a saltar sobre todo, prueba los saltos; si van a emparejar fichas, prueba eso. Los comentarios sobre un núcleo confuso son baratos de aplicar al principio y caros cuando ya se han construido niveles, menús e historia a su alrededor.Antes de cada sesión, escriban una o dos preguntas que se puedan responder con solo observar. ¿Los jugadores darán con el salto sin pistas? ¿Irán hacia la salida como pretende el nivel? ¿El primer enemigo parecerá justo al primer intento? ¿El inicio crea la sensación buscada? ¿Se entiende si el jugador ganó o perdió? Las sesiones sin un objetivo suelen dar opiniones difusas. Construyan la versión de prueba en torno a esas preguntas: por lo general, de 15 a 30 minutos de juego, con solo lo que se está probando y con una acción principal que no se cierre sola. Una pantalla breve con el objetivo o unas pocas líneas de instrucciones evitan que los testers se atasquen antes de llegar a lo importante. Que funcione importa más que verse bien.Antes de invitar a nadie, intenten romper el juego ustedes mismos, jugando como tipos de jugador extremos. El cauteloso evita cualquier riesgo: si gana con facilidad, el desafío no funciona. El apostador lo juega todo a una sola estrategia: si siempre gana, hay que reequilibrar las demás opciones. El aleatorio actúa sin pensar: si así se puede superar un juego de habilidad, hay un defecto. El vagabundo ignora el objetivo durante un minuto para ver si el juego sigue teniendo sentido, y el que aporrea los botones pulsa todo a la vez para ver qué se bloquea. Un registro sencillo con la fecha, lo que se probó y lo que se observó ayudará más adelante a ver patrones.Los amigos y la familia sirven para empezar, pero a menudo son demasiado amables. Mezclen a quienes juegan con frecuencia y a quienes juegan poco, a personas con necesidades distintas, y a quienes han oído hablar del juego y a quienes no. En las primeras rondas, de tres a cinco testers suelen bastar para que salgan los problemas más comunes; es una guía orientativa, no una regla. Varias rondas pequeñas son mejor que una grande, y cada público distinto merece unos cuantos testers. Se puede conseguir más gente en foros y servidores de chat donde se esperan juegos en fase temprana: compartan una versión corta, indiquen qué opiniones necesitan, respondan y piensen en un pequeño agradecimiento, como un crédito en el juego. Las sesiones pueden ser en directo, por pantalla compartida o en persona, y entonces se ve cada momento de confusión. También pueden ser grabadas: así se llega a más gente de la que cabe en un solo calendario, pero hacen falta instrucciones claras y pedir permiso antes de compartir fragmentos. En cualquier caso, no ayuden: la confusión es el dato. Pidan a los testers que piensen en voz alta y luego hagan de tres a cinco preguntas abiertas y concretas, como «¿En qué momento se sintió perdido por primera vez?», en lugar de «¿Qué le pareció?» o de una puntuación del uno al cinco.Si un jugador tiene dificultades, es una opinión; si tres tropiezan de la misma manera, es un problema. Den el mayor peso a las observaciones que se repiten y dejen aparte los comentarios de gusto aislados, salvo que coincidan con su propia intuición. Los testers detectan bien los problemas, pero no siempre aciertan con las soluciones, así que sus sugerencias son pistas, no instrucciones. Tras cada cambio importante hace falta repetir la prueba: un arreglo puede trasladar el problema a otro lugar. Con una herramienta de IA el proceso es el mismo. Unity Spark funciona en el navegador, parte de instrucciones escritas, usa recursos creados por artistas de la Unity Asset Store, no requiere código y pronto entrará en beta cerrada. Las observaciones se convierten en cambios concretos, que se aplican uno a uno y se vuelven a probar.
- Public
- 18 Nov, 2026
Un anuncio de Crayola y Beekeeper's Naturals combina animación 2D al estilo de los dibujos infantiles hechos con crayones y productos en 3D
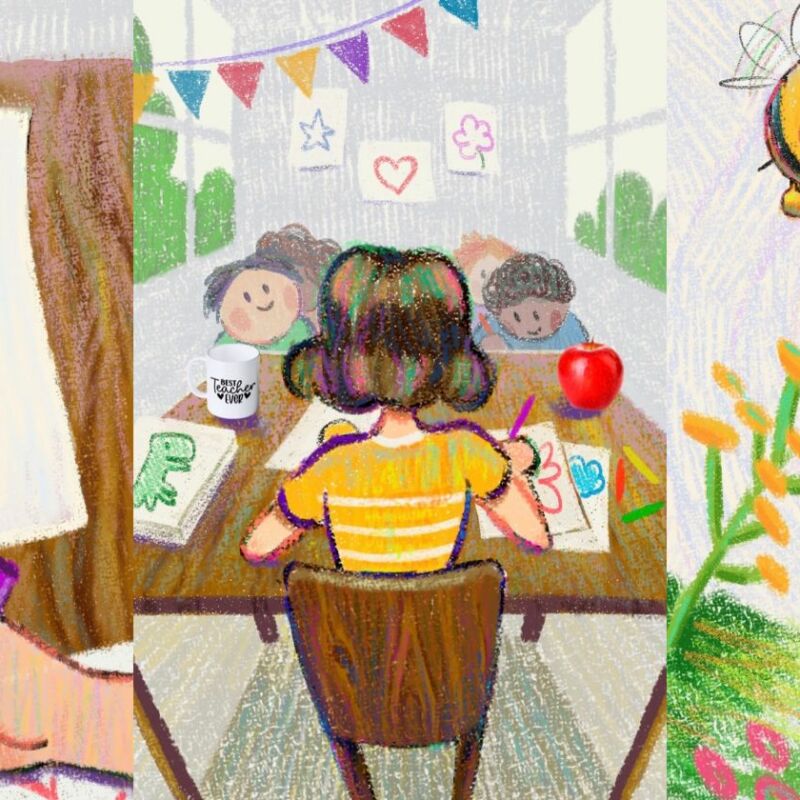
El anuncio de Beekeeper's Naturals y Crayola combina 2D y 3D para recrear el aspecto ingenuo y cálido de los dibujos infantiles hechos con crayones de cera. La campaña debía sentirse imaginativa, divertida y llena de color, como si hubiera salido directamente de la mano de un niño dibujando.Casi todo el trabajo en 2D lo hizo el animador de animación tradicional André Dias: animación, rigging, limpieza de líneas, diseño de personajes y composición. El storyboard lo dibujó Jean Carvalho, y los modelos 3D los crearon Nuno Leal y André Ruivo. El cliente dio al equipo total libertad creativa, y este eligió una dirección de arte con estilo de dibujo en crayón.El trabajo se desarrolló en tres programas. Las ilustraciones originales se hicieron en Krita, la animación preliminar se bocetó en Adobe Animate y la animación final se terminó en Moho. Los pinceles con textura de Moho y su herramienta nativa de «line boil» (temblor de líneas) dieron a los fotogramas un aspecto de dibujo hecho a mano, con una ligera vibración, sin necesidad de redibujar cada línea manualmente.Los lápices Crayola y las piruletas Beekeeper's Naturals se modelaron y renderizaron en 3D, y después se integraron en las escenas dibujadas. Esta combinación de 2D y 3D muestra cómo se entrelazan la imaginación y la realidad, el estado en el que vive constantemente la mente de un niño.
- Public
- 18 Nov, 2026
El método split-and-scale de Apple aumenta el nivel de detalle de los latentes 3D durante la inferencia sin necesidad de reentrenamiento
Investigadores de Apple especializados en aprendizaje automático han presentado split-and-scale, una técnica para aumentar la capacidad de las representaciones latentes 3D durante la inferencia, manteniendo el coste del entrenamiento en un nivel asumible. Las representaciones latentes ya codifican las escenas 3D de forma compacta y son la base de potentes modelos generativos 3D. Sin embargo, les cuesta conservar los detalles finos de los objetos complejos: en los latentes solo cabe una cantidad limitada de información.La solución más evidente tiene inconvenientes serios. Aumentar la capacidad de los latentes durante el entrenamiento encarece los cálculos y, a menudo, ni siquiera cabe en los límites de memoria. Añadir más latentes durante la inferencia tampoco sirve: el modelo no sabe aprovechar de forma eficaz la capacidad adicional.El método se apoya en una propiedad clave. Si una escena 3D se define como una función continua de coordenadas 3D, un mismo tokenizador preentrenado puede aplicarse en inferencia a subregiones de la escena arbitrariamente pequeñas. Cada subregión recibe la misma capacidad latente que tendría una escena completa, es decir, el mismo presupuesto se destina a una región más pequeña del espacio. Gracias a ello, el modelo capta muchos más detalles sin necesidad de reentrenarlo.El equipo realizó extensos experimentos de ablación para evaluar cómo se relacionan el cómputo, la memoria, la capacidad latente y la calidad de la reconstrucción. Los resultados muestran que este escalado en inferencia alcanza una calidad comparable a la de modelos mucho más grandes, que superan la memoria de una sola GPU. El enfoque también funciona para la generación: un generador 3D autorregresivo entrenado con representaciones split-and-scale rinde a la par de los modelos de referencia más avanzados. Todo indica que es una vía práctica para generar activos 3D más detallados con hardware modesto.
- Public
- 18 Nov, 2026
Impuestos y precios en la App Store: Botsuana, Ruanda, el nuevo atributo SaaS y el impuesto sobre las ventas en California
Apple está ajustando los impuestos y los precios en la App Store, que funciona con 175 tiendas y admite 43 monedas. Estos cambios se producen cuando se modifican las normas fiscales o los tipos de cambio. Para que los precios de las apps y de las compras dentro de la app (In-App Purchases) sean coherentes en todas las tiendas, Apple se basa en datos públicos sobre los tipos de cambio de fuentes como The Wall Street Journal o Bloomberg. Se modificará el anexo B del Paid Applications Agreement: ahora Apple cobra y abona directamente los impuestos correspondientes en Botsuana y Ruanda.Para las categorías fiscales App Store Software, Software Training Material, Dating y Boosting hay un nuevo atributo, «Software as a Service (SaaS)». Se puede revisar y modificar en App Store Connect, en la sección Pricing and Availability del menú Apps. A partir del 1 de enero de 2027, las apps de las categorías SaaS, App Store Software, Software Training Material, Dating y Boosting estarán sujetas en California al impuesto sobre las ventas y al impuesto sobre el uso. En la tienda de Estados Unidos los precios se indican sin impuestos, por lo que los precios mostrados y los ingresos de los desarrolladores no cambiarán, pero el importe total para el comprador puede aumentar.El 3 de diciembre de 2026, los precios de las apps y de las compras dentro de la app cambiarán en Botsuana, Colombia, Egipto, Ruanda y Türkiye, teniendo en cuenta el nuevo IVA. La excepción es que una de estas tiendas sea la tienda base: en ese caso, los precios en ella se mantendrán fijos, mientras que en el resto de las tiendas se actualizarán para seguir equiparados con el precio base elegido.Las suscripciones de renovación automática no se verán afectadas en ninguna región. Tampoco cambiarán los precios en las tiendas donde se gestionan manualmente. Los próximos cambios ya se pueden ver en App Store Connect, y los precios de las apps, de las compras dentro de la app y de las suscripciones se pueden modificar en cualquier momento.
- Public
- 17 Nov, 2026
Falling Leaves: un complemento gratuito para Blender que crea, dispersa y anima el follaje otoñal
Guillaume Bissieres ha lanzado Falling Leaves, un complemento gratuito para Blender con el que resulta cómodo montar escenas otoñales. Genera hojas caídas, las dispersa por la escena, las anima y añade viento. El complemento configura por sí solo la generación de las hojas y la física, y al usuario solo le queda ajustar la cantidad de hojas, su tamaño, la forma en que se balancean y otros parámetros.Las hojas predeterminadas se pueden sustituir por modelos propios o por imágenes con fondo transparente. A partir de esas imágenes, el complemento extrae por sí solo los contornos de las hojas y los convierte en mallas con mapeado UV y materiales. Para distribuir las hojas por el suelo hay tres configuraciones distintas basadas en Geometry Nodes. Además, la herramienta sabe crear grandes montones de hojas y generar viento a ras de suelo: en lugar de hacer girar las hojas en el aire, las empuja a lo largo de una superficie, por ejemplo una carretera. La intensidad del viento se puede ajustar a cualquier nivel, desde apenas perceptible hasta espectacular.La configuración de la simulación se puede guardar y reutilizar después para recrear el mismo efecto en otras escenas. Además, Falling Leaves está diseñado para funcionar junto con Leaf Gen, una herramienta independiente del mismo desarrollador para la creación procedural de hojas y la retopología.
- Public
- 17 Nov, 2026
Gafas inteligentes N50 de Apple: el hardware estaría ya cerrado y Siri será la puerta de entrada a las apps
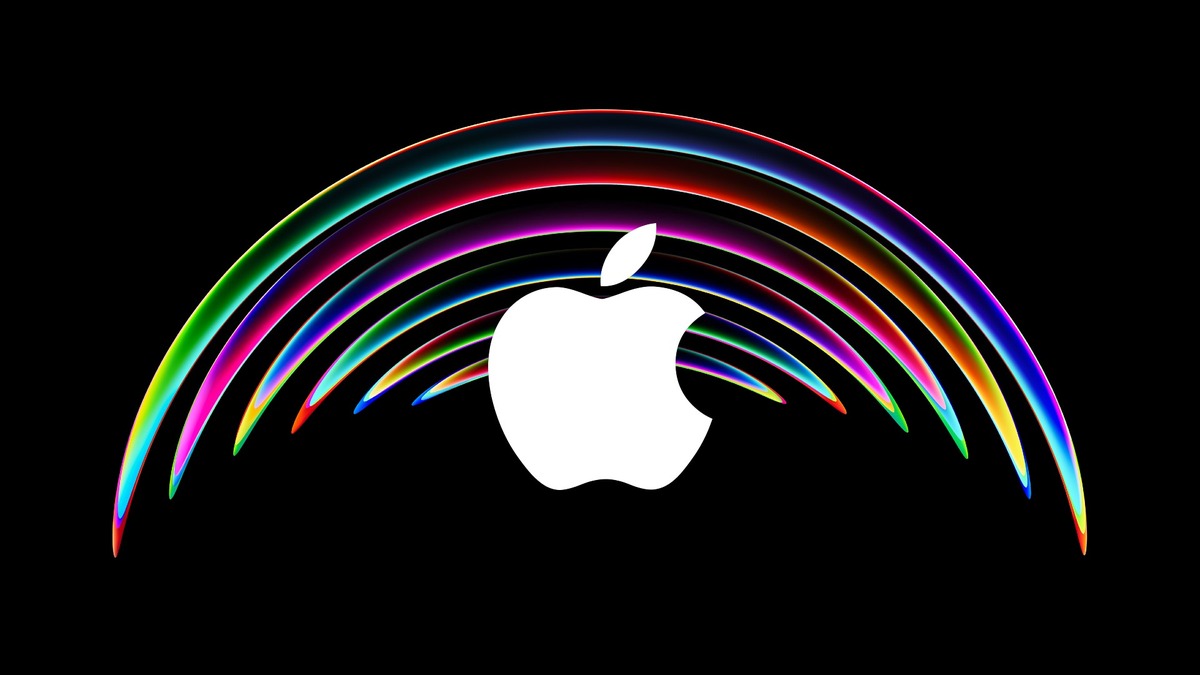
Se espera que las gafas inteligentes de Apple, con nombre en clave N50, debuten en la WWDC de junio del próximo año, y según los informes buena parte de su hardware ya está cerrada. Según un nuevo artículo de Bloomberg, Apple está construyendo el software del dispositivo en torno a Siri. El asistente de voz no será simplemente un ayudante integrado, sino el principal intermediario entre el usuario y las apps de terceros para el iPhone.La idea es poder reservar mesa en un restaurante, pedir un café, solicitar un taxi y comprar entradas por voz, y que Siri transmita esas peticiones a las apps que ya están instaladas en el teléfono. Al parecer, Apple quiere facilitar a los desarrolladores que den acceso a Siri a esas funciones de sus apps existentes para el iPhone. La compañía apuesta por el ecosistema actual de la App Store, y no por una nueva clase de software creado específicamente para gafas. Las propias apps de terceros no se ejecutarán directamente en las N50. Además, las gafas solo funcionarán con iPhone relativamente recientes y no serán compatibles con Android.Gafas Ray-Ban Meta | Cortesía de EssilorLuxottica, MetaEn cuanto al hardware, se dice que los prototipos son ligeramente más delgados que las gafas inteligentes Ray-Ban de segunda generación de Meta. Las cámaras están integradas al ras de la superficie, y junto a ellas hay indicadores de privacidad que avisan a quienes están alrededor de que se está grabando. Las gafas se cargan mediante un conector magnético propio. Funcionan con una versión "reducida" de visionOS 28 y, en su base, tienen un procesador propio de Apple derivado de los chips del Apple Watch. Esto concuerda con el compromiso que Apple declaró hace poco de seguir desarrollando visionOS: parece que el sistema va a salir del ámbito de los visores.La mayor presión de la competencia le llega a Apple en el terreno de la IA, donde Siri se queda claramente rezagada. Las gafas de Meta se apoyan en su IA Muse. Las próximas gafas con Android XR de Gentle Monster y Warby Parker funcionarán con Gemini de Google. Todas ellas son compatibles tanto con iOS como con Android. Aunque Meta se adelantó a los demás, la categoría en sí todavía es joven.Cortesía de Warby ParkerLas gafas actuales sin pantalla parecen un paso hacia un precio asequible para el consumidor masivo, más que la forma definitiva de la categoría. El objetivo a largo plazo, según todo indica, son unas gafas con pantalla y, con el tiempo, gafas de RA que se puedan llevar durante todo el día. Es probable que esas plataformas admitan un ecosistema de aplicaciones más diverso, lo que ayudaría a resolver el problema de la «aplicación estrella». Además, los propietarios de las plataformas obtendrían ingresos recurrentes, y no solo los de la venta del dispositivo en sí.
- Public
- 17 Nov, 2026
Organic Zombie Web: generador de redes orgánicas siniestras en Blender con Geometry Nodes
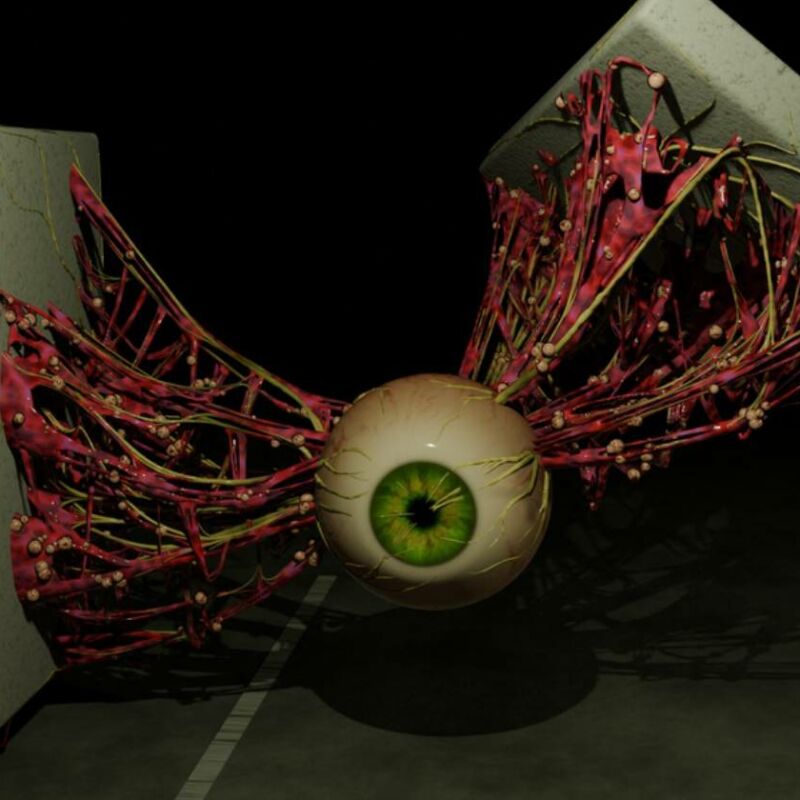
Organic Zombie Web es una nueva herramienta para Blender basada en Geometry Nodes. Crea telarañas gruesas y viscosas, similares a tejido vivo. Estas redes son ideales para entornos postapocalípticos y de terror, y se adaptan a casi cualquier superficie. El generador fue creado por Deepak Kushwaha, que suele trabajar en proyectos de ciencia ficción, como un portal funcional y un laboratorio ciberpunk. La herramienta se puede descargar libremente.Aquí no hay simulaciones: todo se basa en operaciones matemáticas. Por eso el generador es ligero y está pensado para funcionar en tiempo real. Incluye materiales propios, pero se pueden sustituir por otros personalizados para que la red encaje con el estilo del proyecto. Una vez terminado el resultado, se puede convertir en una malla normal.Por dentro, el generador se organiza en varias capas, y todas se construyen sobre tres componentes: Web, Surface y Subject. La primera capa conecta la superficie con el sujeto y tiende una red entre ambos. La segunda engancha nuevas redes a las ya existentes, y la estructura se vuelve más compleja y caótica. La tercera toma la superficie generada y construye sobre ella otra capa de red para añadir detalle. La forma y la distribución se controlan con curvas, Set Position, Sample Nearest Surface y otros nodos.Se pueden añadir venas a la red para que parezca viva, como atravesada por venas y arterias. Su color, su ruido y otras propiedades son ajustables. El sistema de instancias reparte detalles adicionales por la red. Puede ser un único objeto, por ejemplo esferas, formas ovoides o excrecencias parecidas a setas, o una colección completa con varias variantes. La distribución de las instancias también se puede ajustar.Entre los ajustes generales están el grosor, el ancho, la densidad, la aleatoriedad y la caída, así como lo bajo que cuelga la red y el ruido que deforma su forma. Juntos, estos parámetros ofrecen resultados muy variados: desde hilos dispersos y aislados hasta masas densas y desbordadas.
- Public
- 17 Nov, 2026
NVIDIA presenta Rubin HPC, una GPU para computación de alto rendimiento con más de 50 000 núcleos CUDA para simulaciones dirigidas por agentes
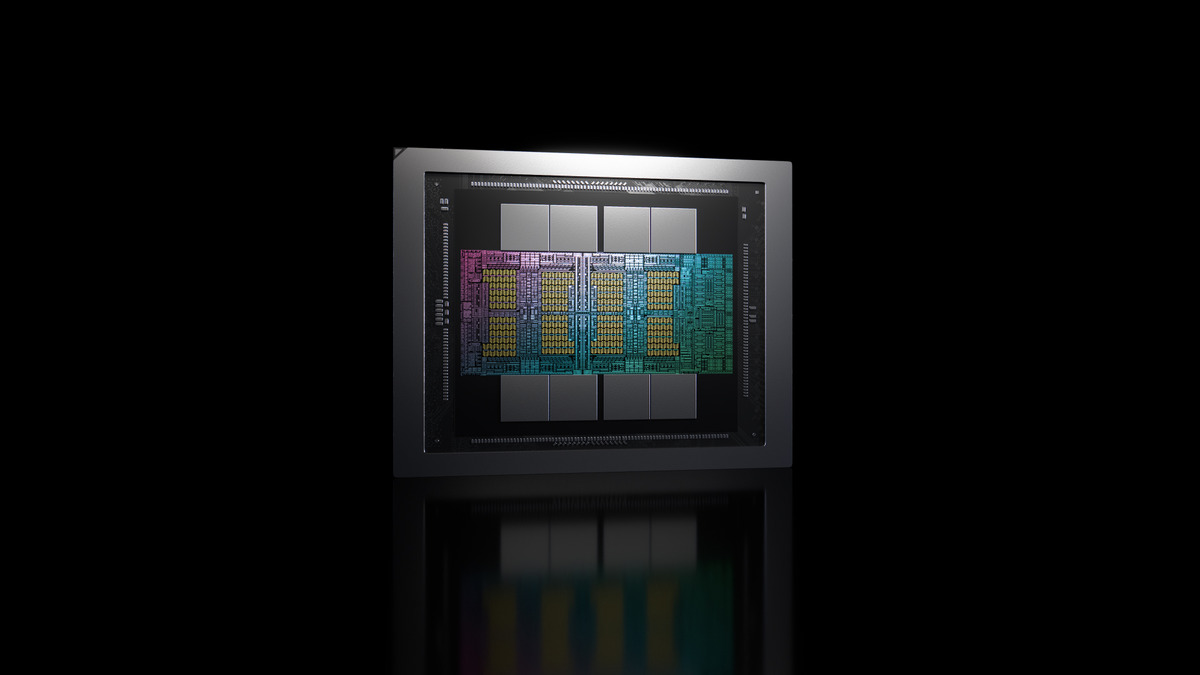
En la conferencia SC26, NVIDIA presentó Rubin HPC, una nueva GPU dentro de la plataforma Vera Rubin. Está pensada para simulaciones y procesamiento de datos en ciencia, ingeniería y analítica. El chip está diseñado para un enfoque cada vez más frecuente en la investigación y la industria: agentes de IA proponen opciones de materiales, moléculas y diseños, y después, mediante simulaciones, las evalúan y deciden qué probar a continuación. Cuantas más opciones hay, más simulaciones se necesitan, y Rubin HPC debe asumir esa carga.En cuanto al hardware, Rubin HPC marca un récord de núcleos CUDA: más de 50 000 en una sola GPU. Una nueva función de aceleración para datos dispersos sirve para que esos núcleos no se queden inactivos a la espera de datos, y NVLink de séptima generación acelera el intercambio entre GPU. En conjunto, la arquitectura está equilibrada: el ancho de banda para los datos crece junto con la potencia de cálculo, en lugar de limitarse a añadir cada vez más unidades aritméticas.Este equilibrio se adapta bien a las cargas de trabajo científicas habituales. Los modelos climáticos, las simulaciones de ingeniería, el análisis genómico y los cálculos de riesgo financiero suelen tener la misma estructura: el programa accede a un conjunto de datos enorme, extrae unos pocos valores dispersos, calcula un resultado y repite este proceso a una escala gigantesca. Si los núcleos reciben datos de forma constante, dedican su tiempo a calcular en lugar de esperar. Gracias a ello se aceleran las operaciones recurrentes, como las operaciones con matrices dispersas, los cálculos de tipo stencil, la ordenación y las reducciones.En cuanto al software, NVIDIA presenta las bibliotecas CUDA-X como un conjunto creciente de implementaciones optimizadas de algoritmos a las que pueden recurrir los agentes, incluidas las más relevantes para la simulación y el análisis de datos. Junto con Rubin HPC, están pensadas para acortar el ciclo de «hipótesis, simulación y refinamiento», de modo que los equipos puedan elegir antes los siguientes pasos y orientar el trabajo de laboratorio hacia los candidatos más prometedores. Ian Buck, vicepresidente de computación de hiperescala y de alto rendimiento de NVIDIA, lo resumió de forma sencilla: simulación más rápida significa descubrimientos más rápidos. Se espera que Rubin HPC esté disponible en 2028.