NVIDIA TensorRT 11.1: Global Performance Tuner para la optimización automática de motores con control de la precisión
 Public
- 24 Oct, 2026
El despliegue de redes neuronales es, en esencia, un problema de compilación en el que no existe una única estrategia óptima para todos los modelos. Cuando NVIDIA TensorRT construye un motor de inferencia, toma decisiones interdependientes sobre las transformaciones del grafo, la fusión de kernels, la ubicación de la memoria y la cuantización. Este proceso, conocido como planificación (scheduling), influye considerablemente en el rendimiento final de la inferencia. Distintas opciones de planificación pueden conservar la semántica del modelo y, sin embargo, dar resultados de velocidad muy diferentes. Como estos efectos están relacionados entre sí y dependen de cada modelo, a menudo solo se aprecian una vez construido y medido el motor completo. Esto hace cada vez más difícil predecir la mejor estrategia a medida que se diversifican los modelos y los entornos de despliegue.
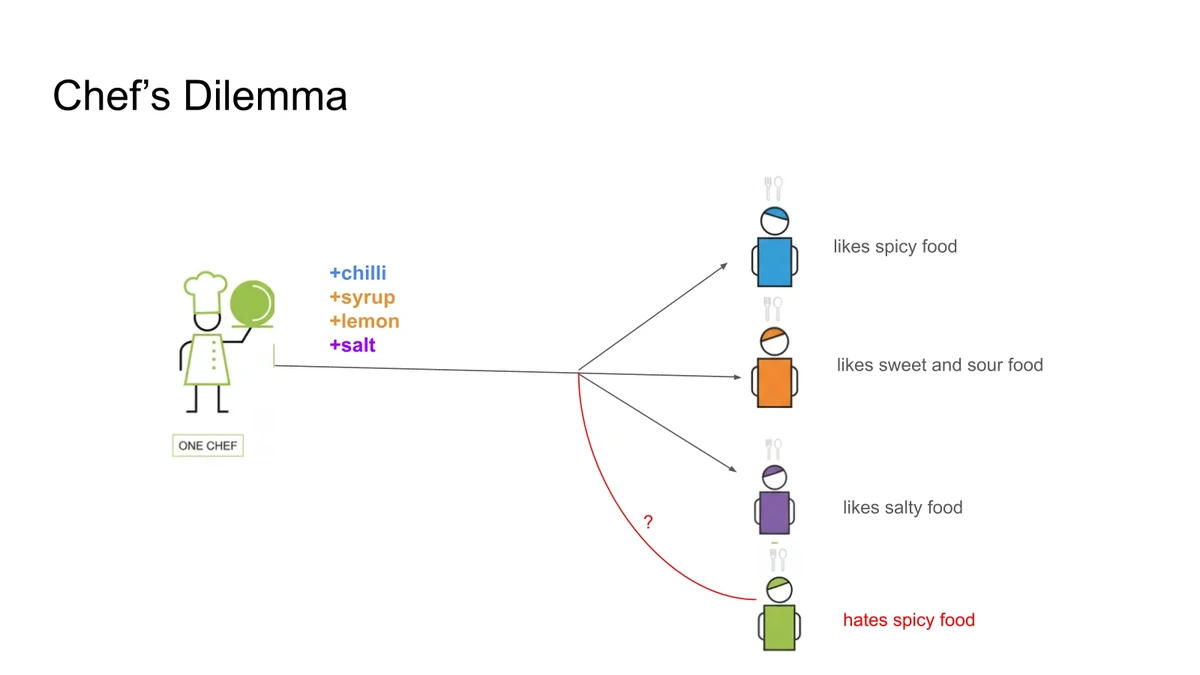
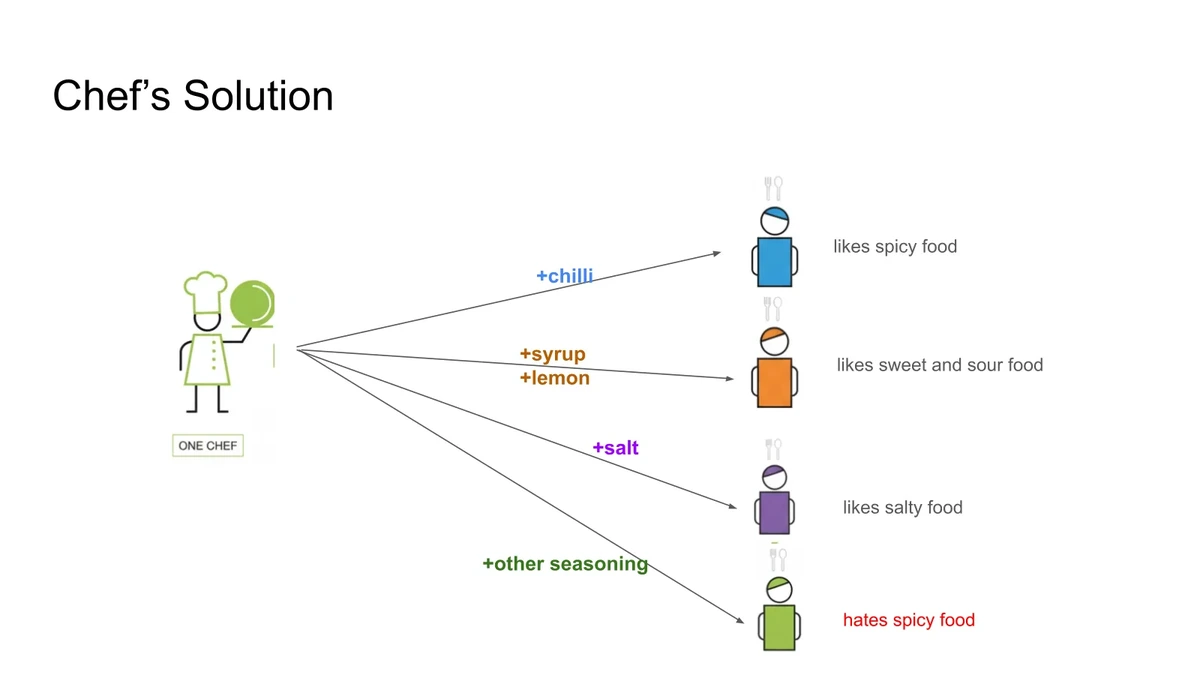
Históricamente, TensorRT se basaba en modelos internos de indicadores clave de rendimiento (KPI) para identificar patrones optimizables, que luego se codificaban como heurísticas en la estrategia de planificación predeterminada. Aunque esto permitía a los usuarios beneficiarse automáticamente del conocimiento experto, surgió un problema de escalabilidad. Una heurística diseñada para un tipo de modelo podía provocar una degradación del rendimiento en otro, lo que obligaba a añadir excepciones adicionales. Esto hacía que la lógica de planificación fuera compleja y difícil de ampliar. Global Performance Tuner, presentado en TensorRT 11.1, resuelve este problema al abandonar una única receta fija. En su lugar, trata el flujo del compilador como una receta base con «especias» configurables, lo que permite al sistema adaptar la ruta de optimización a las características específicas de cada modelo de entrada, ya sea un grafo ONNX o una red creada mediante la API de TensorRT.
Para formalizar este enfoque, el sistema utiliza un marco matemático que separa la generación de candidatos de su selección. El espacio de modelos está formado por todas las entradas posibles, mientras que el espacio de soluciones contiene todas las salidas ejecutables, como los motores de TensorRT o las secuencias serializadas de kernels de GPU. Un algoritmo de construcción (builder) asigna a cada modelo un conjunto de candidatos, limitado por un umbral de tolerancia de error. Este umbral garantiza que los pares entrada-salida se mantengan dentro de límites aceptables, evitando que optimizaciones agresivas incumplan los requisitos de la aplicación. El objetivo del algoritmo de construcción es generar un conjunto amplio de candidatos que incluya la solución óptima, definida como la ejecución factible más rápida que cumple los criterios de precisión. Esta abstracción permite analizar con rigor cómo influyen las distintas rutas de construcción en el tiempo de ejecución final.
A continuación, un algoritmo de búsqueda opera sobre este conjunto de candidatos para seleccionar la mejor solución. Idealmente, este algoritmo realizaría una evaluación exhaustiva de todos los candidatos para encontrar el de menor tiempo de ejecución. Sin embargo, en la práctica, los presupuestos de tiempo de construcción suelen limitar la profundidad de esta búsqueda. Por tanto, el compilador en su conjunto se representa como una tupla formada por un constructor (builder) y un buscador (searcher). La dificultad radica en crear un constructor óptimo que haga alcanzable la solución óptima global. Dado que no existe una única ruta de construcción universal que sirva para todos los modelos, el sistema debe admitir rutas de construcción personalizables. Esto significa que la secuencia de pasadas del compilador, que transforman las representaciones intermedias en ejecutables finales, puede variar. Distintos modelos pueden alcanzar su mejor rendimiento mediante secuencias de transformaciones diferentes, incluso en la misma GPU de destino.
Global Performance Tuner aprovecha estas rutas de compilación personalizables para realizar un ajuste automático del rendimiento. Para cada candidata generada por las distintas rutas, el tuner valida los resultados según el criterio de precisión especificado. Después mide el rendimiento de inferencia de extremo a extremo de las soluciones viables. Entre todas las candidatas que cumplen los requisitos de precisión, el sistema elige la que tiene el menor tiempo de ejecución. Este enfoque garantiza que las mejoras de rendimiento no se logren a costa de la fidelidad del modelo. Al tratar el proceso de compilación como una búsqueda entre múltiples rutas de compilación posibles, y no como un único camino fijo, TensorRT 11.1 ofrece un método escalable para optimizar cargas de trabajo de aprendizaje profundo en modelos y configuraciones de hardware diversos.
Esta metodología resuelve la limitación principal de los enfoques anteriores, en los que un cambio para un modelo podía degradar el rendimiento de otro. Al mantener estable el pipeline base y hacer configurables las decisiones de planificación, el sistema puede manejar con eficacia modelos nuevos con preferencias desconocidas. Ofrece distintas variantes de optimización, descarta las que no superan las comprobaciones de precisión y conserva la configuración con mejor rendimiento. Es análogo a un chef que ofrece muestras gratuitas a un cliente nuevo para encontrar la combinación de condimentos que prefiere, en lugar de imponerle una única receta estándar. El resultado es un proceso de compilación más robusto, que se adapta a las necesidades específicas de cada red neuronal y garantiza que los desarrolladores obtengan la mayor velocidad de inferencia posible sin comprometer la precisión que exigen sus aplicaciones.