Aceleración de la carga de datos en la GPU con NVIDIA KvikIO y GPUDirect Storage
 Public
- 22 Oct, 2026
NVIDIA Magnum IO GPUDirect Storage (GDS) resuelve el cuello de botella que supone mover grandes conjuntos de datos desde el almacenamiento hasta los aceleradores, al habilitar una ruta de datos directa que evita el almacenamiento intermedio en la memoria de la CPU. A medida que los modelos de IA y los conjuntos de datos de entrenamiento crecen de forma exponencial, el movimiento eficiente de los datos resulta fundamental para mantener las GPU abastecidas. Aunque la interfaz principal de GDS es la API de C cuFile, Python sigue siendo el lenguaje dominante en el desarrollo moderno de IA. NVIDIA KvikIO cierra esta brecha al ofrecer interfaces de alto nivel e idiomáticas en Python y C++ para la E/S de archivos de alto rendimiento. La biblioteca se sitúa por encima de cuFile y ofrece controles adicionales sobre cómo se ejecutan las solicitudes de E/S, lo que permite a los desarrolladores gestionar la ruta de datos sin tener que recurrir a código C de bajo nivel.
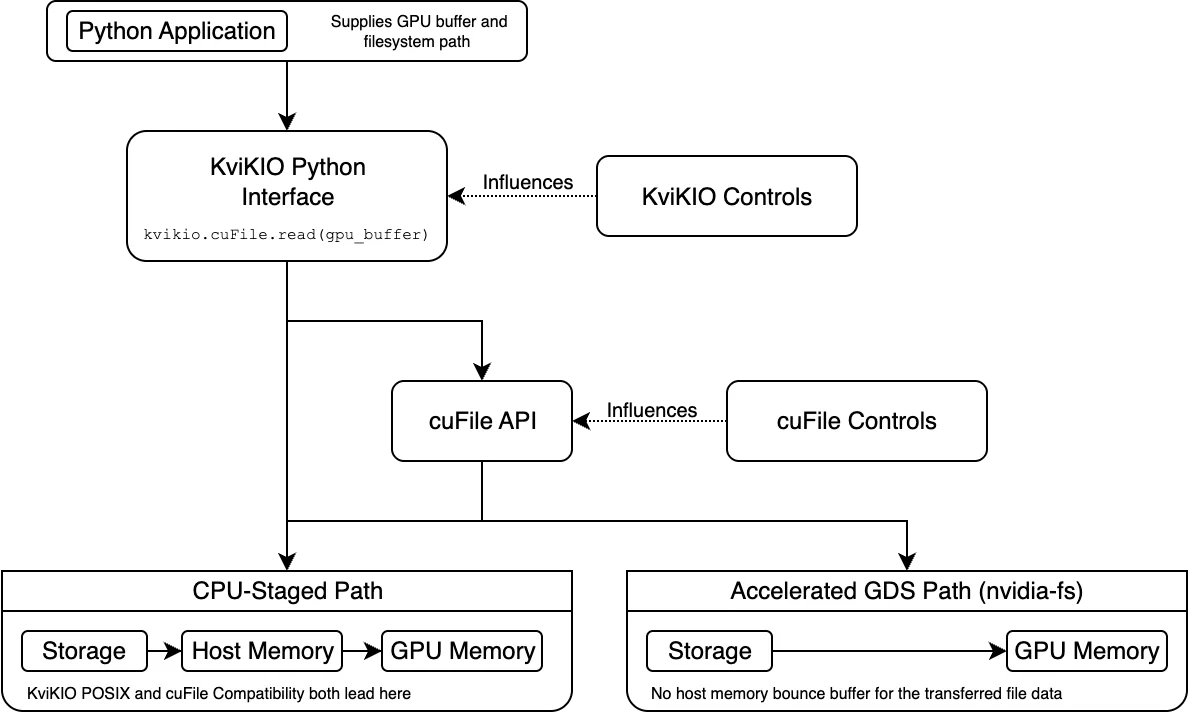
La arquitectura incluye dos puntos de decisión distintos para la selección de la ruta de transferencia de datos. En primer lugar, KvikIO determina si envía la solicitud a través de cuFile o utiliza su propia ruta de compatibilidad POSIX, que emplea la memoria del host como etapa intermedia. Esta elección depende del ajuste compat_mode, que puede tomar los valores AUTO, ON u OFF. En el modo AUTO, KvikIO intenta usar cuFile, pero recurre a POSIX si no está disponible. En segundo lugar, cuando cuFile recibe la solicitud, decide si utiliza la ruta acelerada GDS o su propia ruta de compatibilidad con almacenamiento intermedio en la CPU, según el soporte del sistema y la configuración. Por lo tanto, llegar a la API de cuFile solo confirma la selección de KvikIO, pero no garantiza que se haya usado la ruta acelerada GDS. Los desarrolladores deben verificar la ruta final para asegurar un rendimiento óptimo.
Para empezar, configure un entorno de Python e instale la compilación de KvikIO para CUDA 13 con el comando pip install kvikio-cu13, que incluye CuPy como dependencia. Antes de realizar operaciones de entrada y salida, revise la configuración activa con la API de valores predeterminados de KvikIO. Entre los ajustes clave están compat_mode, que indica el modo activo, y gds_threshold, el tamaño mínimo de solicitud que se envía a cuFile. En el sistema de prueba, el umbral es de 16 KiB, lo que significa que las lecturas más pequeñas se realizan directamente por la ruta POSIX de KvikIO. Estos ajustes se pueden controlar mediante variables de entorno como KVIKIO_COMPAT_MODE y KVIKIO_GDS_THRESHOLD. Además, el script gdscheck.py permite verificar los componentes de GDS instalados, los sistemas de archivos compatibles y la configuración activa de cuFile en la plataforma.
Para leer datos en la memoria de la GPU, asigne un array de CuPy del tamaño adecuado y use el gestor de contexto kvikio.CuFile para realizar la lectura. Por ejemplo, para leer un archivo de 1 GiB hay que crear un búfer de CuPy de 1 GiB y pasarlo al método read. Para verificar la ruta de transferencia de datos, active las estadísticas de ejecución de cuFile definiendo la variable de entorno CUFILE_STATS_LEVEL=3 y ejecutando el script en modo interactivo. A continuación, use gds_stats para inspeccionar los contadores. En la salida de cada GPU, nvfs cuenta las operaciones que usan el módulo del kernel nvidia-fs (ruta acelerada), mientras que posix cuenta las operaciones que usan la ruta de compatibilidad. Con la configuración predeterminada, una lectura de 1 GiB se divide en 256 operaciones de 4 MiB cada una, todas con nvfs=256 y posix=0, lo que confirma que se usó la ruta acelerada.
Es posible un control adicional modificando por separado los ajustes de KvikIO y de cuFile. Definir KVIKIO_COMPAT_MODE=off obliga a KvikIO a usar cuFile, mientras que CUFILE_FORCE_COMPAT_MODE=true obliga a cuFile a usar su ruta de compatibilidad, lo que hace que aparezcan contadores posix en las estadísticas. Por el contrario, KVIKIO_COMPAT_MODE=on omite cuFile por completo y utiliza el backend de KvikIO con almacenamiento intermedio en la CPU. Además de la selección de la ruta, los parámetros de ejecución de cufile.json controlan cómo se procesan las solicitudes. KvikIO divide las operaciones grandes en tareas según KVIKIO_TASK_SIZE, que luego se envían a cuFile. cuFile puede dividir aún más estas solicitudes según su grupo interno de hilos y min_io_threshold_size_kb. Por ejemplo, una solicitud de 1 GiB con un tamaño de tarea de 4 MiB genera 256 solicitudes independientes a cuFile, cada una de las cuales se procesa como una sola pieza.
Si KvikIO envía a cuFile una única solicitud grande (por ejemplo, de 1 GiB), cuFile puede dividirla en partes más pequeñas para su procesamiento en paralelo, limitado por el número de hilos de trabajo y por max_request_parallelism. En una configuración con cuatro hilos de trabajo, una solicitud de 1 GiB se divide en cuatro partes de 256 MiB. Dado que el búfer de destino no está registrado para DMA desde el almacenamiento, cuFile utiliza un búfer intermedio de GPU registrado y copia los datos en bloques de no más de 16 MiB. El parámetro min_io_threshold_size_kb influye en la planificación de las solicitudes; por ejemplo, una solicitud de 16 MiB puede dividirse en dos partes de 8 MiB para cumplir el umbral. KvikIO forma parte de las bibliotecas CUDA-X y se ha utilizado en cuDF, cuCIM y cuPhoton para acelerar la ingesta de datos en formatos Parquet, ORC e imágenes científicas. Comprender estas capas permite a los desarrolladores ajustar el rendimiento de la E/S para cargas de trabajo concretas.