Платформа NVIDIA Minerva AIOps поєднує телеметрію ШІ-фабрик для максимізації ефективності GPU
 Public
- 26 Oct, 2026
ШІ-фабрики є одними з найскладніших операційних середовищ, коли-небудь створених, де сотні тисяч GPU, мережі NVIDIA Spectrum-X Ethernet, масштабовані мережі NVLink і розподілені планировщики працюють у безперервному синхронному режимі. Під час синхронного розподіленого навчання вся задача просувається з темпом найповільнішого рангу, що означає: один деградований GPU, інтерфейс або шлях комутатора можуть призвести до втрати корисного часу на багатьох здорових ресурсах. Збої, що знижують ефективність, часто бувають незначними: наприклад, GPU працює трохи гарячіше за сусідів, пристрій NVMe втрачає продуктивність під постійним навантаженням або комутатор генерує потоки кадрів паузи. Поокремо ці сигнали рідко перевищують статичні пороги, але в сукупності створюють відставання, збільшують час кроків і затримують контрольні точки, що призводить до значних виробничих втрат.
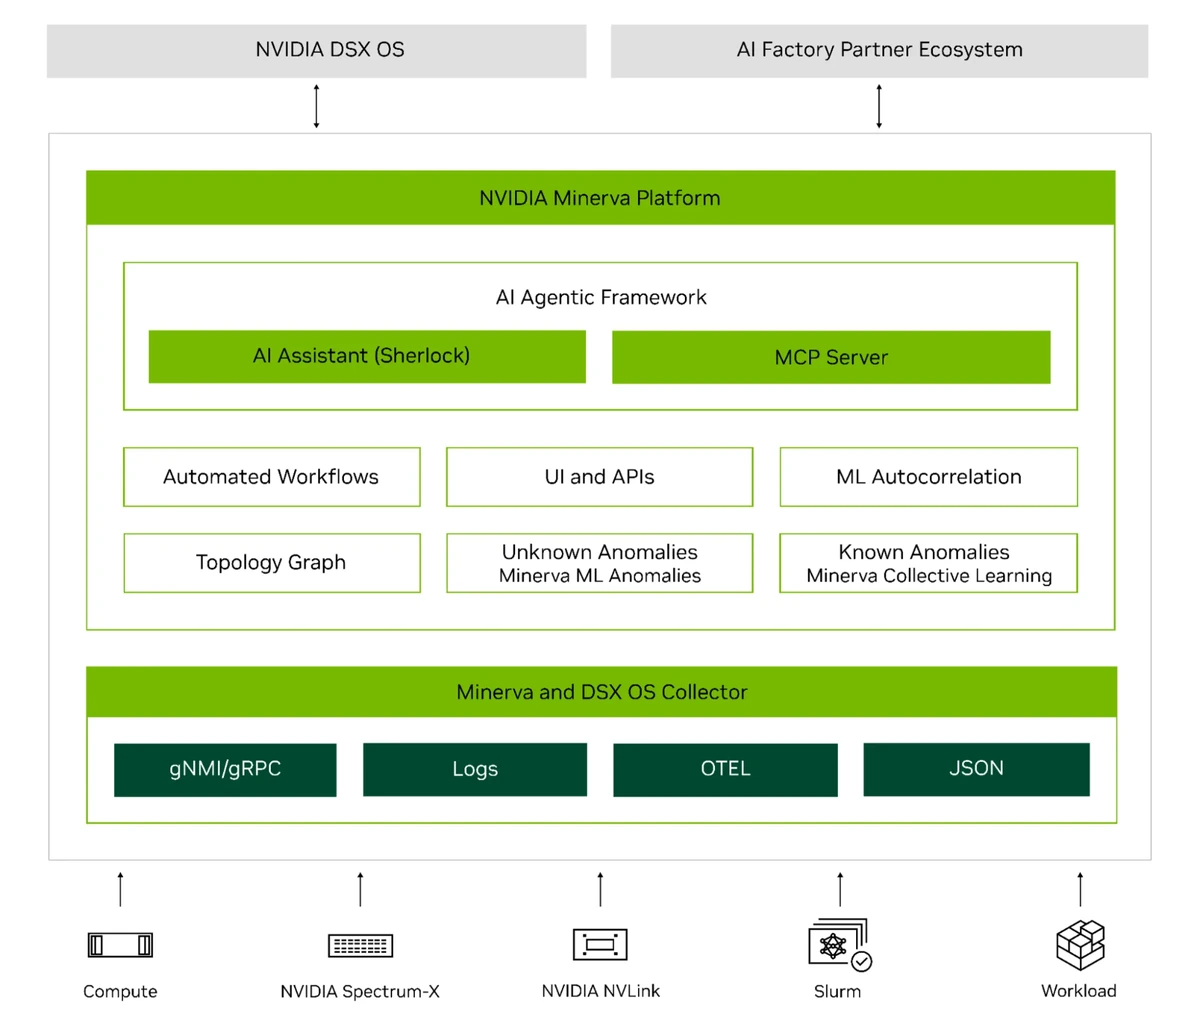
Діагностика ускладнюється тим, що докази розкидані по різних командах: оператори мережі бачать лічильники інтерфейсів, оператори обчислень - стан вузлів, а команди ML - зміну часу кроків. Ця фрагментація перетворює первинну діагностику на ланцюжок пошуку по дашбордах та передачі завдань між командами, потенційно перетворюючи локалізований збій на дні втраченого виробничого часу. NVIDIA Minerva закриває ці прогалини, збираючи телеметрію по всьому стеку та відображаючи інфраструктуру в активних завданнях у динамічному графі знань. Вона застосовує спеціально розроблене машинне навчання для кореляції залежних симптомів у інциденти високої точності. Асистент на базі ШІ-агента та MCP-сервер, підключений до зовнішніх агентних інструментів, забезпечують діалоговий шлях крізь ці живі дані, з основною метою збереження ефективних годин роботи GPU та забезпечення плавного ходу навчання моделей.
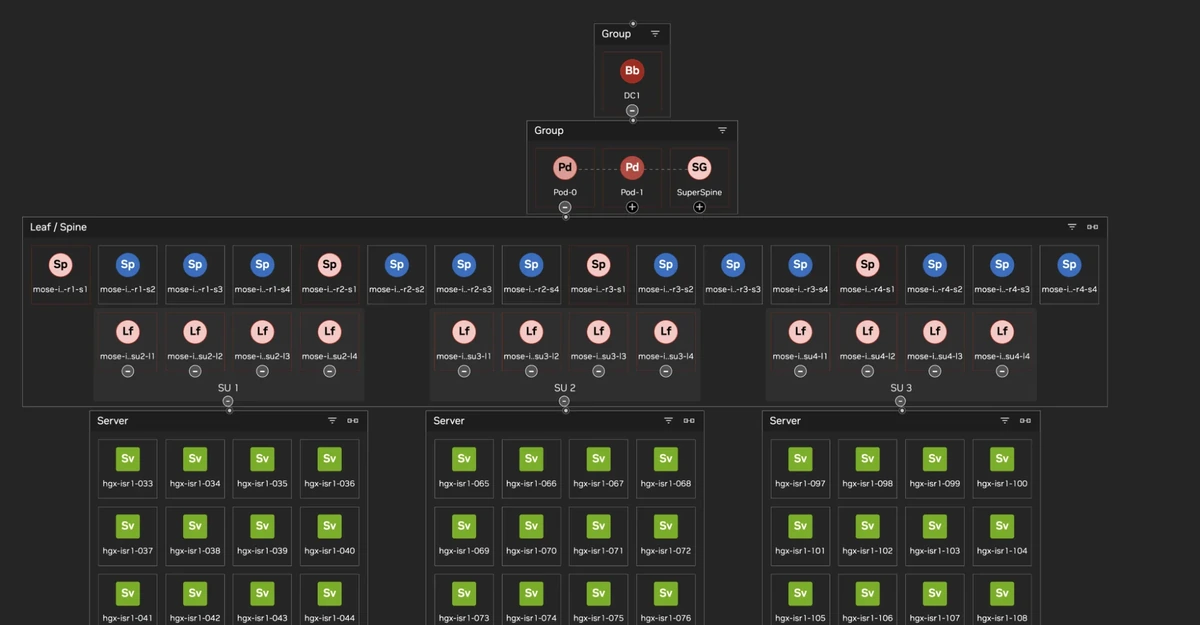
Моніторинг на основі правил погано справляється з «сірими збоями», коли компоненти залишаються доступними, але проявляють проблеми лише під навантаженням або в порівнянні з сусідами. Абсолютні пороги часто пропускають ці зміни, а агресивні пороги створюють шум при звичайних змінах навантаження. Масштаб посилює цю проблему, оскільки одна фізична несправність може породжувати помилки інтерфейсів, індикатори перевантаження та зміни використання GPU, які виглядають як незалежні події на різних дашбордах. Minerva приймає метрики, журнали та топологію з GPU, комутаторів Spectrum-X та NVLink, SuperNIC, DPU, сховищ, NCCL та планувальників. Автовиявлення надає зв'язки, яких немає в сирій телеметрії, створюючи граф знань, що відображає елементи інфраструктури, планувальника та робочих навантажень. Цей граф динамічно оновлюється по мірі запуску, зупинки завдань або заміни вузлів, підтримуючи навігацію від огляду всієї фабрики до окремого інтерфейсу.
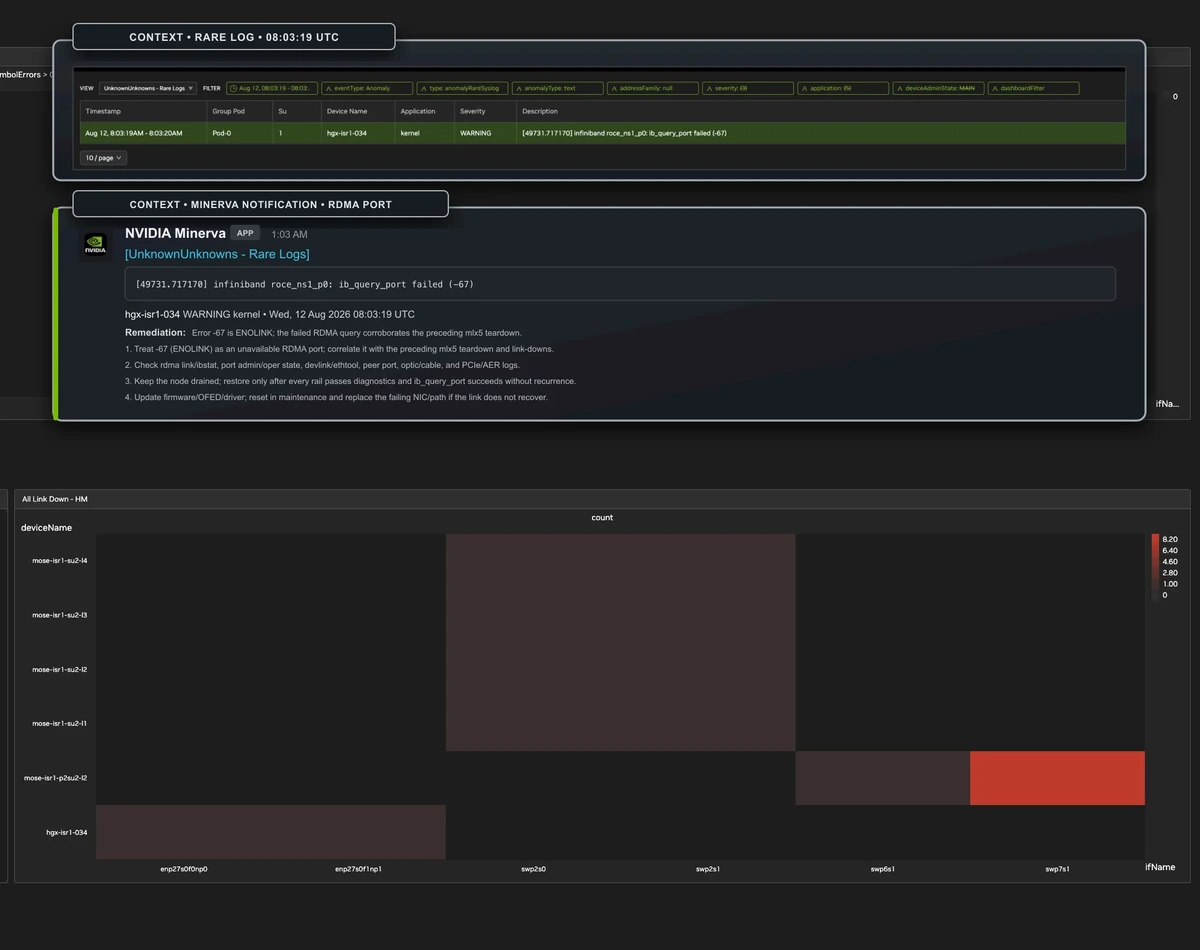
Граф топології трансформує шлях розслідування, дозволяючи операторам відстежувати аномалії від інтерфейсу до його вузла, шляху в мережі та поточного розміщення завдання. Навпаки, ML-інженери можуть прослідкувати ID завдання через дані на GPU, хості, NIC та комутаторі. Minerva обробляє мільярди точок даних метрик та журналів на годину, використовуючи моделі з навчанням з вчителем та без вчителя. Обнаруження з навчанням з вчителем ідентифікує відомі критичні шаблони помилок і пов'язує їх із рекомендаціями щодо усунення, тоді як моделі без вчителя вивчають нормальні шаблони для апаратних або логічних компонентів і порівнюють їх із відповідними сусідами. Порівняння з сусідами є критично важливим, оскільки вимірювання може виглядати прийнятним ізольовано, але бути аномальним у контексті, наприклад, температура GPU в межах специфікації, але значно вища, ніж у сусідніх GPU під тим самим навантаженням. Мультиваріантні моделі поєднують температуру, потужність, частоти та використання для виявлення деградації до повного відмови.
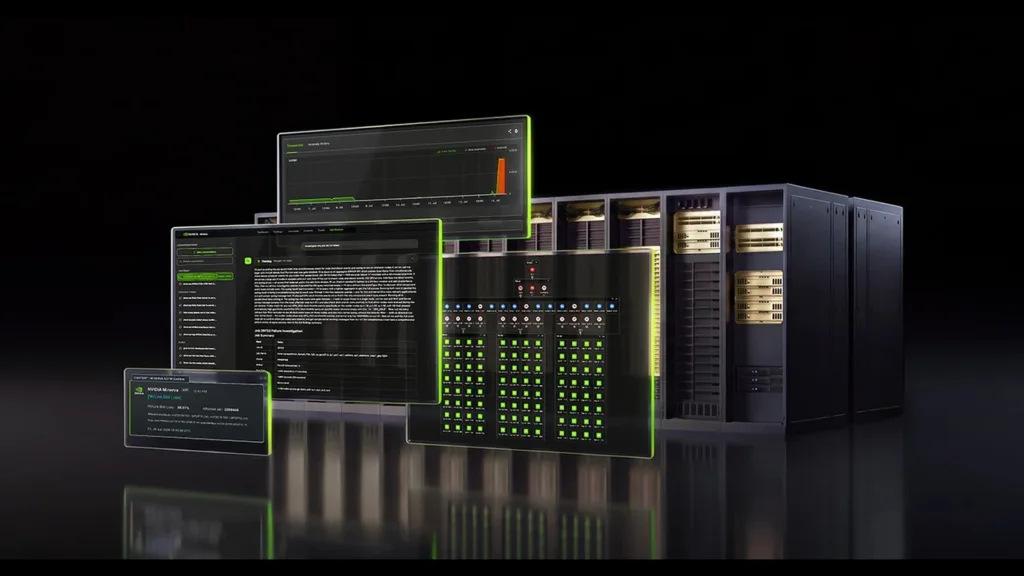
Журнали отримують аналогічну обробку: виявлення аномалій на основі NLP виявляє раніше невідомі шаблони, а збіг з навчанням з вчителем ідентифікує відомі критичні помилки. Виявлені проблеми можуть передаватися в робочі процеси планувальника для виведення зацікавлених вузлів з експлуатації до того, як на них потраплять нові завдання, або в безпечні інтервали контрольних точок. Кореляція з урахуванням топології пов'язує виявлення з діями оператора, використовуючи граф знань для визначення, які події мають спільний шлях залежності. Побічні симптоми групуються в єдиний інцидент, а не конкурують за увагу, зводячи надлишкові події та пов'язані серії метрик в один сигнал із прикріпленою зацікавленою топологією та робочими навантаженнями. Тестування NVIDIA показує значне зменшення кількості подій, що повідомляються, і тикетів для підтримуваних сценаріїв, що дозволяє операторам починати з набагато меншого простору пошуку для аналізу первинних причин.
NVIDIA Minerva включає нативного ШІ-агента на ім'я Sherlock, який базується на живій телеметрії та графі знань і дозволяє операторам запитувати систему для аналізу первинних причин природною мовою. Sherlock може надавати підтверджувальні докази та рекомендувати заходи щодо усунення, не вимагаючи від операторів знання конкретних метрик або мов запитів, надаючи шлях до галузевих знань, які традиційно вимагали ескалації до спеціалістів. Крім того, MCP-сервер Minerva дозволяє зовнішнім агентним інструментам запитувати той самий операційний контекст, що дозволяє командам інтегрувати живі дані ШІ-фабрики у власні робочі процеси. Заходи з пом'якшення можуть залишатися затвердженими людиною або автоматизуватися відповідно до локальної політики та оцінки ризиків. У великому ШІ-дата-центрі Minerva виявила одне з'єднання NVLink серед 400 000 інтерфейсів, яке втрачало пропускну здатність, що дозволило SRE вивести зацікавлені вузли з експлуатації та відновити повну швидкість за хвилини, а не години.