Блог
 Public
- 16 Nov, 2026
Lambda об'єднала понад 10 000 GPU за допомогою комутаторів NVIDIA Photonics з co-packaged optics
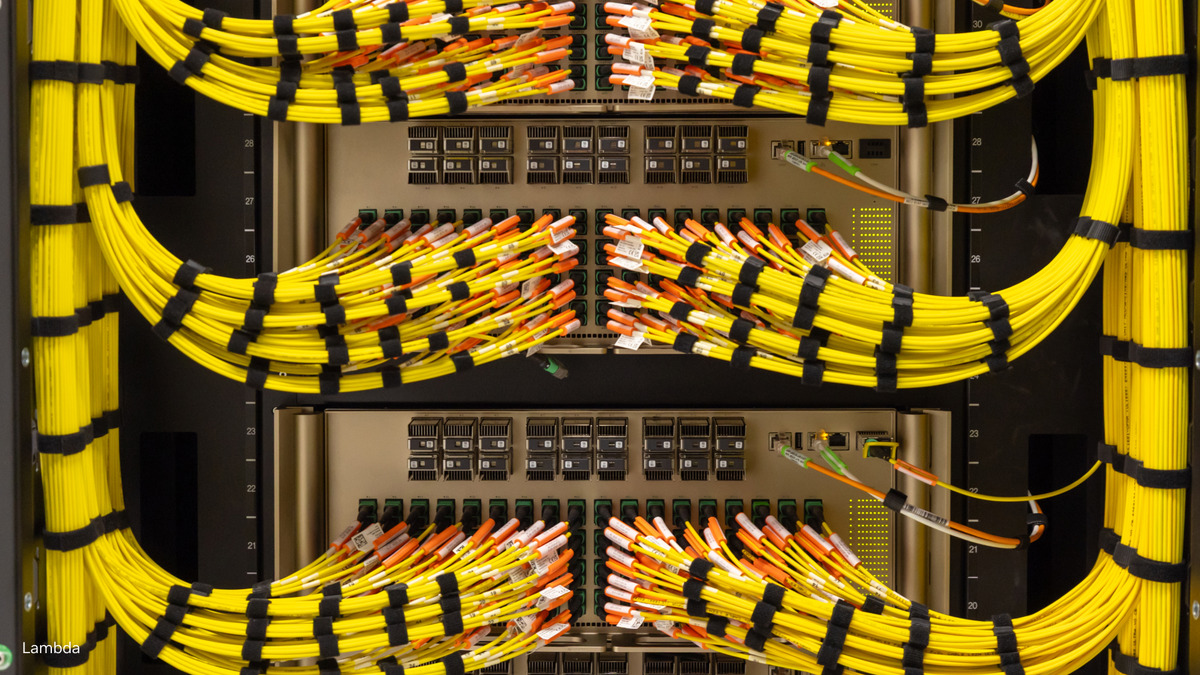
Lambda розгорнула комутатори NVIDIA Photonics з co-packaged optics (CPO) і з'єднала ними стійки NVIDIA GB300 NVL72, у яких загалом понад 10 000 GPU. Компанія прагнула отримати мережу для масштабного навчання та інференсу ШІ, яка споживає менше енергії, краще витримує збої та довше працює без переривань (вищий показник MTBI, mean time between interruptions), ніж звичні рішення.У тестах Lambda мережева затримка знизилася приблизно на 4% у масштабі стійки й майже на 10% у масштабі пода. Пропускна здатність залишилася на рівні звичайної підключуваної оптики в усіх конфігураціях: на рівні стійки, масштабованого блоку та пода. Мережа тут критично важлива: якщо у великому завданні з навчання відмовить хоча б одне з'єднання, простоювати можуть тисячі GPU, а в агентному інференсі один збій хвилею поширюється й уповільнює відповіді безлічі агентів. До того ж кожен ват, витрачений на мережу, забирається в обчислень.У цих комутаторах замість підключуваних трансиверів стоять оптичні рушії, розміщені безпосередньо в корпусі комутатора поруч із чипом. За даними NVIDIA, така конструкція до 5 разів енергоефективніша за підключувану оптику і до 15 разів надійніша: лазерів у ній учетверо менше, а отже, менше й деталей, які можуть вийти з ладу. Кожен комутатор в інсталяції Lambda дає 144 порти по 800 Гбіт/с, а тепло від чипа комутатора та оптичних рушіїв відводить рідинне охолодження. За вимірюваннями Lambda, медіанна температура оптики становила 36 °C проти 51 °C у підключуваних модулів, а цілісність сигналу виявилася стабільнішою.Світло надходить від 18 знімних зовнішніх джерел на кожен комутатор. Вони живлять оптичні рушії, які перетворюють електричні сигнали на світлові, а ті вже йдуть оптоволокном через увесь кластер. Такі модулі можна замінювати просто на місці, тоді як у разі відмови лазера в підключуваному модулі доводиться міняти його повністю. Крім того, за спільного пакування електричний шлях скорочується з дюймів до міліметрів: сигнал втрачається менше, а чипи-ретаймери стають непотрібними. Завдяки цьому знижується енергоспоживання і в тракті сигналу залишається менше компонентів.
- Public
- 16 Nov, 2026
Android XR отримала OpenXR Spatial Containers для застосунків на кількох рушіях
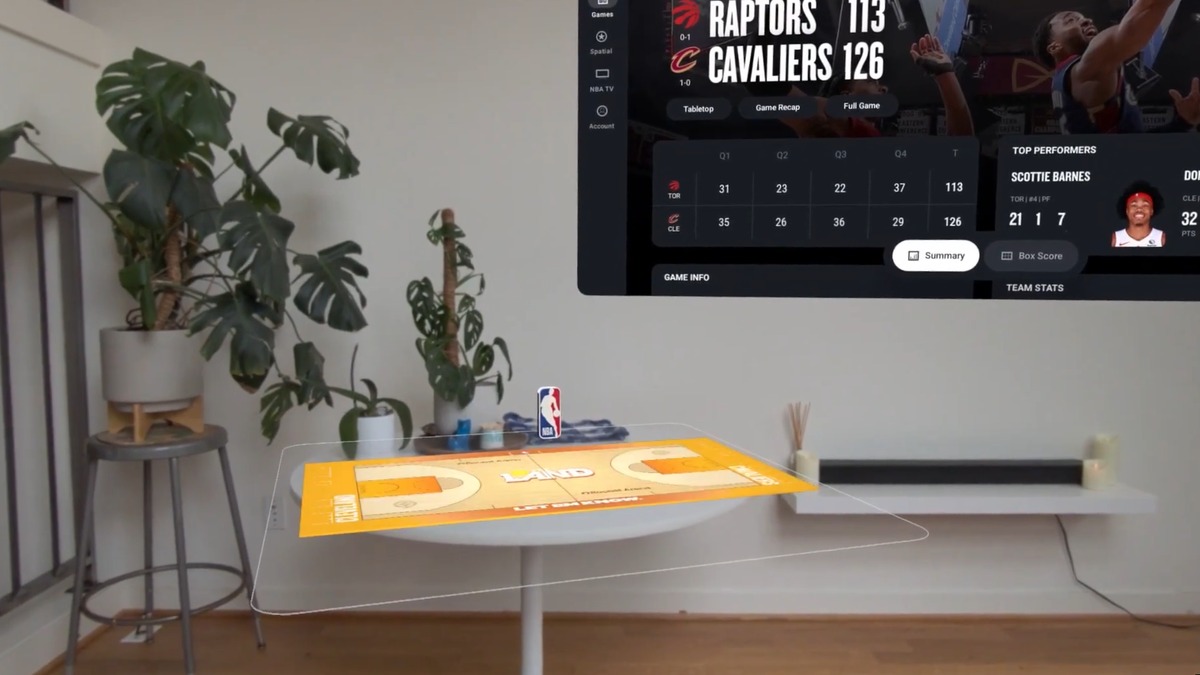
Android XR тепер підтримує нещодавно стандартизовані розширення OpenXR Spatial Container. Для їхньої роботи потрібен пристрій зі Spatial API Level 4 або вище, а застосунок має працювати в режимі Full Space. Розширення задають простори, якими керує система і в яких застосунок показує об'ємний 3D-контент. Це схоже на те, як настільна ОС розміщує 2D-контент у вікнах.Досі сесія OpenXR на Android XR забирала екран повністю. Spatial Containers дозволяють застосунку відмальовувати 3D-контент усередині обмеженого тривимірного об'єму або перемикатися в необмежений імерсивний режим, де він поводиться як звичайний OpenXR-застосунок. Елементами керування вікном і розташуванням кожного контейнера опікується система. Якщо контейнер у фокусі й доступний для взаємодії, користувач може безпосередньо працювати з його вмістом за допомогою відстеження рук, погляду або 6DoF-контролерів.Головна практична користь полягає в тому, що в одному застосунку тепер можна поєднувати різні технології. Інтерфейс на Jetpack Compose, звичайні 2D-активності Android і 3D-контент на OpenXR можуть працювати разом. 3D-частину можна рендерити рушіями на кшталт Unity або Godot чи написати безпосередньо на нативному OpenXR. Одним із перших це використовує застосунок NBA у функції Court View. Основний інтерфейс зроблено на Compose, а для окремих матчів показуються об'ємні 3D-майданчики, які рендерить Unity. Функція повторює Tabletop із застосунку NBA для Apple Vision Pro, яку також перейменували на Court View.На рівні стандарту Spatial Containers відкривають шлях застосункам, схожим на застосунки для visionOS. Там завдяки архітектурі Shared Space і RealityKit віконні та об'ємні застосунки працюють пліч-о-пліч і можуть переходити в повне занурення Full Space. Перша реалізація в Android XR скромніша. Контейнерам потрібен режим Full Space Managed, а не Home Space, де працює багатозадачність. Застосунок може показувати кілька власних контейнерів, але не поруч із контентом інших застосунків. Це узгоджується з тим, що Android XR дозволяє просторові компоненти лише у Full Space.Наразі ця функція радше дає змогу створювати застосунки на кількох рушіях, ніж забезпечує просторову багатозадачність між застосунками. Це збігається з тим, як Google описала її на I/O цього року, коли вперше показала ці можливості: як «застосунки на кількох рушіях» (multi-engine experiences). До повноцінної просторової багатозадачності, яку пропонують visionOS на Apple Vision Pro і Pico OS 6 на майбутньому Pico Space Pro, ще далеко.
- Public
- 16 Nov, 2026
CUDA виповнюється 20 років: від перших програм для GPU до 11 мільйонів розробників
На конференції із суперкомп'ютерів SC26 NVIDIA святкує 20-річчя CUDA та віддає належне дослідникам, розробникам та інженерам, завдяки яким обчислення на GPU стали фундаментом сучасної науки та ШІ. Платформу анонсували в листопаді 2006 року, а науковій спільноті представили на SC06. Вона дала розробникам звичну високорівневу модель програмування для GPU і вивела прискорені обчислення далеко за межі графіки: у моделювання та інші ресурсомісткі завдання.Через двадцять років на CUDA працюють понад 11 мільйонів розробників, причому на всіх рівнях обчислювального стеку. Платформа стоїть за дослідженнями в галузі ШІ, що отримали Нобелівську премію, за науковими застосунками на суперкомп'ютерах і за візуальними ефектами у фільмах, відзначених «Оскаром». Сьогодні до екосистеми входить понад 1000 бібліотек CUDA-X. Їх використовують у пошуку нових ліків, проєктуванні заводів, безпілотних автомобілях, моделюванні фінансових ринків і квантових обчисленнях.Однією з перших важливих віх стала робота команди біофізика Клауса Шультена з Іллінойського університету в Урбана-Шампейн. Створені нею інструменти Nanoscale Molecular Dynamics і Visual Molecular Dynamics поєднали обчислення на GPU з молекулярною біологією. У 2013 році дослідники з Іллінойсу, Піттсбурзького університету та Університету Вандербільта за допомогою інструментів, прискорених CUDA, встановили атомну структуру капсида ВІЛ. Для цього вони поєднали експерименти з моделюванням на Blue Waters, на той час одному з найпотужніших суперкомп'ютерів у світі.У галузі ШІ дослідники з Університету Торонто Алекс Крижевський, Ілля Суцкевер і Джеффрі Хінтон за допомогою CUDA навчили модель AlexNet лише на двох відеокартах NVIDIA. Ця модель розпізнавання зображень перемогла в конкурсі ImageNet 2012 року й показала, на що здатні GPU в глибокому навчанні. Згодом Деміс Хассабіс і Джон Джампер розділили Нобелівську премію з хімії 2024 року за передбачення структури білків за допомогою AlphaFold. Відкрито випущена їхньою командою програма AlphaFold 2 виконується на GPU через CUDA.Ці приклади показують, як робота одного покоління відкриває шлях наступному. Почати роботу з платформою, як і раніше, найпростіше з CUDA Toolkit. А на стенді NVIDIA на SC26 до ювілею встановили стіну 20-Year CUDA Celebration Event Wall.
- Public
- 16 Nov, 2026
Unity Fellowship надасть десятьом інді-студіям гранти по $50 000
Unity запустила Unity Fellowship - програму фінансової допомоги та підтримки для незалежних ігрових студій. До неї відберуть десять команд, чиї ігри вийдуть приблизно через рік, і нададуть їм доступ до ресурсів, підтримки та корисних зв'язків. Кожна команда отримає грант у $50 000. Частку в студії за нього віддавати не потрібно, повертати гроші теж. Студії самі вирішують, як і коли витрачати отримане, і повністю зберігають творчий контроль як над задумом гри, так і над бізнес-стратегією.Unity шукає незвичайні ігри з сильним творчим задумом. Претенденти мають надіслати відео з грою, ігрову збірку та план розробки, а також пояснити, як ресурси програми допоможуть просунути проєкт. Насамперед програма розрахована на команди без видавця, але студії, які вже мають видавця, теж можуть подати заявку. Усі матеріали в грі, зокрема створені за допомогою ШІ, мають належати заявникові, або він повинен мати права на них.Участь можуть брати не всі регіони. Unity не прийматиме заявки від розробників із країн і територій під санкціями США, а також із Бразилії, Італії та провінції Квебек. Програма призначена для інді-студій, які створюють ігри на Unity. Відібрані команди оголосять на GDC у березні 2027 року.
- Public
- 16 Nov, 2026
У FunFitLand на Meta Quest з'явилися мультиплеєрні тренування, до яких можна приєднатися будь-коли
У FunFitLand, фітнес-застосунку для VR на Meta Quest, з'явився мультиплеєрний режим. Він розв'язує одну з головних проблем домашніх VR-тренувань: людям бракує спілкування й тієї мотивації, яку дають спільні заняття у звичайному спортзалі. Мультиплеєр підтримують усі типи тренувань у застосунку: CombatFit (ритм-бокс), GrooveFit (танці), SwingFit (плавні рухи з битами), FlowFit (спокійні рухи в дусі дзен і тайцзи) та Space - набір медитативних віртуальних просторів, де тренуватися взагалі не потрібно. У Space компанія може просто посидіти й поспілкуватися, наприклад під час заминки. Це відповідає задуму авторів: застосунок має бути не лише фітнес-програмою, а й місцем, куди приходять по гарне самопочуття.Багатокористувацький режим FunFitLand. Фото: FunFitLandЗаразом розробники розв'язали проблему порожнього лобі. В інших фітнес-застосунках для VR групове тренування починається лише тоді, коли збереться вся група. У FunFitLand можна відкрити кімнату самостійно й одразу почати займатися, а ще до трьох людей приєднаються під час сесії. Близько трьох тижнів команда витратила на одне технічне завдання: новачок має потрапляти саме в той момент, до якого дійшов господар кімнати, навіть якщо тривають останні п'ять секунд заминки. Кімнатам можна присвоювати мовні мітки: користувачі застосунку живуть по всьому світу, і так одразу видно, чи говорять учасники сесії твоєю мовою.Меню багатокористувацької гри. Фото зроблено автором.Вибір мови. Фото зроблено автором.У мультиплеєрі гравці мають вигляд милих мультяшних фігурок. Можна вибрати форму голови та «обличчя» з кількох варіантів і налаштувати кольорові акценти. Автори розраховують, що в людини буде кілька аватарів і вона змінюватиме їх під настрій. Крім того, аватар приховує зовнішність, тому дехто займається розкуто й не соромиться. В інших застосунках підхід інший: у FitXR використовуються аватари Meta, а в старій версії Supernatural користувачів зображали «розмиті» моделі тіла. Мультиплеєр нової Supernatural поки не показували. Зовнішній вигляд аватарів FunFitLand багато разів допрацьовували за відгуками внутрішньої команди та сторонніх бета-тестерів із Facebook-спільноти застосунку.Мішені летять кількома доріжками, і рухатися доводиться на всі 360º. Коли відкриваються бічні доріжки й ними починають надходити мішені, аватар партнера стає напівпрозорим, щоб вони не губилися з поля зору. Ця непомітна деталь теж з'явилася завдяки тестуванню та відгукам користувачів. З функцією «пропустити заминку» групові тренування легко проводити одне за одним. Студія називає мультиплеєр ключовою частиною свого плану - об'єднувати людей через вправи, усвідомлений рух і спілкування - та обіцяє нові функції. FunFitLand можна завантажити на Meta Quest безкоштовно. Підписка коштує $9.99 на місяць або $99.99 на рік.
- Public
- 15 Nov, 2026
Яким має бути готовий 3D-персонаж для гри: поради чотирьох художників із персонажів
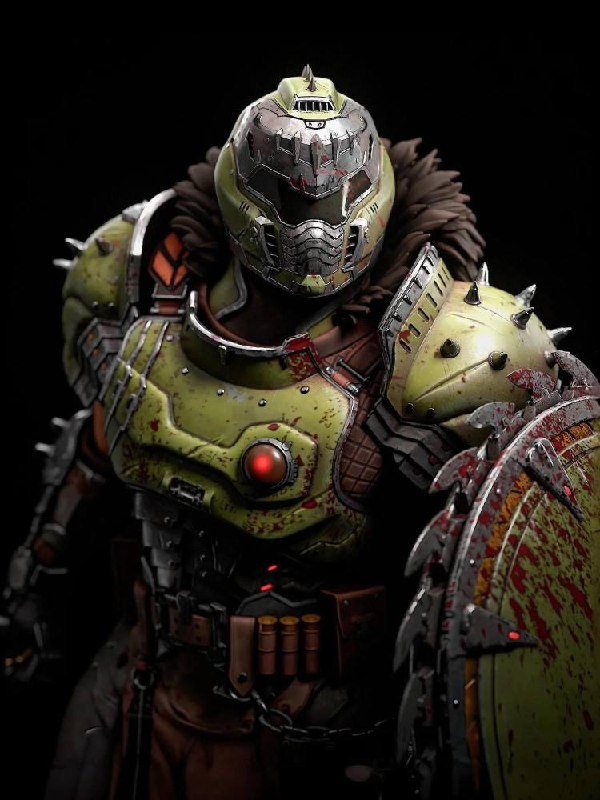
У центрі будь-якої гри стоїть герой, але більшу частину екрана займають другорядні персонажі: вороги, союзники, торговці, боси, вартові, істоти й масовка. Головному героєві можна дозволити важку геометрію та складні матеріали. З NPC так не вийде: тут доводиться шукати баланс між видовищністю, продуктивністю, єдністю стилю та швидкістю виробництва. Четверо художників, які продають готових до використання в іграх персонажів, RyanReos, Hisqie Furqoni, Andryuha1981 і KirTheGreat, розповідають, як вони цей баланс знаходять.Для них «готовий для гри» означає більше, ніж просто «низькополігональний». Колись Furqoni оцінював ассети за кількістю полігонів. Тепер він дивиться, чи впишеться модель у пайплайн: який у неї риг, як вона деформується, як влаштовані файли, чи сумісна вона з рушієм. KirTheGreat перелічує чисту топологію, оптимізовану геометрію, правильні UV-розгортки, PBR-текстури та підготовку до ригу й перенесення в рушій. RyanReos називає ідеалом принцип «підключив і працює». Його модульні фентезійні персонажі підготовлені для Unreal Engine 5 і постачаються у вигляді FBX-файлів із ригом, які без зусиль переносяться в Unity або Godot.Деталізація має залежати від ролі персонажа. Andryuha1981 зауважує, що героям і великим босам можна дозволити складну геометрію, адже одночасно на екрані їх небагато, а рядові вороги мають бути легшими: «Гра не складається з одного головного героя». Модульність допомагає отримати з одного набору більше персонажів. RyanReos тримає тіло, волосся, обладунки й одяг окремо. Andryuha комбінує вбрання, зачіски, зброю, матеріали та обличчя і так перетворює одного персонажа на кількох NPC. Furqoni зберігає цілісність своїх серій: у межах одного стилю він змінює роль, силует, зброю та обладунки. Назви й порядок у файлах він вважає «інтерфейсом і користувацьким досвідом 3D-продукту».Усі четверо попереджають: під час купівлі не варто вірити рекламній картинці. Kir радить перевіряти топологію, UV-розгортки, текстури, кількість полігонів, матеріали, риг, структуру файлів і сумісність із рушієм. RyanReos особливо звертає увагу на підтримувані версії рушія: через них ассети часто не працюють у проєкті покупця. Furqoni додає роздільну здатність текстур, тип ригу, формати файлів і те, що входить до комплекту, та попереджає, що через рекламні зображення, створені ШІ, перевірка стає ще важливішою. Andryuha радить прочитати опис повністю, вивчити скриншоти й переглянути відеопрев'ю. Усі сходяться в одному: хороший персонаж має пасувати і до світу гри, і до її пайплайну.
- Public
- 14 Nov, 2026
NVIDIA cuPhoton.xBeam переносить кореляцію даних інтерферометрії чорних дір на GPU
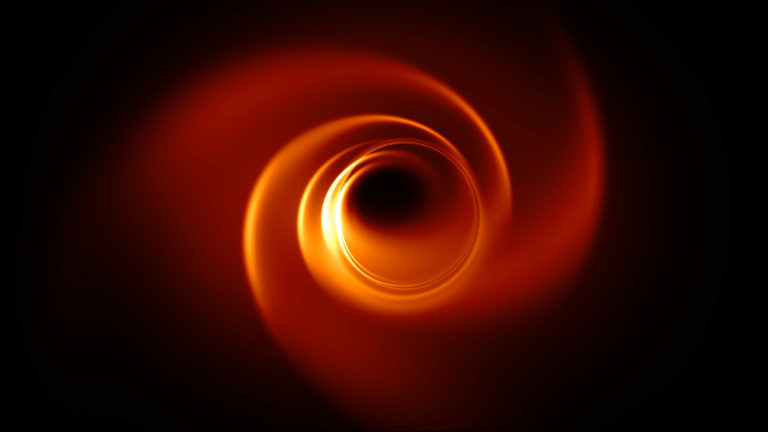
Щоб зняти чорну діру, потрібно розгледіти крихітний об'єкт: спостережуване кільце M87* займає лише 42 мікросекунди дуги. Телескоп горизонту подій (EHT) об'єднує 13 радіостанцій, зокрема на Гаваях, у Чилі, Іспанії, Мексиці та на Південному полюсі, методом інтерферометрії з наддовгими базами (VLBI). Кожна станція записує дві поляризації зі швидкістю до 64 Гбіт/с, і зрештою набираються петабайти даних про напругу. Кореляція пар телескопів дає видності. Це розріджені фур'є-вибірки яскравості неба вздовж треків, які прокреслює обертання Землі. За цими вибірками алгоритми реконструкції розв'язують обернену задачу. Зі змінними джерелами на кшталт Sgr A*, які змінюються просто під час сеансу спостережень, задача стає ще складнішою. В EHT наступного покоління (ngEHT) планують додати нові станції, щоб поліпшити якість зображень і відстежувати зміни в часі.Рисунок 2. Синтетичний приклад у дусі EHT, що показує вибірку просторових частот, амплітуди видностей, «брудне» зображення та модель у формі півмісяцяNVIDIA cuPhoton.xBeam - це FX-корелятор на GPU. Із сирих записів він отримує по одній комплексній видності на кожну пару станцій, частотний канал і короткий інтервал часу. Корелятор створено разом із Гарвард-Смітсонівським центром астрофізики та обсерваторією MIT Haystack. На системі NVIDIA Vera Rubin NVL72 він обробив набір даних обсягом 10 ТБ за 70 секунд. Для цього знадобилися 64 GPU і GPUDirect Storage у режимі сумісності. Це приблизно в 460 разів швидше, ніж на x86-процесорі: там знадобилося 31 992 секунди, тобто 8,89 години. Подальші калібрування та побудова зображень, наприклад тривимірні моделі газу на основі гаусового сплатингу, до cuPhoton не входять. Затримок за координатами станцій xBeam не обчислює і шляхів світла не трасує. Результати звіряються з відкритим CPU-корелятором DiFX, а на вихідні дані розраховані такі інструменти, як HOPS, rPICARD та eht-imaging.Рисунок 4. Прискорення cuPhoton.xBeam порівняно з базовим варіантом на процесорі x86 (ліворуч) і пропускна здатність завантаження даних (праворуч) за різної кількості GPU на NVIDIA Vera Rubin NVL72Конвеєр складається з п'яти етапів. На етапі приймання кожен кадр VDIF ставиться на своє місце в часі. Поруч створюється файл .vdix, який індексує кадри за міткою часу, потоком і фізичним розташуванням, не копіюючи самих даних. Пропущені та некоректні дані при цьому явно позначаються. На етапі корекції затримки та фази інтерференції дані до FFT вирівнюються з точністю до цілого відліку, і до них застосовується обертання фази інтерференції. Залишкову дробову затримку компенсує частотно-залежна поправка фази.Затримка береться з файлу завдання. Вона складається з геометричного полінома навколо t0, зміщення та дрейфу годинника кожної станції і зміщення годинника для кожного діапазону. У межах одного FFT затримка може бути сталою, лінійною або параболічною: це задає параметр fringe_approximation_order (0, 1 або 2). На етапі розбиття на канали для кожної станції виконується FFT. На етапі перемноження з накопиченням спектр однієї станції множиться на комплексно-спряжений спектр іншої. Некоректні вхідні дані маскуються, а результат нормується за вагами експозиції. На виході отримуємо формат DiFX SWIN або xbeam-v1.Версія 0.1.3 приймає нормалізоване завдання в JSON (версія схеми 1) або підтримуваний файл DiFX .input. У ньому перелічено станції, годинники, частоти, потоки даних VDIF, бази та скани. Вихідний каталог має бути новим. Команда cuphoton xbeam inspect-vdif RECORDING.vdif --json читає лише заголовки. Команда build-vdif-sidecar з параметрами --index-dir, --backend cufile (або posix, якщо GPUDirect Storage немає) і --devices створює індекси для повторного використання, а вихідні файли не змінюються. Команда cuphoton xbeam correlate JOB.json з --backend cupy запускає кореляцію на GPU. За замовчуванням дані зчитуються через POSIX у закріплену пам'ять хоста, а з --vdif-io cufile - через GPUDirect Storage. Серед параметрів є --scan, --first-integration і --integration-count. З Python можна викликати load_job і correlate з CorrelationWindow і отримувати записи по одному, але запис у SWIN доступний лише з CLI.Для записів із пропусками є профіль --profile interop-real-usb-buffered-window-replay-v1. З ним відліки всередині збереженого буфера продовжують зчитуватися з попередньою прив'язкою за часом, доки не з'явиться нова опорна точка. Профіль також визначає, які блоки FFT враховуються і як відображаються ваги. Втрачені відліки він не відновлює, і повна вага не гарантує повноти даних. Без профілю кадри вирівнюються за мітками часу в заголовках, а порожні слоти позначаються як некоректні, тому видності та ваги можуть відрізнятися. Під час масштабування скан ділиться за часом. На одному вузлі --devices 0,1,2,3 запускає по процесу на кожен GPU, записує результати в RUN/shards/ і об'єднує їх. На кількох вузлах кожен процес отримує --shard-count і --shard-index, наприклад 64 та індекси 0-63, з однаковими налаштуваннями сканів та інтеграцій. Потім merge-shards об'єднує часткові результати SWIN в одне ціле.Рисунок 1. Радіотелескопи реєструють сигнали, які корелюються у видності для реконструкції зображення. Концептуальна ілюстраціяРисунок 3. cuPhoton.xBeam перетворює записи телескопів на видності для подальшої побудови зображень
- Public
- 14 Nov, 2026
Курс зі створення game-ready гвинтівки Lee-Enfield: увесь пайплайн у Blender, Substance і Marmoset
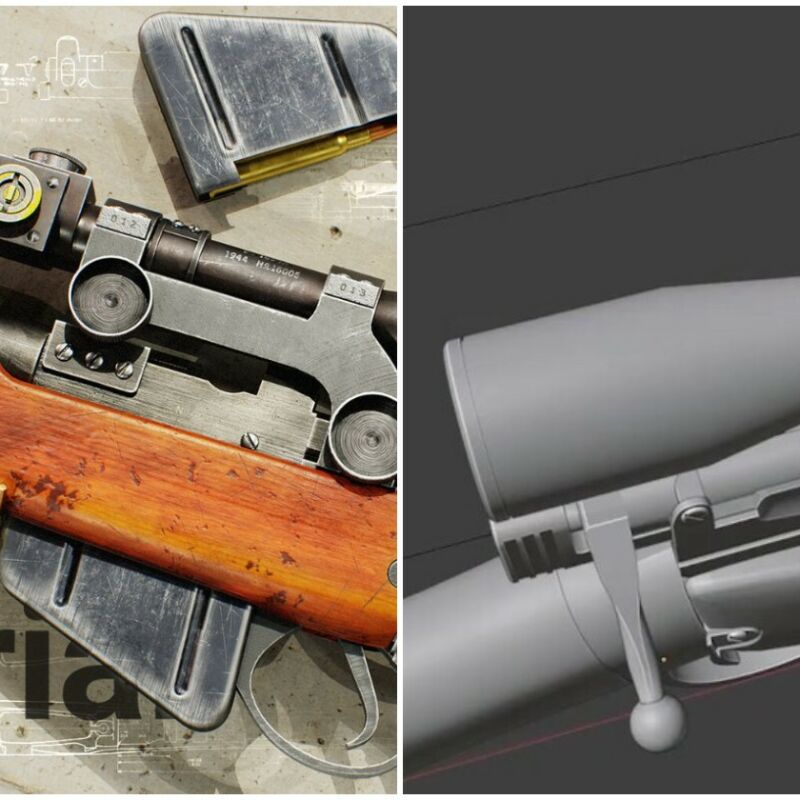
Titanium Studio випустила курс Mastering LEE-ENFIELD NO4 MK1 Game Ready Creation in Blender. Він орієнтований на реальне виробництво, а відео в ньому понад 26 годин. Веде курс Навід Валізаде, старший художник зі зброї та пропсів, який спеціалізується на фотореалістичних асетах. Навчальний проєкт - снайперська гвинтівка в дусі Другої світової: її створюють з нуля і доводять до відшліфованого фінального рендера.Модель будують у Blender за допомогою професійних прийомів хард-серфейс моделювання. Основну увагу приділяють чистій геометрії, опрацюванню деталей і вибудуваному робочому процесу. Потім асет переносять у Substance 3D Painter і текстурують: студенти створюють реалістичні матеріали, додають неоднорідність поверхні, налаштовують шорсткість, наносять зношення та дрібні деталі. Курс навчає всього процесу створення асета повністю, а не лише того, як працювати з окремими інструментами.На останньому етапі гвинтівку готують до показу в Marmoset Toolbag 5. Тут розбирають професійне освітлення, налаштування матеріалів, композицію кадру та прийоми, які допомагають ефектно представити готову зброю. Усі три етапи разом відтворюють типовий пайплайн створення game-ready пропсів, прийнятий у виробництві.
- Public
- 14 Nov, 2026
Meta-Optics Mirror від TDK і когерентне сканування Ліссажу: повернення лазерних AR-окулярів
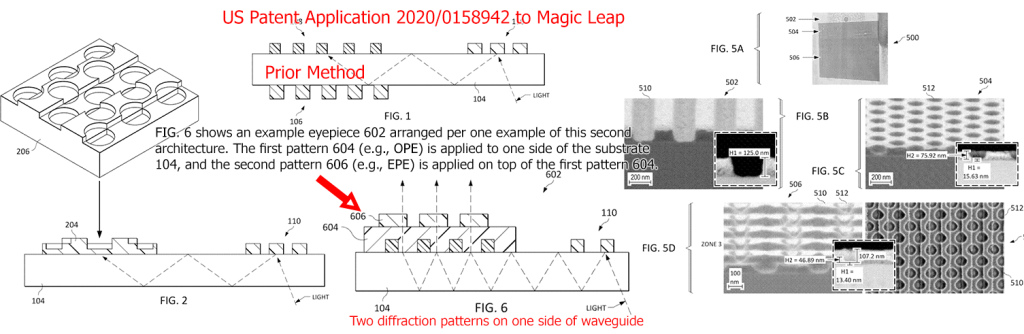
2 жовтня 2026 року TDK анонсувала Meta-Optics Mirror - «комбайнер у вільному просторі» (free-air combiner) нового типу для AR-окулярів. Анонсу передували дві угоди, укладені раніше того ж року. У травні 2026 року TDK придбала основні активи, інтелектуальну власність і команду Oqmented. Ця компанія виготовляла MEMS-дзеркала у вакуумних корпусах для лазерного сканування променем (LBS) за фігурами Ліссажу. У червні 2026 року TDK підписала угоду про ділову співпрацю з виробником лазерів QD Laser: компанії разом розроблятимуть оптичні рушії з проєкцією на сітківку для розумних окулярів. Співпрацюють вони щонайменше з 2020 року. QD Laser виокремилася з Fujitsu і демонструє пряме сканування сітківки за технологією LBS щонайменше з 2016 року.Угода змінює курс TDK. Oqmented займалася LBS на основі хвилеводів. У такій схемі хвилевід розширює зіницю, і на виході зображення поводиться радше як у плаского дисплея: світло перестає бути «максвеллівським», тобто таким, що не потребує фокусування. Дзеркало TDK, навпаки, розраховане на пряму проєкцію на сітківку - цим шляхом раніше йшли Microvision, Bosch, North Focals, Intel Vaunt та Eyeway Vision. Хвилеводи дають значно більшу зону огляду й позбавляють недоліків відкритого лазерного шляху від проєктора в дужці до ока. Коли промінь іде повітрям, порошинка на поверхні або одна волосина на його шляху можуть кинути на частину зображення велику різку тінь, а в користувачів з'являються побоювання щодо безпеки для очей. На сайті TDK хвилеводний підхід досі зазначено, тож компанія, вочевидь, розвиває обидва напрями.Дзеркало спрямовує світло від сканера до ока за допомогою наноструктур розміром від 200 нм до 1 мкм. Звичайне дзеркало відбило б світло від проєктора в дужці під таким кутом, що воно пройшло б повз око. Структуру виготовляють за технологією, подібною до напівпровідникової, на тонкій підкладці. Її можна вбудувати у звичайну окулярну лінзу - імовірно, затиснувши між двома половинками лінзи, як сьогодні роблять із хвилеводами. У схемі TDK промінь проєктора йде майже паралельно оправі до другого дзеркала біля лінзи. Звідти він падає на нанорефлектор під дуже пологим кутом, тому шлях повітрям залишається коротким. Нинішня версія працює лише в зеленому кольорі, а розміри структур, найімовірніше, залежать від довжини хвилі, як і в дифракційних хвилеводах. TDK каже, що прискорює роботу над повнокольоровим демо, і розраховує на масове виробництво «протягом найближчих кількох років». «Метаоптика» тут означає пласку оптику із субхвильовими структурами і до компанії Meta стосунку не має. Утім, ґратки хвилеводів зі складними субструктурами, меншими за 100 нм, і так стирають межу між ґратками та метаповерхнями.На MicroLED and AR/VR/MR Connect 2026 TDK показала коротку робочу демонстрацію того, що Oqmented спочатку називала «прогресивним ліссажу-скануванням» (Progressive Lissajous Scanning). Тепер на сайті TDK це називається «когерентним» ліссажу-скануванням - той самий термін Meta використала на SPIE AR/VR/MR 2025, хоча TDK стверджує, що дійшла до ідеї самостійно. Під час ліссажу-сканування одне дзеркало керується двома синусоїдами, і промінь описує траєкторію, схожу на вісімку. Швидка вісь в Oqmented працює на 20-40 кГц. У растровому LBS усе інакше: вертикальна вісь там працює приблизно на 60-120 Гц, а горизонтальна - на 20-60 кГц. Під час ліссажу-сканування повільна вісь за швидкістю набагато ближча до швидкої, тому промінь іде сильно вигнутими діагональними траєкторіями. Традиційно пікселі записуються псевдовипадково, коли промінь через них проходить, а лазер модулюється з урахуванням і яскравості, і швидкості променя. У результаті під час саккад око бачить неповні кадри і сам малюнок сканування.Когерентний варіант зберігає той самий рух дзеркала, але малює пікселі в порядку проходу променя, складаючи їх у вигнуті сегменти, схожі на растр. Поки промінь повільно розвертається біля кожного краю траєкторії, лазер гаситься. Так розпад зображення під час саккад зникає, але фундаментальні обмеження залишаються. Прямокутну сітку пікселів доводиться перераховувати на вигнуті лінії сканування, які ніколи точно не потрапляють у піксель, і за базовою теорією Найквіста це коштує приблизно дворазової втрати ефективної роздільної здатності по кожній осі. Щоб більшість людей не помічала мерехтіння, кожна точка навіть у найгіршому випадку має оновлюватися частіше ніж приблизно 90 разів на секунду. За швидкої осі на 40 кГц після перерахунку виходить близько 300 ефективних рядків. Для порівняння: NTSC за рядкової частоти близько 15 кГц давав 720×480 із черезрядковою розгорткою на 60 Гц, причому без жодного перерахунку на вигнуту сітку. Історично системам LBS доводилося обирати між мерехтінням і роздільною здатністю.Показаний прототип Oqmented/TDK з низькою роздільною здатністю розпад зображення справді усунув, але мерехтіння все ж було помітне. Серед інших розробок комбайнерів - HOE-комбайнер, над яким працює CREAL. З'являються й радикальніші підходи, наприклад активні мінідзеркала Gixel і комбайнер на нелінійному кристалі від Smith Display.
- Public
- 13 Nov, 2026
Apple підтвердила, що не відмовляється від visionOS, на сесії для розробників просторових обчислень
Apple провела одноденну сесію для розробників «Meet with Apple», повністю присвячену visionOS, своїй платформі просторових обчислень, і скористалася нею, щоб відповісти на сумніви щодо своїх XR-планів, які накопичувалися місяцями. Юрі Імото, продакт-менеджер підрозділу Spatial Computing в Apple, заявив, що компанія «дуже серйозно налаштована щодо платформи», і зазначив, що просторові обчислення за короткий час зробили великий крок уперед. Ключовими напрямами для платформи на заході назвали хірургію, охорону здоров'я, освіту, навчання персоналу та імерсивне кіно.Однією з найпомітніших новинок став професійний амбісонічний мікрофон від Blackmagic. У ньому 108 мікрофонів і вбудований процесор, який сам перетворює сигнал у формат, придатний для просторового контенту Apple. Авторам імерсивного звуку більше не доведеться робити окрему конвертацію.Надано BlackmagicЯкщо говорити про залізо, то останнім релізом гарнітури стало оновлення Vision Pro на чипі M5 у жовтні 2025 року. Гарнітура стала швидшою, зображення - чіткішим, частота оновлення - вищою, а носити її - зручніше, але це все одно було поступове вдосконалення, а не нове покоління. Натомість за останній рік Apple працювала над тим, як visionOS відчувається в роботі і для звичайних, і для корпоративних користувачів, випустила іммерсивні документальні фільми та трансляції матчів MLB, а також додала підтримку сторонніх відстежуваних контролерів і аксесуарів.Водночас відданість visionOS зовсім не обов'язково означає відданість саме Vision Pro. Apple розробляє не лише гарнітури змішаної реальності, а й розумні окуляри та AR-пристрої, і visionOS у тій чи іншій формі може працювати на всіх них, приблизно так само, як сьогодні AndroidXR працює на різних пристроях. Аналітик Мін-Чі Куо цього літа повідомив (Apple цього не підтверджувала), що Vision Pro 2 зсунулася на кінець 2028-го або навіть 2029 рік, оскільки Apple насамперед готує розумні окуляри до кінця 2027 року, щоб конкурувати з Meta та Google/Samsung.Розумні окуляри на AndroidXR | Надано Google, Samsung