Обмеження пам'яті GPU за навантаженнями в Kubernetes за допомогою CUDA 13.4 та планувальника KAI
 Public
- 28 Oct, 2026
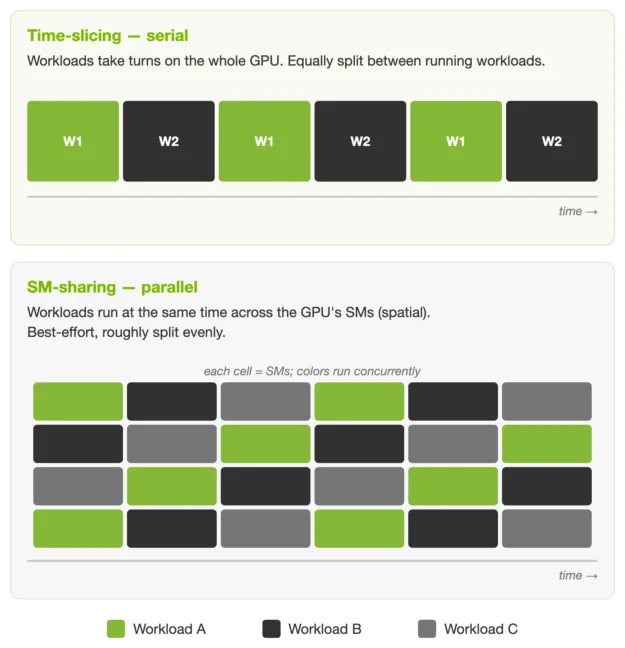
AI-навантаження часто потребують лише частини GPU, але виділення цілих пристроїв призводить до простою потужностей та неефективного використання інфраструктури. GPU NVIDIA підтримують різні механізми спільного використання: Multi-instance GPU (MIG) для апаратної ізоляції, time-slicing для послідовного виконання процесів та Multi-Process Service (MPS) для паралельного виконання в окремих просторах адресів. Хоча MPS дозволяє ділити обчислювальні ресурси, раніше в ньому відсутні були суворі межі пам'яті. CUDA 13.4 закриває цю прогалину, вводячи новий режим time-sharing, який прозоро для додатку обмежує пам'ять, гарантуючи, що кожне навантаження працює в заданих межах без зміни коду.
Впровадження цих можливостей у кластер Kubernetes потребує координації на рівні вузлів, незалежної від планувальника. Оператор gpu-fractioning з відкритим вихідним кодом, розміщений в організації KAI Scheduler на GitHub, працює разом із NVIDIA GPU Operator для налаштування цих параметрів. Він виконує три ключові функції: читає аотації подів для визначення вимог до пам'яті та обчислень, налаштовує призначені GPU для примусового дотримання цих лімітів та керує переходом між різними режимами спільного використання. Цей оператор забезпечує дотримання апаратом логічних меж, заданих планувальником кластера, поєднуючи рішення про планування на високому рівні з виконанням на GPU на низькому рівні.
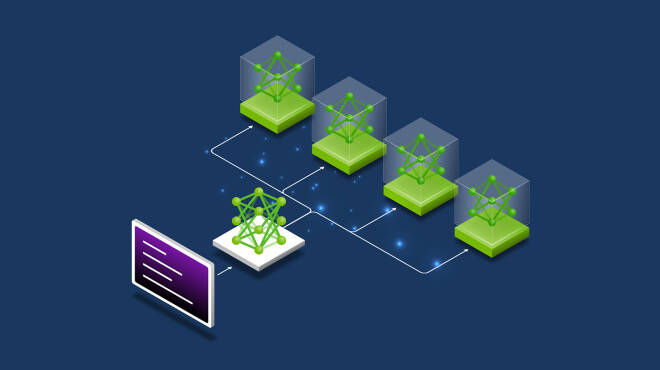
Процес починається з того, що розробники вказують вимоги до ресурсів та режими через аотації YAML подів. Потім планувальник обирає відповідні GPU, записує виділення пам'яті та режим спільного використання обчислень в аотації подів для кожного контейнера та призначає навантаження. Оператор gpu-fractioning читає ці аотації та налаштовує GPU відповідно. Будь-який планувальник Kubernetes, здатний записувати ці аотації, може обмежувати частки GPU, за умови дотримання двох правил: обирати GPU з достатньою вільною пам'яттю та уникати змішування режимів обчислень на одному пристрої. Планувальник KAI першим інтегрував цю функцію, представивши режим спільного використання GPU під назвою NvFractions починаючи з версії v0.18.0.
Режим NvFractions у планувальнику KAI дозволяє адміністраторам визначати дробові навантаження за допомогою чотирьох ключових аотацій, які регулюють запити пам'яті, ліміти зростання, режими спільного використання обчислень та кількість пристроїв. Запити пам'яті можна вказувати як абсолютні розміри, використовуючи стандартні одиниці Kubernetes, або як частки GPU за допомогою аотації gpu-fraction. Нова можливість дозволяє навантаженням оголошувати гарантований мінімальний запит та максимальний ліміт піку, який є необов'язковим і за замовчуванням дорівнює значенню запиту, якщо не вказаний. Ліміти часток повинні перевищувати gpu-fraction і залишатися нижче 1. Спільне використання обчислень тепер встановлюється явно для кожного контейнера, що дозволяє обирати між sm-sharing та time-slicing.
Спільний GPU працює лише в одному режимі обчислень за раз, тому планувальник KAI запобігає розміщенню навантажень з різними режимами на одному GPU, хоча один вузол може містити обидва режими на різних пристроях. Для конфігурацій з кількома GPU аотація gpu-fraction-num-devices вказує, на скільки пристроїв поширюється навантаження, при цьому запит пам'яті застосовується до кожного пристрою індивідуально. Наприклад, запит 40Gi з чотирма пристроями виділяє 40Gi на кожному GPU. Така конфігурація ідеальна для серверів інференсу, яким потрібна гарантована пам'ять на кожен GPU та можливість піку, коли сусіди простоюють, використовуючи sm-sharing для довірених навантажень, що виконуються паралельно в одній області помилок.
Натомість time-slicing підходить для розробки або пакетних завдань, таких як ноутбуки та невеликі сеанси донавчання, де бажана ізоляція. У цьому режимі кожна робоче навантаження отримує власну область помилок, що означає, що збій в одному завданні не впливає на інші. Навантаження може запросити половину двох GPU з лімітом зростання до 80%, коли пам'ять доступна. Запуск nvidia-smi всередині контейнера відобразить дробову частку пам'яті для кожного призначеного GPU. Обидва інструменти, KAI Scheduler та оператор gpu-fractioning, доступні на GitHub в організації KAI Scheduler, з детальними посібниками з встановлення та налаштування для всіх механізмів спільного використання.