Blog
 Public
- 16 Nov, 2026
Lambda interconnecte plus de 10 000 GPU grâce aux commutateurs NVIDIA Photonics à optique co-packagée
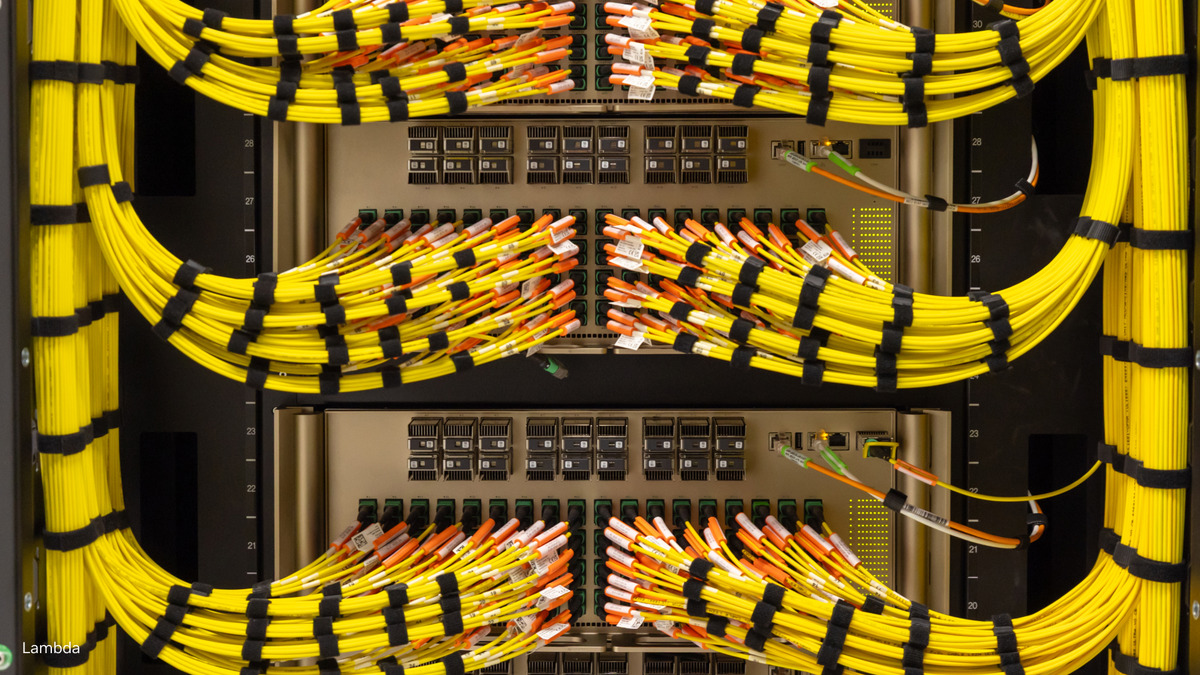
Lambda a déployé des commutateurs NVIDIA Photonics à optique co-packagée (CPO) pour interconnecter des racks NVIDIA GB300 NVL72 totalisant plus de 10 000 GPU. L'objectif est un réseau pour l'entraînement et l'inférence d'IA à grande échelle qui consomme moins d'énergie, résiste mieux aux pannes et offre un temps moyen entre interruptions (MTBI, mean time between interruptions) plus long que les configurations classiques.Lors des tests de Lambda, la latence réseau a diminué d'environ 4 % à l'échelle du rack et jusqu'à environ 10 % à l'échelle du pod. Le débit est resté au niveau de l'optique enfichable classique dans toutes les configurations : rack, unité évolutive et pod. Le réseau est ici essentiel : dans une grande tâche d'entraînement, la défaillance d'une seule liaison peut immobiliser des milliers de GPU, et en inférence agentique, une seule perturbation peut se propager en cascade et ralentir les réponses de nombreux agents. En outre, chaque watt consacré au réseau est un watt retiré au calcul.Dans ces commutateurs, les émetteurs-récepteurs enfichables sont remplacés par des moteurs optiques placés directement dans le boîtier du commutateur, à côté de la puce. Selon NVIDIA, cette conception offre une efficacité énergétique jusqu'à 5 fois supérieure à celle de l'optique enfichable et une fiabilité jusqu'à 15 fois plus élevée : elle utilise quatre fois moins de lasers, et donc moins de pièces susceptibles de tomber en panne. Chaque commutateur du déploiement de Lambda offre 144 ports à 800 Gbit/s, et un refroidissement liquide évacue la chaleur de la puce du commutateur et des moteurs optiques. D'après les mesures de Lambda, la température médiane de l'optique était de 36 °C contre 51 °C pour les modules enfichables, avec une intégrité du signal plus stable.La lumière provient de 18 sources lumineuses externes amovibles par commutateur. Elles alimentent les moteurs optiques, qui convertissent les signaux électriques en signaux lumineux transmis par fibre optique à travers tout le cluster. Ces modules peuvent être remplacés sur site, alors qu'une défaillance laser dans un module enfichable oblige à remplacer l'unité entière. Par ailleurs, le co-packaging réduit le chemin électrique de quelques pouces à quelques millimètres : la perte de signal diminue et les puces retimer deviennent inutiles. La consommation d'énergie baisse ainsi, et le chemin du signal compte moins de composants.
- Public
- 16 Nov, 2026
Android XR prend en charge les OpenXR Spatial Containers pour les applications multi-moteurs
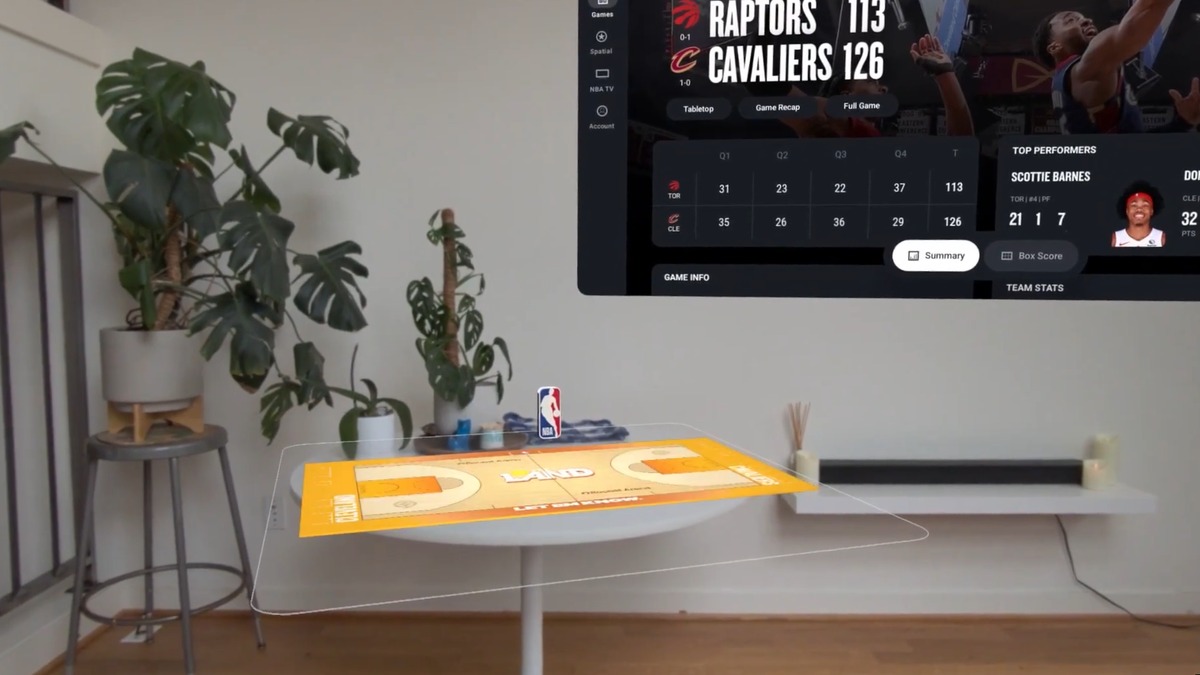
Android XR prend désormais en charge les extensions OpenXR Spatial Container, récemment standardisées. Leur utilisation nécessite un appareil doté du Spatial API Level 4 ou supérieur, et l'application doit s'exécuter en mode Full Space. Ces extensions définissent des espaces gérés par le système, dans lesquels une application affiche du contenu 3D volumétrique, un peu comme un système d'exploitation de bureau place du contenu 2D dans des fenêtres.Jusqu'à présent, une session OpenXR sur Android XR prenait le contrôle exclusif de l'affichage. Avec les Spatial Containers, une application peut afficher du contenu 3D à l'intérieur d'un volume 3D délimité, ou passer à un mode immersif illimité qui se comporte comme une application OpenXR classique. Le système gère les commandes de fenêtre et le positionnement de chaque conteneur. Lorsqu'un conteneur a le focus et est interactif, l'utilisateur peut manipuler directement son contenu grâce au suivi des mains, au regard ou à des contrôleurs 6DoF.Le principal avantage pratique est de pouvoir désormais combiner différentes technologies au sein d'une même application. Une interface en Jetpack Compose, des activités Android 2D classiques et du contenu 3D basé sur OpenXR peuvent coexister. La partie 3D peut être rendue avec des moteurs comme Unity ou Godot, ou bien écrite directement en OpenXR natif. L'application NBA est l'une des premières à en tirer parti, avec une fonctionnalité appelée Court View. Son interface principale est construite avec Compose, tandis que certains matchs affichent des terrains 3D volumétriques rendus par Unity. Cette fonctionnalité reprend Tabletop de l'application NBA pour Apple Vision Pro, qui a elle aussi été renommée Court View.Au niveau du standard, les Spatial Containers pourraient permettre des applications similaires à celles de visionOS. Sur cette plateforme, l'architecture Shared Space et RealityKit permettent aux applications fenêtrées et volumétriques de fonctionner côte à côte et de passer en immersion Full Space. La première implémentation d'Android XR est plus limitée. Les conteneurs nécessitent le mode Full Space Managed plutôt que Home Space, le mode multitâche. Une application peut afficher plusieurs conteneurs qui lui sont propres, mais pas à côté du contenu d'autres applications. Cela est cohérent avec le fait qu'Android XR réserve les composants spatialisés au mode Full Space.Pour l'instant, cette fonctionnalité permet surtout de créer des applications multi-moteurs plutôt qu'un multitâche spatial entre applications. Cela correspond à la description qu'en a faite Google lorsqu'elle a présenté ces capacités en avant-première à la I/O plus tôt cette année : des « expériences multi-moteurs » (multi-engine experiences). L'écart reste important par rapport au multitâche spatial complet proposé par visionOS sur Apple Vision Pro et par Pico OS 6 sur le futur Pico Space Pro.
- Public
- 16 Nov, 2026
CUDA fête ses 20 ans : des premiers programmes pour GPU à 11 millions de développeurs
Lors de la conférence sur les supercalculateurs SC26, NVIDIA célèbre les 20 ans de CUDA et rend hommage aux chercheurs, développeurs et ingénieurs qui ont fait du calcul sur GPU un pilier de la science moderne et de l'IA. La plateforme a été annoncée en novembre 2006, puis présentée à la communauté scientifique lors de SC06. Elle a offert aux développeurs un modèle de programmation familier et de haut niveau pour les GPU, et a étendu le calcul accéléré bien au-delà du graphisme : à la simulation et à d'autres charges de travail exigeantes.Vingt ans plus tard, plus de 11 millions de développeurs s'appuient sur CUDA, à tous les niveaux de la pile informatique. La plateforme est à l'origine de recherches en IA couronnées par un prix Nobel, d'applications scientifiques exécutées sur des supercalculateurs et d'effets visuels dans des films oscarisés. Aujourd'hui, l'écosystème compte plus de 1 000 bibliothèques CUDA-X. Elles sont utilisées pour la découverte de nouveaux médicaments, la conception d'usines, les véhicules autonomes, la modélisation des marchés financiers et l'informatique quantique.L'une des premières étapes marquantes est liée à l'équipe du biophysicien Klaus Schulten à l'Université de l'Illinois à Urbana-Champaign. Ses outils Nanoscale Molecular Dynamics et Visual Molecular Dynamics ont relié le calcul sur GPU à la biologie moléculaire. En 2013, des chercheurs de l'Illinois, de l'Université de Pittsburgh et de l'Université Vanderbilt ont utilisé des outils accélérés par CUDA pour déterminer la structure atomique de la capside du VIH. Pour y parvenir, ils ont combiné des expériences et des simulations sur Blue Waters, alors l'un des superordinateurs les plus puissants au monde.Dans le domaine de l'IA, les chercheurs de l'Université de Toronto Alex Krizhevsky, Ilya Sutskever et Geoffrey Hinton ont utilisé CUDA pour entraîner le modèle AlexNet sur seulement deux GPU NVIDIA. Ce modèle de reconnaissance d'images a remporté le concours ImageNet 2012 et a montré ce dont les GPU étaient capables en apprentissage profond. Plus tard, Demis Hassabis et John Jumper ont partagé le prix Nobel de chimie 2024 pour la prédiction de la structure des protéines avec AlphaFold. Le logiciel AlphaFold 2, publié en accès libre par leur équipe, s'appuie sur CUDA pour son exécution sur GPU.Ces exemples montrent comment le travail d'une génération ouvre la voie à la suivante. Le CUDA Toolkit reste le point d'entrée pour développer sur la plateforme. Au SC26, le stand de NVIDIA accueille également un mur dédié à l'anniversaire, le 20-Year CUDA Celebration Event Wall.
- Public
- 16 Nov, 2026
Unity Fellowship accordera des subventions de 50 000 $ à dix studios indépendants
Unity a lancé Unity Fellowship, un programme d'aide financière et d'accompagnement destiné aux studios de jeux indépendants. Dix équipes dont les jeux doivent sortir dans environ un an seront sélectionnées et bénéficieront d'un accès à des ressources, à un accompagnement et à un réseau de contacts utiles. Chaque équipe recevra une subvention de 50 000 $. Elle n'a pas à céder de parts de son studio en échange, ni à rembourser cet argent. Les studios décident eux-mêmes comment et quand utiliser ces ressources, et conservent un contrôle créatif total, tant sur la vision de leur jeu que sur leur stratégie commerciale.Unity recherche des jeux originaux portés par une forte vision créative. Les candidats doivent envoyer une vidéo présentant le jeu, une version jouable et une feuille de route de développement, et expliquer en quoi les ressources du programme aideront à faire avancer le projet. Le programme s'adresse en priorité aux équipes sans éditeur, mais les studios qui en ont déjà un peuvent également postuler. Tous les contenus du jeu, y compris ceux générés par IA, doivent appartenir au candidat, ou celui-ci doit en détenir les droits.Toutes les régions ne peuvent pas participer. Unity n'acceptera pas les candidatures des développeurs situés dans des pays et territoires soumis à des sanctions américaines, ni celles provenant du Brésil, de l'Italie et de la province de Québec. Le programme s'adresse aux studios indépendants qui développent des jeux avec Unity. Les équipes sélectionnées seront annoncées à la GDC en mars 2027.
- Public
- 16 Nov, 2026
FunFitLand sur Meta Quest propose désormais des entraînements multijoueurs que l'on peut rejoindre à tout moment
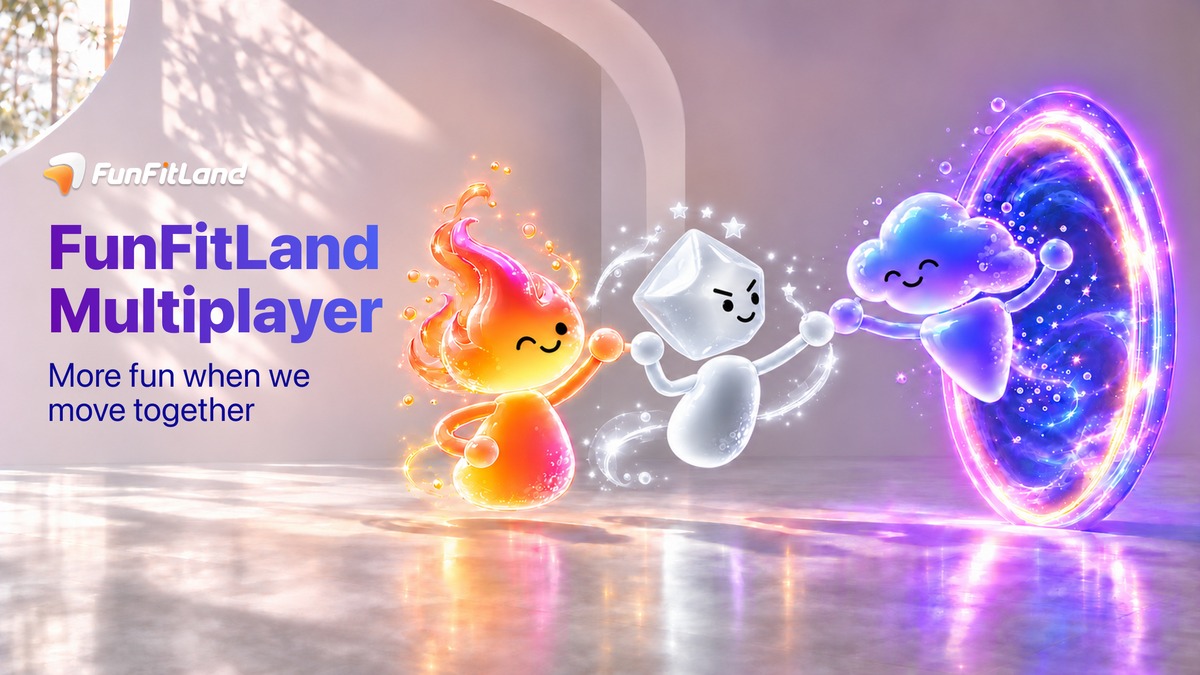
FunFitLand, une application de fitness en VR sur Meta Quest, dispose désormais d'un mode multijoueur. Il répond à l'un des principaux points faibles des entraînements en VR à domicile : le manque de contact social et de la motivation que procurent les séances collectives dans une vraie salle de sport. Tous les types d'entraînement de l'application prennent en charge le multijoueur : CombatFit (boxe rythmique), GrooveFit (danse), SwingFit (mouvements fluides avec des battes), FlowFit (mouvements apaisés inspirés du zen et du tai-chi) et Space, un ensemble d'environnements virtuels méditatifs où l'on ne fait aucun exercice. Dans Space, un groupe peut simplement se retrouver et discuter, par exemple pendant le retour au calme. Cela correspond à l'ambition des créateurs : faire de l'application non seulement un programme de fitness, mais aussi un lieu consacré au bien-être.Le mode multijoueur de FunFitLand. Photo : FunFitLandLes développeurs ont aussi réglé le problème du lobby vide. Dans les autres applications de fitness en VR, une séance de groupe ne commence qu'une fois que tout le groupe est réuni. Dans FunFitLand, on peut ouvrir une salle seul et commencer à s'entraîner tout de suite, et jusqu'à trois autres personnes peuvent ensuite rejoindre la séance en cours de route. L'équipe a consacré environ trois semaines à un seul défi technique : faire arriver le nouveau venu exactement au moment où en est l'hôte de la salle, même s'il s'agit des cinq dernières secondes du retour au calme. Les salles peuvent aussi recevoir des étiquettes de langue : les utilisateurs de l'application vivent partout dans le monde, et on voit ainsi immédiatement si les participants à la séance parlent votre langue.Menu du mode multijoueur. Photo prise par l'auteur.Choix de la langue. Photo prise par l'auteur.En multijoueur, les joueurs apparaissent sous forme de jolis personnages de dessin animé. On peut choisir une forme de tête et un « visage » parmi plusieurs options et personnaliser les touches de couleur. Les concepteurs comptent sur le fait que chacun aura plusieurs avatars et en changera selon son humeur du jour. Par ailleurs, l'avatar masque l'apparence physique, ce qui permet à certains de s'entraîner librement, sans gêne. D'autres applications adoptent une approche différente : FitXR utilise les avatars Meta, tandis que l'ancienne version de Supernatural représentait les utilisateurs par des modèles corporels « flous ». Le mode multijoueur du nouveau Supernatural n'a pas encore été présenté. L'apparence des avatars de FunFitLand a été retravaillée à de nombreuses reprises en fonction des retours de l'équipe interne et de bêta-testeurs externes issus de la communauté Facebook de l'application.Les cibles arrivent sur plusieurs couloirs, avec jusqu'à 360º de mouvement. Lorsque les couloirs latéraux s'ouvrent et commencent à envoyer des cibles, l'avatar du partenaire devient translucide afin qu'elles restent bien visibles. Ce détail subtil est lui aussi issu des tests et des retours des utilisateurs. Grâce à l'option « passer le retour au calme », il est facile d'enchaîner les séances de groupe. Le studio présente le multijoueur comme un élément central de son projet: rassembler les gens autour de l'exercice, du mouvement conscient et de la communauté, et annonce de nouvelles fonctionnalités. FunFitLand est téléchargeable gratuitement sur Meta Quest. L'abonnement coûte 9,99 $ par mois ou 99,99 $ par an.
- Public
- 15 Nov, 2026
À quoi doit ressembler un personnage 3D prêt pour le jeu : les conseils de quatre artistes spécialisés dans les personnages
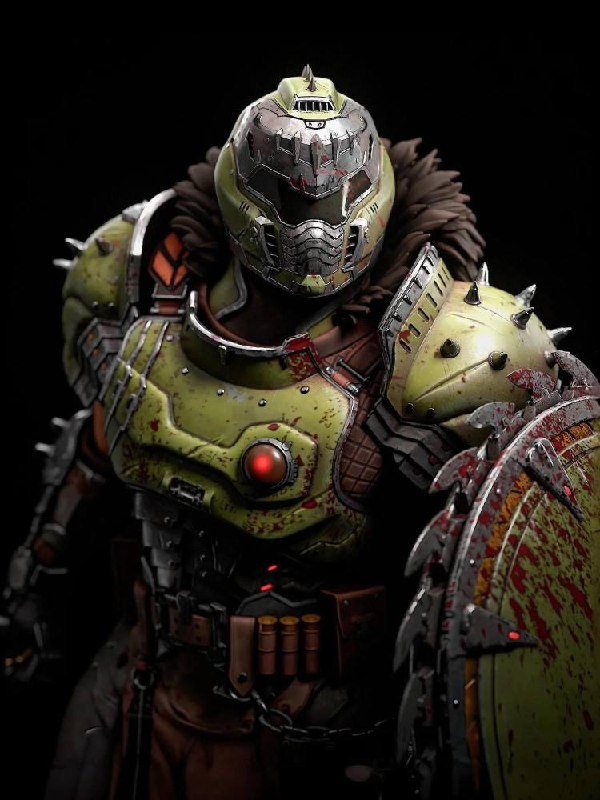
Tout jeu tourne autour d'un héros, mais l'essentiel de ce qui apparaît à l'écran, ce sont les personnages secondaires : ennemis, alliés, marchands, boss, gardes, créatures et figurants. Un protagoniste peut justifier une géométrie lourde et des matériaux complexes. Avec les PNJ, ce n'est pas possible : il faut trouver un équilibre entre impact visuel, performances, cohérence stylistique et efficacité de production. Quatre artistes qui vendent des personnages prêts pour le jeu, RyanReos, Hisqie Furqoni, Andryuha1981 et KirTheGreat, expliquent comment ils trouvent cet équilibre.Pour eux, « prêt pour le jeu » signifie bien plus que « low-poly ». Autrefois, Furqoni jugeait les assets à leur nombre de polygones. Aujourd'hui, il se demande si le modèle s'intègre au pipeline : quel est son rig, comment il se déforme, comment les fichiers sont structurés, s'il est compatible avec le moteur. KirTheGreat cite une topologie propre, une géométrie optimisée, des UV correctes, des textures PBR et une préparation au rigging et à l'intégration dans le moteur. Pour RyanReos, l'idéal est le « plug-and-play ». Ses personnages de fantasy modulaires sont préparés pour Unreal Engine 5 et livrés sous forme de fichiers FBX riggés, conçus pour passer facilement dans Unity ou Godot.Le niveau de détail doit dépendre du rôle du personnage. Andryuha1981 remarque que les héros et les boss majeurs peuvent se permettre une géométrie complexe, puisqu'ils sont peu nombreux à l'écran en même temps, tandis que les ennemis ordinaires doivent être plus légers : « Un jeu ne se compose pas d'un seul personnage principal. » La modularité permet de tirer davantage de personnages d'un même ensemble. RyanReos garde le corps, les cheveux, l'armure et les vêtements séparés. Andryuha combine tenues, coiffures, armes, matériaux et visages pour transformer un seul personnage en plusieurs PNJ. Furqoni préserve la cohérence de ses séries : au sein d'un même style, il fait varier le rôle, la silhouette, les armes et l'armure. Il considère le nommage et l'organisation des fichiers comme « l'UI et l'UX d'un produit 3D ».Tous les quatre mettent en garde : au moment de l'achat, il ne faut pas se fier à une image promotionnelle. Kir conseille de vérifier la topologie, les UV, les textures, le nombre de polygones, les matériaux, le rig, l'organisation des fichiers et la compatibilité avec le moteur. RyanReos insiste sur les versions de moteur prises en charge, une raison fréquente pour laquelle les assets ne fonctionnent pas dans le projet de l'acheteur. Furqoni ajoute la résolution des textures, le type de rig, les formats de fichiers et le contenu inclus, et prévient que les visuels promotionnels générés par IA rendent la vérification encore plus importante. Andryuha recommande de lire la description en entier, d'étudier les captures d'écran et de regarder un aperçu vidéo. Tous s'accordent sur un point : un bon personnage doit s'intégrer à la fois à l'univers du jeu et à son pipeline.
- Public
- 14 Nov, 2026
NVIDIA cuPhoton.xBeam transfère sur GPU la corrélation des données d'interférométrie des trous noirs
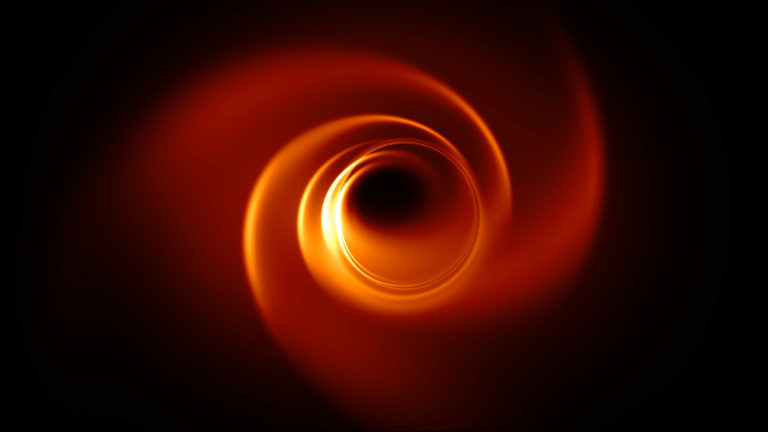
Pour photographier un trou noir, il faut distinguer un objet minuscule: l'anneau observé de M87* ne mesure que 42 microsecondes d'arc. L'Event Horizon Telescope (EHT) relie 13 stations radio, notamment à Hawaï, au Chili, en Espagne, au Mexique et au pôle Sud, grâce à l'interférométrie à très longue base (VLBI). Chaque station enregistre deux polarisations à un débit pouvant atteindre 64 Gbit/s, ce qui produit au total des pétaoctets de données de tension. La corrélation des paires de télescopes fournit des visibilités. Il s'agit d'échantillons de Fourier épars de la luminosité du ciel le long de traces dessinées par la rotation de la Terre. À partir de ces échantillons, les algorithmes de reconstruction résolvent un problème inverse. Avec des sources variables comme Sgr A*, qui évoluent pendant la session d'observation elle-même, la tâche devient encore plus difficile. L'EHT de nouvelle génération (ngEHT) prévoit d'ajouter de nouvelles stations afin d'améliorer la qualité des images et de suivre les changements au fil du temps.Figure 2. Exemple synthétique dans l'esprit de l'EHT, montrant l'échantillonnage des fréquences spatiales, les amplitudes des visibilités, l'image « sale » et un modèle en forme de croissantNVIDIA cuPhoton.xBeam est un corrélateur FX sur GPU. À partir des enregistrements bruts, il produit une visibilité complexe pour chaque paire de stations, chaque canal de fréquence et chaque court intervalle de temps. Le corrélateur a été développé avec le Harvard-Smithsonian Center for Astrophysics et l'observatoire MIT Haystack. Sur un système NVIDIA Vera Rubin NVL72, il a traité un jeu de données de 10 To en 70 secondes. Il a fallu pour cela 64 GPU et GPUDirect Storage en mode de compatibilité. C'est environ 460 fois plus rapide que sur un processeur x86, qui a mis 31 992 secondes, soit 8,89 heures. L'étalonnage et l'imagerie en aval, par exemple les modèles 3D de gaz fondés sur le Gaussian splatting, ne font pas partie de cuPhoton. xBeam ne calcule pas les retards à partir des positions des stations et ne trace pas les trajets de la lumière. Les résultats sont validés par rapport à DiFX, le corrélateur CPU open source, et les données de sortie sont destinées à des outils tels que HOPS, rPICARD et eht-imaging.Figure 4. Accélération de cuPhoton.xBeam par rapport à la référence sur processeur x86 (à gauche) et débit d'ingestion des données (à droite) selon le nombre de GPU sur NVIDIA Vera Rubin NVL72Le pipeline comporte cinq étapes. Lors de l'ingestion, chaque trame VDIF est placée à sa position temporelle correcte. Un fichier annexe .vdix est créé à côté : il indexe les trames par horodatage, par thread et par emplacement physique, sans copier les données elles-mêmes. Les données manquantes ou invalides sont alors signalées explicitement. Lors de la correction du retard et de la phase de frange, les données sont alignées à l'échantillon entier près avant la FFT, puis une rotation de frange leur est appliquée. Le retard fractionnaire restant est compensé par une correction de phase dépendant de la fréquence.Le retard provient du fichier de tâche. Il se compose d'un polynôme géométrique autour de t0, du décalage et de la dérive d'horloge propres à chaque station, ainsi que d'un décalage d'horloge pour chaque bande. Au sein d'une même FFT, le retard peut être constant, linéaire ou parabolique : c'est le paramètre fringe_approximation_order (0, 1 ou 2) qui le détermine. Lors de la canalisation, une FFT est exécutée pour chaque station. Lors de la multiplication croisée avec accumulation, le spectre d'une station est multiplié par le conjugué complexe du spectre de l'autre. Les données d'entrée invalides sont masquées, et le résultat est normalisé à l'aide des poids d'exposition. La sortie est au format DiFX SWIN ou xbeam-v1.La version 0.1.3 accepte une tâche normalisée au format JSON (version de schéma 1) ou un fichier DiFX .input pris en charge. Celui-ci répertorie les stations, les horloges, les fréquences, les flux de données VDIF, les lignes de base et les scans. Le répertoire de sortie doit être nouveau. La commande cuphoton xbeam inspect-vdif RECORDING.vdif --json lit uniquement les en-têtes. La commande build-vdif-sidecar avec les paramètres --index-dir, --backend cufile (ou posix, si GPUDirect Storage n'est pas disponible) et --devices crée des index réutilisables, sans modifier les fichiers sources. La commande cuphoton xbeam correlate JOB.json avec --backend cupy lance la corrélation sur le GPU. Par défaut, les données sont lues via POSIX dans la mémoire hôte épinglée, tandis qu'avec --vdif-io cufile via GPUDirect Storage. Parmi les options figurent --scan, --first-integration et --integration-count. Depuis Python, on peut appeler load_job et correlate avec CorrelationWindow et obtenir les enregistrements un par un, mais l'écriture au format SWIN n'est disponible que via la CLI.Pour les enregistrements comportant des lacunes, il existe le profil --profile interop-real-usb-buffered-window-replay-v1. Avec ce profil, les échantillons situés dans le tampon conservé continuent d'être lus avec la référence temporelle existante, jusqu'à l'apparition d'un nouveau point d'ancrage. Le profil détermine également quels blocs FFT sont pris en compte et comment les poids sont rapportés. Il ne récupère pas les échantillons perdus, et un poids complet ne garantit pas que les données sont complètes. Sans ce profil, les trames sont alignées selon les horodatages des en-têtes et les emplacements manquants sont marqués comme invalides, de sorte que les visibilités et les poids peuvent différer. Pour la mise à l'échelle, un scan est découpé dans le temps. Sur un seul nœud, --devices 0,1,2,3 lance un processus par GPU, écrit les résultats dans RUN/shards/ et les fusionne. Sur plusieurs nœuds, chaque processus reçoit --shard-count et --shard-index, par exemple 64 avec les indices 0-63, en utilisant des paramètres de scans et d'intégrations identiques. Ensuite, merge-shards assemble les résultats SWIN partiels.Figure 1. Les radiotélescopes enregistrent des signaux qui sont corrélés en visibilités pour la reconstruction de l'image. Illustration conceptuelleFigure 3. cuPhoton.xBeam transforme les enregistrements des télescopes en visibilités destinées à la reconstruction d'images en aval
- Public
- 14 Nov, 2026
Cours sur la création d'un fusil Lee-Enfield game-ready : tout le pipeline dans Blender, Substance et Marmoset
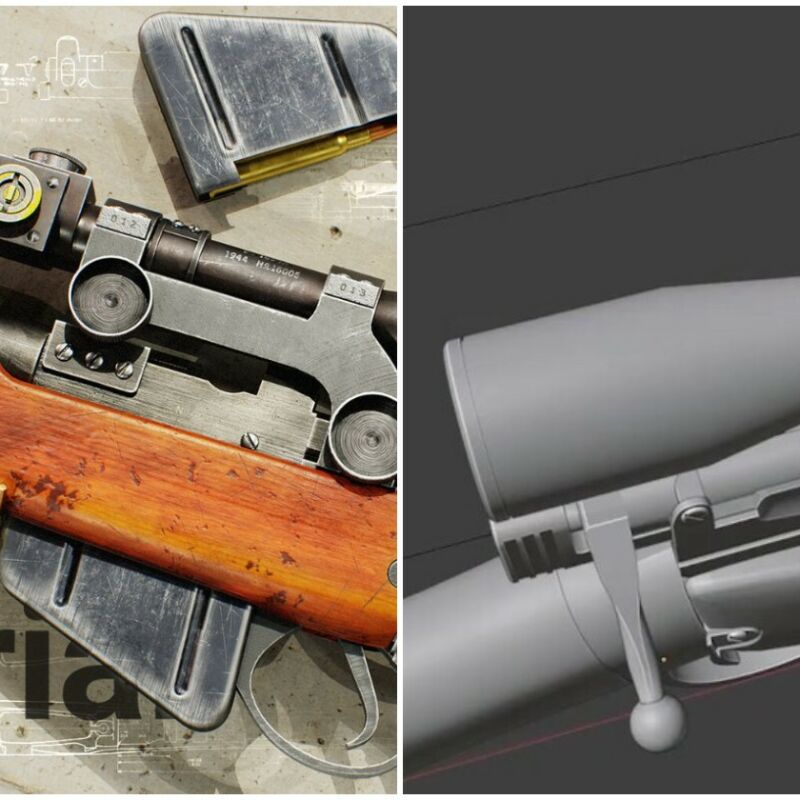
Titanium Studio a publié le cours Mastering LEE-ENFIELD NO4 MK1 Game Ready Creation in Blender. Il est orienté vers la production réelle et compte plus de 26 heures de vidéo. Le cours est animé par Navid Valizadeh, artiste senior spécialisé dans les armes et les props, qui se consacre aux assets photoréalistes. Le projet pédagogique est un fusil de précision inspiré de la Seconde Guerre mondiale : il est créé de zéro et mené jusqu'à un rendu final soigné.Le modèle est construit dans Blender à l'aide de techniques professionnelles de modélisation hard-surface. L'accent est mis sur une géométrie propre, des composants détaillés et un workflow structuré. L'asset est ensuite transféré dans Substance 3D Painter pour la texturation : les étudiants créent des matériaux réalistes, ajoutent des variations de surface, règlent la rugosité, appliquent l'usure et les détails fins. Le cours enseigne l'ensemble du processus de création d'un asset, et pas seulement l'utilisation d'outils isolés.La dernière étape consiste à préparer le fusil pour sa présentation dans Marmoset Toolbag 5. On y aborde l'éclairage professionnel, le paramétrage des matériaux, la composition du cadrage et les techniques qui permettent de mettre en valeur l'arme finie. Ensemble, ces trois étapes reproduisent un pipeline typique de création de props game-ready utilisé en production.
- Public
- 14 Nov, 2026
Meta-Optics Mirror de TDK et balayage de Lissajous cohérent : le retour des lunettes AR à laser
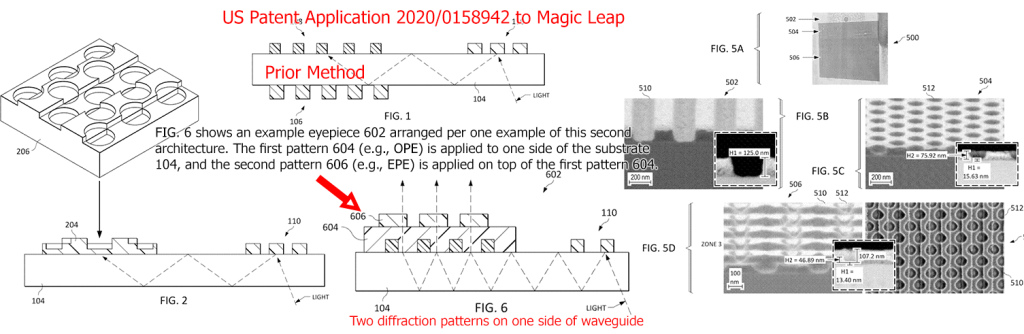
Le 2 octobre 2026, TDK a annoncé le Meta-Optics Mirror, un nouveau type de « combineur en espace libre » (free-air combiner) pour lunettes AR. Cette annonce fait suite à deux accords conclus plus tôt dans l'année. En mai 2026, TDK a acquis les principaux actifs, la propriété intellectuelle et l'équipe d'Oqmented. Cette entreprise fabriquait des miroirs MEMS sous vide pour le balayage laser (LBS) selon des figures de Lissajous. En juin 2026, TDK a signé un accord de coopération commerciale avec le fabricant de lasers QD Laser : les deux entreprises développeront ensemble des moteurs optiques à projection rétinienne pour lunettes connectées. Elles collaborent depuis au moins 2020. QD Laser, issue de Fujitsu, présente le balayage rétinien direct par LBS depuis au moins 2016.Cet accord change l'orientation de TDK. Oqmented se concentrait sur le LBS à base de guides d'ondes. Dans cette configuration, le guide d'ondes élargit la pupille, et l'image en sortie se comporte plutôt comme celle d'un écran plat : la lumière cesse d'être « maxwellienne », c'est-à-dire sans mise au point nécessaire. Le miroir de TDK vise au contraire la projection rétinienne directe, une voie suivie auparavant par Microvision, Bosch, North Focals, Intel Vaunt et Eyeway Vision. Les guides d'ondes offrent une zone de visualisation bien plus large et évitent les inconvénients d'un trajet laser à l'air libre entre le projecteur placé dans la branche et l'œil. Lorsque le faisceau traverse l'air, une poussière sur une surface ou un simple cheveu sur son passage peut projeter une ombre large et nette sur une partie de l'image, et des inquiétudes quant à la sécurité oculaire apparaissent chez les utilisateurs. Le site de TDK mentionne toujours l'approche par guide d'ondes, l'entreprise semble donc développer les deux voies.Le miroir oriente la lumière du scanner vers l'œil grâce à des nanostructures dont la taille varie de 200 nm à 1 µm. Un miroir ordinaire réfléchirait la lumière d'un projecteur logé dans la branche selon un angle tel qu'elle manquerait complètement l'œil. La structure est fabriquée par un procédé proche de ceux des semi-conducteurs, sur un substrat mince. Elle peut être intégrée dans un verre de lunettes ordinaire, probablement prise en sandwich entre deux moitiés de verre, comme on le fait aujourd'hui avec les guides d'ondes. Dans le schéma de TDK, le faisceau du projecteur se propage presque parallèlement à la monture jusqu'à un second miroir situé près du verre. De là, il frappe le nano-réflecteur sous un angle très rasant, ce qui permet de garder un trajet dans l'air court. La version actuelle fonctionne uniquement en vert, et la taille des structures dépend probablement de la longueur d'onde, comme dans les guides d'ondes diffractifs. TDK indique accélérer le travail sur une démo en couleurs et vise une production de masse « dans les prochaines années ». Le terme « méta-optique » désigne ici une optique plane à structures sub-longueur d'onde et n'a rien à voir avec l'entreprise Meta. D'ailleurs, les réseaux des guides d'ondes, avec leurs sous-structures complexes de moins de 100 nm, brouillent déjà la frontière entre réseaux et métasurfaces.Au salon MicroLED and AR/VR/MR Connect 2026, TDK a présenté une courte démonstration fonctionnelle de ce qu'Oqmented appelait à l'origine le « balayage de Lissajous progressif » (Progressive Lissajous Scanning). Le site de TDK parle désormais de balayage de Lissajous « cohérent », le même terme que Meta a employé à SPIE AR/VR/MR 2025, bien que TDK affirme avoir eu l'idée de manière indépendante. Dans le balayage de Lissajous, un seul miroir est piloté par deux sinusoïdes, et le faisceau décrit une trajectoire semblable à un huit. Chez Oqmented, l'axe rapide fonctionne à 20-40 kHz. Le LBS à balayage raster est différent : son axe vertical tourne à environ 60-120 Hz, contre 20-60 kHz pour l'axe horizontal. Dans le balayage de Lissajous, l'axe lent a une vitesse bien plus proche de celle de l'axe rapide, si bien que le faisceau suit des trajectoires diagonales fortement incurvées. Traditionnellement, les pixels sont écrits de façon pseudo-aléatoire, au moment où le faisceau les traverse, et le laser est modulé en fonction à la fois de la luminosité et de la vitesse du faisceau. Résultat : lors des saccades oculaires, l'œil perçoit des images incomplètes ainsi que le motif de balayage lui-même.La variante cohérente conserve le même mouvement du miroir, mais trace les pixels dans l'ordre du passage du faisceau, en les regroupant en segments incurvés semblables à un raster. Le laser est éteint pendant le lent retournement du faisceau à chaque extrémité du balayage. La fragmentation de l'image lors des saccades disparaît ainsi, mais les limites fondamentales demeurent. Il faut rééchantillonner une grille de pixels rectangulaire sur des lignes de balayage incurvées qui ne tombent jamais exactement sur un pixel, ce qui, selon la théorie de base de Nyquist, coûte environ un facteur deux en résolution effective sur chaque axe. Pour que la plupart des gens ne perçoivent pas de scintillement, chaque point doit être rafraîchi, même dans le pire des cas, plus d'environ 90 fois par seconde. Avec un axe rapide à 40 kHz, on obtient après rééchantillonnage environ 300 lignes effectives. À titre de comparaison, le NTSC, avec une fréquence de ligne d'environ 15 kHz, affichait du 720×480 entrelacé à 60 Hz, et ce sans aucun rééchantillonnage sur une grille incurvée. Historiquement, les systèmes LBS ont dû choisir entre scintillement et résolution.Le prototype basse résolution d'Oqmented/TDK présenté a bien éliminé la fragmentation de l'image, mais un scintillement restait visible. Parmi les autres travaux sur les combineurs, CREAL développe un combineur HOE. Des approches plus radicales apparaissent également, comme les mini-miroirs actifs de Gixel et le combineur à cristal non linéaire de Smith Display.
- Public
- 13 Nov, 2026
Apple confirme qu'elle ne renonce pas à visionOS lors d'une session pour les développeurs d'informatique spatiale
Apple a organisé une session d'une journée pour les développeurs, « Meet with Apple », entièrement consacrée à visionOS, sa plateforme d'informatique spatiale, et en a profité pour répondre aux doutes sur ses projets XR qui s'accumulaient depuis des mois. Yuri Imoto, chef de produit au sein de la division Spatial Computing d'Apple, a déclaré que l'entreprise est « très engagée envers la plateforme » et a souligné que l'informatique spatiale a énormément progressé en peu de temps. La chirurgie, la santé, l'éducation, la formation professionnelle et le cinéma immersif ont été présentés lors de l'événement comme les axes clés de la plateforme.L'une des annonces les plus marquantes a été le microphone ambisonique professionnel de Blackmagic. Il intègre 108 microphones et un processeur interne qui convertit lui-même le signal dans un format directement exploitable pour le contenu spatial d'Apple. Les créateurs de son immersif n'auront plus besoin d'effectuer une conversion séparée.Avec l'aimable autorisation de BlackmagicCôté matériel, la dernière sortie de casque a été la mise à jour de Vision Pro avec la puce M5 en octobre 2025. Le casque est devenu plus rapide, l'image plus nette, la fréquence de rafraîchissement plus élevée et le port plus confortable, mais il s'agissait tout de même d'une amélioration progressive et non d'une nouvelle génération. Au cours de l'année écoulée, Apple s'est plutôt concentrée sur l'expérience utilisateur de visionOS, aussi bien pour le grand public que pour les entreprises, a publié des documentaires immersifs et des retransmissions de matchs de la MLB, et a ajouté la prise en charge de manettes suivies et d'accessoires tiers.Cela dit, l'engagement envers visionOS ne signifie pas forcément un engagement envers Vision Pro en particulier. Apple développe non seulement des casques de réalité mixte, mais aussi des lunettes connectées et des appareils AR, et visionOS pourrait fonctionner sous une forme ou une autre sur l'ensemble de ces appareils, un peu comme AndroidXR fonctionne aujourd'hui sur différents appareils. L'analyste Ming-Chi Kuo a indiqué cet été (sans confirmation d'Apple) que Vision Pro 2 a été repoussé à fin 2028, voire 2029 au plus tôt, car Apple donne la priorité aux lunettes connectées prévues pour fin 2027 afin de concurrencer Meta et Google/Samsung.Lunettes connectées sous AndroidXR | Avec l'aimable autorisation de Google, Samsung