Blog
 Public
- 24 Oct, 2026
Tripo P2.0 et le flux de travail Astra : génération et intégration d'actifs 3D dans Blender et Unity
Les flux de travail 3D génératifs évoluent de la création de modèles isolés vers des pipelines d'actifs intégrés. Le dernier modèle de base natif 3D de Tripo, P2.0, est conçu pour générer des maillages basés sur des triangles ou des quads, avec des fonctionnalités telles que la densité de polygones ajustable, la séparation des parties, les Smart UVs et l'édition régionale des maillages. Associé à Astra, ces actifs peuvent être assemblés, riggués, animés et intégrés dans des scènes interactives à l'aide de logiciels professionnels comme Blender et Unity. Cette division du travail permet aux créateurs de se concentrer sur des composants spécifiques, tandis qu'Astra gère la coordination des tâches en aval, garantissant que la géométrie générée répond efficacement aux exigences de rigging, d'animation et de production en temps réel.Publication sur X : https://twitter.com/luccacerf/status/2096308567863079420Le flux de travail fonctionne en générant des parties individuelles séparément, offrant ainsi aux créateurs un contrôle précis sur la forme et les détails. Par exemple, un créateur peut générer le corps, la tête et les cheveux d'un personnage comme des actifs distincts en utilisant Tripo P2.0 ou le modèle H3.1, qui se concentre sur les détails de haute fidélité. Astra aide ensuite à assembler ces composants dans Blender, en gérant la transition vers le rigging et l'animation. Cette approche modulaire permet aux utilisateurs d'affiner ou de régénérer des composants spécifiques sans recommencer tout le processus de génération d'actifs. La capacité d'Astra repose sur le raisonnement sur les tâches 3D et l'exécution de code ou de scripts pour manipuler les actifs, ce qui en fait un outil puissant pour coordonner des processus complexes en plusieurs étapes dans des environnements 3D établis.Publication sur X : https://twitter.com/Stefan_3D_AI/status/2096481425050743048Des applications pratiques de ce flux de travail ont déjà émergé au sein de la communauté. Le créateur Ring Hyacinth a utilisé Nano Banana pour les images de référence, Tripo P2.0 pour la modélisation et Codex pour construire une scène d'Alice au pays des merveilles avec effets et interactions. De même, Lucca Cerf, qui n'a pas de formation en développement de jeux ou en design, a utilisé un pipeline Astra vers Tripo P2.0 vers Blender vers Unity pour créer un jeu de fans de World of Warcraft. En s'appuyant sur seulement trois prompts, Cerf a terminé le projet en environ 90 minutes. Ces exemples démontrent que la combinaison de Tripo et d'Astra permet aux personnes sans expérience préalable en 3D de créer rapidement des scénarios interactifs complexes et des prototypes jouables.Les spécifications techniques des modèles de Tripo sont adaptées à la production. La série P optimise la structure du maillage, la topologie et l'éditabilité, tandis que la série H privilégie la fidélité pour les formes complexes. Les utilisateurs peuvent gérer la densité de polygones, choisir entre une topologie triangulaire ou quadrangulaire via Smart Mesh, et générer des textures et des matériaux. Des fonctions de rigging et d'animation automatiques sont disponibles pour les personnages, et les paramètres d'exportation permettent un contrôle précis de l'échelle, de l'orientation et des points de pivot lors du transfert des assets vers Blender ou des moteurs de jeu. Ce niveau de contrôle garantit que les assets générés répondent aux normes techniques requises pour les moteurs temps réel et les applications DCC professionnelles.Le contrôle qualité reste un aspect critique du flux de travail, car l'IA accélère la création mais n'élimine pas le besoin de jugement artistique. Après l'assemblage, les créateurs doivent vérifier les proportions, l'alignement, les silhouettes et les connexions entre les composants. L'animation nécessite une évaluation de la déformation dans des zones telles que les épaules, les coudes, les genoux et les expressions faciales. Bien que ce flux de travail convienne aux étapes de production initiales et intermédiaires, comme l'idéation, le prototypage et la prévisualisation, les studios professionnels peuvent encore affiner les assets principaux dans des outils DCC. L'objectif est de rendre la génération 3D de haute qualité accessible sans exiger de chaque créateur qu'il devienne un spécialiste 3D, permettant aux artistes de se concentrer sur la direction créative et l'intégration dans des systèmes artistiques cohérents.
- Public
- 24 Oct, 2026
Les enregistrements de JetBrains GameDev Day 2026 sont disponibles : les solutions techniques clés pour le développement de jeux moderne
L'archive complète de JetBrains GameDev Day 2026 est désormais accessible sur YouTube. C'est une ressource exhaustive pour les développeurs qui résolvent des problèmes de production réels. L'événement, qui s'est tenu le 28 septembre, a réuni des experts de l'industrie pour discuter des outils et des méthodologies qui façonnent le paysage actuel de l'ingénierie des jeux. Les sessions se concentrent fortement sur les applications pratiques, allant de l'intégration des systèmes entités-composants (ECS) dans des jeux en ligne à l'utilisation de l'IA pour la génération procédurale de contenu. Les développeurs qui ont assisté aux soirées de visionnage à Belgrade ou à Limassol, ou ceux qui ont manqué l'événement en direct, peuvent maintenant revoir les matériaux à leur propre rythme pour approfondir leur compréhension des flux de travail et des outils de développement modernes.Une part importante du contenu technique porte sur l'intégration de l'IA dans les pipelines de développement existants. Une session clé montre comment la prise en charge du Model Context Protocol par TeamCity et l'interface en ligne de commande (CLI) intègrent les flux de travail d'intégration continue directement dans l'environnement de développement. En utilisant un projet Unity comme étude de cas, la présentation démontre comment investiguer les échecs de compilation et interagir avec les pipelines CI sans avoir constamment à basculer entre différents outils. De plus, une autre conférence explore les flux de travail agentiques adaptés spécifiquement à Unreal Engine, en utilisant Rider, ACP et des compétences propres au moteur. Ces démonstrations illustrent comment les agents IA peuvent naviguer dans des architectures de moteur complexes, générer du code C++, investiguer les plantages et automatiser diverses tâches de développement, allant au-delà de l'assistance simple à l'écriture de code vers une résolution de problèmes plus autonome.Pour les équipes travaillant avec de grands actifs, la session sur Lore VCS open source d'Epic Games offre des perspectives essentielles sur la gestion de fichiers de plusieurs gigaoctets qui changent quotidiennement. Contrairement aux systèmes de contrôle de versions traditionnels conçus pour le code, Lore découpe les fichiers en fragments adressables par contenu, garantissant que seules les parties modifiées d'un actif sont transférées. La discussion aborde la manière dont les caches périphériques peuvent être remplis à la demande plutôt que pré-remplis, et inclut des instructions pour déployer le système à l'aide du module Lore dans le AWS Cloud Game Development Toolkit. Cette approche résout un goulot d'étranglement majeur dans le développement de jeux moderne, où la gestion des actifs ralentit souvent la collaboration et les processus de compilation. Comprendre ces mécanismes est essentiel pour les studios souhaitant optimiser leur infrastructure et réduire les coûts de stockage et de bande passante.L'optimisation des performances et le débogage restent des thèmes centraux, avec des sessions détaillées sur le profilage dans Unreal Engine et le débogage interlangages. Un intervenant utilise le profilage en direct pour montrer comment de petites décisions d'ingénierie s'accumulent pour former des goulots d'étranglement du gameplay, en démontrant des flux de travail d'optimisation pratiques à l'aide d'Unreal Insights et de Rider. Une autre session aborde le scénario complexe où le client est écrit en C# et le serveur en C++, montrant comment déboguer les deux environnements d'exécution simultanément avec Rider et CLion. Cette approche permet aux développeurs de lire les données traversant la frontière du protocole et de déterminer quel environnement d'exécution cause les problèmes. L'accent est mis sur la frontière entre les environnements d'exécution comme zone critique d'investigation, offrant une méthode structurée pour résoudre les bogues qui touchent plusieurs langages et environnements.L'événement a également présenté des analyses approfondies des intégrations spécifiques de moteurs et de l'automatisation de l'interface utilisateur. Une session notable a présenté un pipeline Figma-to-Unity qui a évolué au fil des années d'utilisation en production et qui fonctionne désormais via un agent IA sur MCP. Les intervenants ont couvert les fondations de conception qui rendent cette automatisation possible, les leçons tirées de la construction du système, et un benchmark des tâches d'intégration UI que l'agent peut gérer aujourd'hui par rapport à celles qui nécessitent encore une intervention humaine. Une autre présentation s'est concentrée sur l'intégration de l'ECS dans un jeu en ligne grand public sans réécrire le moteur, en discutant des stratégies de migration par étapes, des compromis sur la disposition de la mémoire et des avantages d'une approche hybride combinant ECS et code legacy. Ces sessions fournissent des stratégies actionnables pour moderniser les bases de code existantes tout en maintenant la stabilité des produits en ligne.
- Public
- 24 Oct, 2026
NVIDIA TensorRT 11.1 : le Global Performance Tuner pour l'optimisation automatique des moteurs en tenant compte de la précision
Le déploiement des réseaux de neurones est fondamentalement un défi de compilation, où aucune stratégie optimale unique n'existe pour tous les modèles. Lorsque NVIDIA TensorRT construit un moteur d'inférence, il prend des décisions interdépendantes concernant les transformations de graphe, la fusion de noyaux, le placement mémoire et la quantification. Ce processus, connu sous le nom de planification (scheduling), a un impact significatif sur les performances finales d'inférence. Différents choix de planification peuvent préserver la sémantique du modèle tout en produisant des résultats de vitesse très différents. Étant donné que ces effets sont couplés et dépendent du modèle, ils ne deviennent souvent apparents qu'après la construction et la mesure complètes du moteur. Cela rend la prédiction de la meilleure stratégie de plus en plus difficile à mesure que les modèles et les environnements de déploiement se diversifient.Figure 1. Une recette fixe ne se généralise pas aux préférences contradictoires des clientsHistoriquement, TensorRT s'appuyait sur des modèles internes d'indicateurs clés de performance (KPI) pour identifier les motifs optimisables, qui étaient ensuite encodés sous forme d'heuristiques dans la stratégie de planification par défaut. Bien que cela permettait aux utilisateurs de bénéficier automatiquement de connaissances expertes, cela a créé un problème d'évolutivité. Une heuristique conçue pour un type de modèle pouvait provoquer une régression des performances sur un autre, nécessitant des exceptions supplémentaires qui rendaient la logique de planification complexe et difficile à étendre. Le Global Performance Tuner, introduit dans TensorRT 11.1, résout ce problème en s'éloignant d'une recette unique et fixe. Il considère plutôt le pipeline du compilateur comme une recette de base avec des assaisonnements configurables, permettant au système d'adapter son chemin d'optimisation aux caractéristiques spécifiques de chaque modèle d'entrée, qu'il s'agisse d'un graphe ONNX ou d'un réseau créé via l'API TensorRT.Figure 2. Ajustez le goût pour chaque clientPour formaliser cette approche, le système utilise un cadre mathématique qui sépare la génération des solutions candidates de leur sélection. L'espace des modèles comprend toutes les entrées possibles, tandis que l'espace des solutions contient toutes les sorties exécutables, telles que les moteurs TensorRT ou les séquences de noyaux GPU sérialisés. Un algorithme de construction (builder) associe un modèle à un ensemble de solutions candidates, limité par un seuil de tolérance de précision. Ce seuil garantit que les paires entrée-sortie restent dans des limites acceptables, empêchant les optimisations agressives de violer les exigences de l'application. L'objectif de l'algorithme de construction est de générer un ensemble riche de candidats incluant la solution optimale, définie comme l'exécution réalisable la plus rapide qui satisfait aux critères de précision. Cette abstraction permet une analyse rigoureuse de l'impact des différents chemins de construction sur le temps d'exécution final.Un algorithme de recherche opère ensuite sur cet ensemble de candidats pour sélectionner la meilleure solution. Idéalement, cet algorithme effectuerait une évaluation par force brute de chaque candidat pour trouver celui ayant le temps d'exécution minimal. Cependant, en pratique, les budgets de temps de construction limitent souvent la profondeur de cette recherche. Le compilateur global est donc représenté comme un couple composé d'un constructeur (builder) et d'un chercheur (searcher). Le défi réside dans la construction d'un constructeur optimal qui rend la solution globalement optimale accessible. Étant donné qu'aucun chemin de construction universel unique ne fonctionne pour tous les modèles, le système doit prendre en charge des chemins de construction personnalisables. Cela signifie que la séquence des passes du compilateur, qui transforment les représentations intermédiaires en exécutables finaux, peut varier. Différents modèles peuvent atteindre leurs meilleures performances via des séquences de transformations différentes, même sur le même GPU cible.Le Global Performance Tuner exploite ces routes de compilation personnalisables pour effectuer un réglage automatique des performances. Pour chaque solution candidate générée par différentes routes, l'outil de réglage valide les résultats par rapport au critère de précision spécifié. Il mesure ensuite les performances d'inférence de bout en bout des solutions viables. Parmi tous les candidats qui satisfont aux exigences de précision, le système sélectionne celui dont le temps d'exécution est le plus faible. Cette approche garantit que les gains de performance ne se font pas au détriment de la fidélité du modèle. En considérant le processus de compilation comme une recherche parmi plusieurs routes de compilation possibles plutôt que comme un chemin unique et fixe, TensorRT 11.1 offre une méthode évolutive pour optimiser les charges de travail d'apprentissage profond sur des modèles et des configurations matérielles variés.Cette méthodologie résout la limitation fondamentale des approches précédentes, où une modification pour un modèle pouvait dégrader les performances d'un autre. En maintenant le pipeline de base stable tout en rendant les décisions de planification configurables, le système gère efficacement les nouveaux modèles aux préférences inconnues. Il propose différentes variations d'optimisation, rejette celles qui échouent aux contrôles de précision et conserve la configuration offrant les meilleures performances. C'est analogue à un chef qui propose des échantillons gratuits à un nouveau client pour trouver la combinaison d'épices préférée, plutôt que d'imposer une recette standard unique. Le résultat est un processus de compilation plus robuste qui s'adapte aux besoins spécifiques de chaque réseau de neurones, garantissant aux développeurs la vitesse d'inférence la plus élevée possible sans compromettre la précision requise de leurs applications.
- Public
- 23 Oct, 2026
Barrières structurelles à l'adoption massive des lunettes AR optiques à affichage transparent
Le secteur de la réalité augmentée optique à affichage transparent (see-through AR) traverse actuellement un virage stratégique majeur. Pendant des années, l'industrie a tenté de dériver les capacités AR à partir de casques de réalité virtuelle haut de gamme, visant un large champ de vision et des fonctions complexes, ce qui a abouti à des appareils encombrants et coûteux. Cette approche a largement stagné. La trajectoire moderne consiste à développer la fonctionnalité en partant des lunettes IA audio uniquement, telles que les Meta Ray-Ban Wayfarers, qui ont atteint un point d'inflexion critique d'environ dix millions d'unités expédiées par an. Ce volume est un repère clé pour l'adoption sur le marché de masse. En revanche, les expéditions de casques VR ont régressé du pic de dix millions d'unités en 2021 à entre 3,5 et 6 millions d'unités en 2026, indiquant que le dépassement des segments d'enthusiastes reste un obstacle formidable pour le matériel immersif.Un obstacle majeur, souvent sous-estimé, à l'adoption par les consommateurs est l'intégration des lentilles correctrices. Pour les utilisateurs ayant besoin d'une correction de la vue, les lunettes AR actuelles représentent un cauchemar logistique et ergonomique. Contrairement aux lunettes IA sans affichage, qui peuvent accueillir des lentilles correctrices standard découpées localement pour s'adapter à la monture, les dispositifs AR à affichage nécessitent généralement l'application en usine de lentilles correctrices sur les guides d'ondes. Ce processus crée un SKU unique pour chaque client, entraînant des délais de livraison longs, mesurés en semaines. De plus, ces corrections intégrées échouent souvent à corriger adéquatement l'astigmatisme ou la vision bifocale. Des solutions de clips après-vente existent, mais elles sont trop encombrantes pour fonctionner comme des lunettes ordinaires, limitant leur utilité aux contextes d'entreprise ou de VR plutôt qu'à l'usage quotidien des consommateurs.Les technologies d'affichage nécessaires à des lunettes AR viables font face à un important stagnation. Les écrans MicroLED pleine couleur, essentiels pour une lisibilité de haute qualité en extérieur, mettent du temps à atteindre la production de masse. Les rumeurs actuelles suggèrent que, bien que certains fabricants puissent démarrer la production à court terme, la résolution reste faible, se situant généralement autour de 640 par 480 pixels. Cette résolution de classe VGA est comparable aux standards des ordinateurs personnels des années 1980 et est insuffisante pour la consommation de texte ou de médias haute fidélité. Le manque de micro-écrans haute résolution et pleine couleur signifie que les appareils AR actuels ne peuvent pas rivaliser avec la clarté visuelle que les utilisateurs attendent des smartphones ou tablettes modernes, limitant davantage leur attrait pour le grand public.Les chaînes d'approvisionnement de composants sont sous pression croissante en raison de la demande explosive pour l'infrastructure IA. La consommation massive de semi-conducteurs par les centres de données IA a absorbé les capacités de production excédentaires, laissant moins de ressources pour les fabricants d'électronique grand public. Cette pénurie affecte la disponibilité des processeurs, de la mémoire et d'autres composants critiques nécessaires aux lunettes AR. De plus, l'inclusion de caméras introduit un compromis complexe. Bien que les caméras permettent des fonctions avancées comme la localisation et la cartographie simultanées, elles augmentent significativement la consommation d'énergie, la taille et le poids. Un module de caméra peut consommer autant d'énergie que l'écran lui-même, rendant difficile le maintien du format des lunettes ordinaires tout en offrant une autonomie de batterie pour toute la journée.L'industrie doit éviter le piège de se concentrer sur une seule métrique, comme le coût, pour stimuler l'adoption. Bien que le prix soit un facteur, il est secondaire par rapport à la fonctionnalité et à l'ergonomie. Les exemples historiques, tels que l'Apple II et le Macintosh original, montrent que des prix initiaux élevés sont acceptables si le produit offre une valeur unique. Tenter de construire un appareil à bas coût avec des fonctionnalités limitées est une mauvaise allocation des ressources. Le défi est systémique : résoudre un problème technique, comme la luminosité de l'écran, aggrave souvent d'autres, comme la consommation d'énergie ou la génération de chaleur. Il existe environ dix-sept à vingt barrières majeures qui doivent être résolues simultanément, y compris la transparence, la lueur des yeux, les artefacts de diffraction et l'assombrissement en extérieur.Pour un port toute la journée, l'appareil doit fonctionner comme des lunettes ordinaires lorsqu'il est éteint. Si l'appareil provoque des distorsions ou une mauvaise correction de la vision à l'état inactif, il ne répond pas à l'exigence de base d'être des lunettes. Les utilisateurs ne sont pas disposés à retirer leurs lunettes et à les ranger dans une housse de protection, ce qui annule l'intérêt d'un appareil portable. De plus, l'intégration de l'affichage avec le monde réel dégrade intrinsèquement la qualité des deux images. La présence physique de l'optique entre l'œil et le monde introduit des réflexions et des artefacts. Par conséquent, le développement de lunettes AR nécessite une approche holistique qui traite la fidélité optique, le confort ergonomique, la compatibilité avec les verres correcteurs et la disponibilité des composants comme un système unique et interconnecté, plutôt que comme une série de problèmes isolés.
- Public
- 23 Oct, 2026
Guide stratégique pour les développeurs XR souhaitant pénétrer le marché chinois
Le secteur de la réalité immersive est actuellement défini par deux acteurs majeurs : les États-Unis et la Chine. Alors que le marché américain est bien documenté, la Chine reste entourée de mystère pour de nombreux développeurs occidentaux en raison du Grand Pare-feu et de la prévalence de la désinformation. Les médias technologiques occidentaux diffusent souvent des récits inexactes, tels que l'existence d'un système universel de score de crédit social ou d'un métavers basé sur WeChat, qui ne correspondent pas à la réalité pour ceux qui opèrent au sein du pays. Avec une population de 1,4 milliard d'habitants, dont 870 millions de personnes âgées de 15 à 59 ans, la Chine représente une opportunité massive pour les équipes qualifiées. Cependant, le succès exige de dépasser les ouï-dire et de comprendre que l'écosystème local fonctionne selon des principes fondamentalement différents de ceux de l'Occident.Créé à l'aide d'une image fournie par PicoContrairement à l'Occident, la Chine n'a jamais connu de « moment Quest », où un seul casque grand public combinait un prix abordable et une bibliothèque de contenu robuste pour favoriser une adoption de masse. Meta est interdite de vente sur ce marché, et Pico, le concurrent le plus proche, a déplacé son axe stratégique peu après la sortie du Pico 4, laissant un quasi-vide sur le marché du VR grand public. Par conséquent, un jeu à succès conçu pour un usage domestique, semblable à Beat Saber, pourrait ne pas trouver d'audience viable dans le segment grand public local. En revanche, le succès commercial en Chine, reflétant les tendances plus larges de l'Asie de l'Est, est porté par les expériences d'arcade en dehors du domicile. Ces attractions VR sont omniprésentes, présentes dans les centres commerciaux de presque toutes les grandes villes, allant de simples installations assises à des arènes de tir sur zombies en réalité virtuelle à l'échelle de la pièce. Bien que le matériel de ces arcades ne soit pas toujours de la dernière génération, la densité et l'accessibilité de ces lieux en font le principal moteur de revenus pour le contenu VR.En plus des arcades traditionnelles, les installations VR de grande envergure ont gagné une traction significative. Ces lieux disposent de grandes salles où plusieurs utilisateurs jouent simultanément à des expériences solo, utilisant des avatars en silhouette blanche pour se déplacer les uns autour des autres sans collision. Le secteur B2B reste également actif, l'entraînement en VR revêtant une importance particulière, bien que les investissements aient refroidi avec le déclin de l'engouement initial pour le métavers. Actuellement, l'attention de l'industrie se tourne vers les lunettes intelligentes, qui gagnent en prestige alors que les casques VR perdent une partie de l'attention des investisseurs. De grandes entreprises comme Huawei et Alibaba sont fortement impliquées, la seconde ayant récemment lancé des lunettes équipées d'un suivi oculaire pour améliorer les capacités d'IA. Les acteurs établis comme Rokid et RayNeo élargissent leurs gammes de produits, tandis que de nombreuses startups entrent sur le marché avec des produits de niche, allant des assistants IA à des cas d'usage spécialisés comme la natation.L'essor des lunettes intelligentes est étroitement lié à l'explosion de l'IA en Chine, où des entreprises comme ByteDance développent des modèles de pointe comparables à ceux d'OpenAI, DouBao servant d'équivalent local à ChatGPT. Bien qu'il reste incertain comment les développeurs peuvent pleinement tirer parti de cette poussée vers les lunettes intelligentes, l'infrastructure est en cours de mise en place. Pour les développeurs souhaitant pénétrer ce marché, le conseil le plus crucial est de sécuriser un partenaire local ou un réseau de contacts de confiance. Un partenaire local comprend le paysage réglementaire, les règles non écrites du marché et les nuances culturelles qui peuvent déterminer le succès ou l'échec du lancement d'un produit. Il peut aider à la protection de la propriété intellectuelle, au marketing et à l'adaptation du contenu pour répondre aux réglementations régionales spécifiques. Il existe des entreprises spécialisées capables de prendre un jeu VR occidental, de l'adapter pour le public chinois et de gérer la distribution, y compris son adaptation pour les environnements d'arcade si nécessaire.Fourni par Antony VitilloEn outre, divers accélérateurs et incubateurs, notamment à Hangzhou, accueillent activement les entrepreneurs occidentaux, offrant parfois des fonds régionaux ou des espaces de bureau subventionnés pour les aider à naviguer dans l'écosystème technologique complexe. La confiance est primordiale dans ces relations ; il est conseillé de rechercher des introductions par le biais de réseaux de confiance plutôt que par des approches à froid. La localisation du contenu est tout aussi importante. La distribution de contenu en anglais est inefficace en Chine ; les jeux, les présentations et les vidéos pour les réseaux sociaux doivent être en mandarin. Bien que les outils de traduction par IA s'améliorent, ils restent maladroits et sujets aux erreurs, ce qui rend les locuteurs natifs du mandarin indispensables pour les interactions en personne, en particulier sur les stands de salons professionnels. Les subtilités culturelles comptent également, comme l'a démontré le succès de l'abandon des tutoriels au profit d'un gameplay immédiat lors d'un showcase à Nanchang en 2019, prouvant que les connaissances locales sur les préférences des utilisateurs sont vitales pour l'engagement.
- Public
- 23 Oct, 2026
VRChat ajoute le suivi facial natif au niveau SDK dans la bêta ouverte
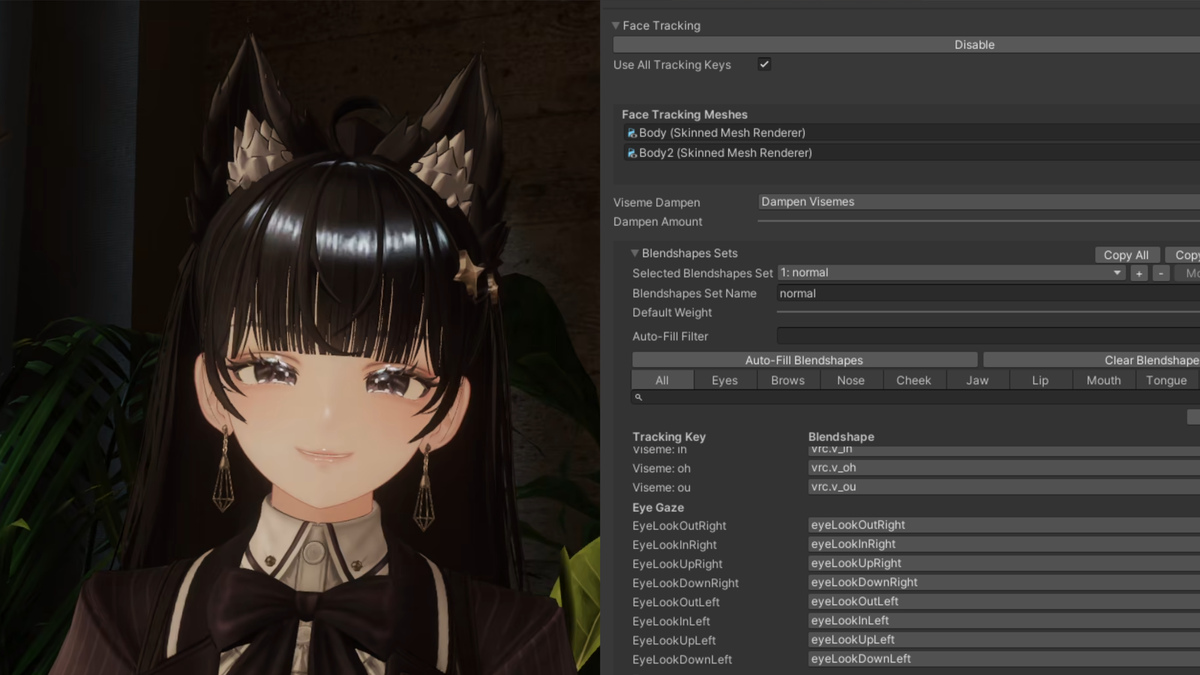
VRChat a introduit la prise en charge du suivi facial natif au niveau SDK pour les avatars dans son client Open Beta et la version bêta de l'Avatars SDK. Bien que la plateforme prenait techniquement en charge le suivi des yeux et du visage depuis des années via Open Sound Control et l'application communautaire VRCFaceTracking, les avatars ne disposaient auparavant pas de capacités natives de suivi facial complet. Les utilisateurs étaient contraints de configurer des modules complémentaires pour obtenir des expressions détaillées, car la prise en charge native se limitait à un regard de base et au mouvement des paupières en utilisant les données de suivi des yeux. Cette nouvelle implémentation supprime cette dépendance, permettant un traitement plus direct et efficace de l'animation faciale au sein de la structure logicielle principale.Le dernier client Open Beta sur Steam et la version 3.10.6-beta.1 de l'Avatars SDK permettent la création de suivi facial au niveau SDK, initialement appelé High Fidelity Face Tracking. Les créateurs peuvent désormais configurer les expressions faciales via une section dédiée dans le composant Avatar Descriptor. Le système associe les expressions aux blendshapes et aux paramètres de l'animateur tout en prenant en charge la norme Unified Expressions de VRCFT. Il s'intègre parfaitement avec les visèmes pilotés par l'audio, le regard et les paupières de VRChat, bien qu'il ne prenne actuellement pas en charge les Blended Shapes ou les Simplified Parameters. Cette intégration native simplifie le processus de création et assure une meilleure compatibilité entre les différentes configurations d'avatars sans nécessiter de configurations externes complexes.Un avantage majeur de cette mise à jour est le suivi facial synchronisé sur le réseau, qui ne consomme pas le budget des paramètres synchronisés de l'avatar. Cette réduction de la charge des paramètres synchronisés entraîne de meilleures performances globales et des expressions faciales plus visuellement cohérentes pour les autres utilisateurs dans l'espace partagé. Le système prend en charge diverses méthodes d'entrée, y compris des protocoles OSC tels que VRCFT dans sa dernière version bêta sur Steam. Il s'intègre également à la fonctionnalité Selfie Expression de VRChat, qui permet aux utilisateurs de reproduire leurs expressions faciales sur leurs avatars sur PC de bureau et appareils Android à l'aide d'une webcam ou d'une caméra frontale, améliorant ainsi l'accessibilité pour ceux qui ne disposent pas de casques VR dédiés.La compatibilité matérielle varie, et peu de casques proposent actuellement à la fois un support matériel et des API tiers pour le suivi oculaire et le suivi facial par caméra. Les options populaires incluent le Pico 4 Pro et Enterprise, le Meta Quest Pro et le Samsung Galaxy XR. Des solutions open source et créées par la communauté existent pour d'autres appareils tels que le Meta Quest 3 et le 3S, tandis que VRCFT peut transmettre des données provenant d'appareils prenant en charge uniquement le suivi oculaire, comme le Bigscreen Beyond 2e. Creator Hash a mis à jour plusieurs paquets d'avatars Booth populaires avec des variantes bêta utilisant cette nouvelle fonctionnalité SDK, permettant aux propriétaires existants de passer immédiatement au système de suivi amélioré.La fonctionnalité Meta VR Glasses à venir offre un support matériel pour le suivi oculaire et le suivi facial par caméra, en utilisant des capteurs dédiés pour les yeux et des caméras orientées vers le bas pour les signaux faciaux. Cependant, Meta ne fournira pas d'accès API tiers à la source de données du suivi facial visuel au lancement, contrairement au Meta Quest Pro. Les développeurs n'auront accès qu'au suivi oculaire et devront s'appuyer sur des sources de données pilotées par l'audio, connues sous le nom d'Audio to Expressions. Le suivi facial par caméra sera réservé à l'usage de première partie, par exemple pour des avatars holographiques réalistes. Cette limitation a provoqué de la frustration parmi les développeurs, et Dilmer Valecillos, Meta Developer Advocate, a reconnu ces retours. Une demande d'API par caméra sur le site Meta VR Developer est actuellement en attente, indiquant un calendrier futur mais non défini pour l'accès des tiers.
- Public
- 23 Oct, 2026
Apple permet aux organisations et aux écoles d'acheter des abonnements en gros
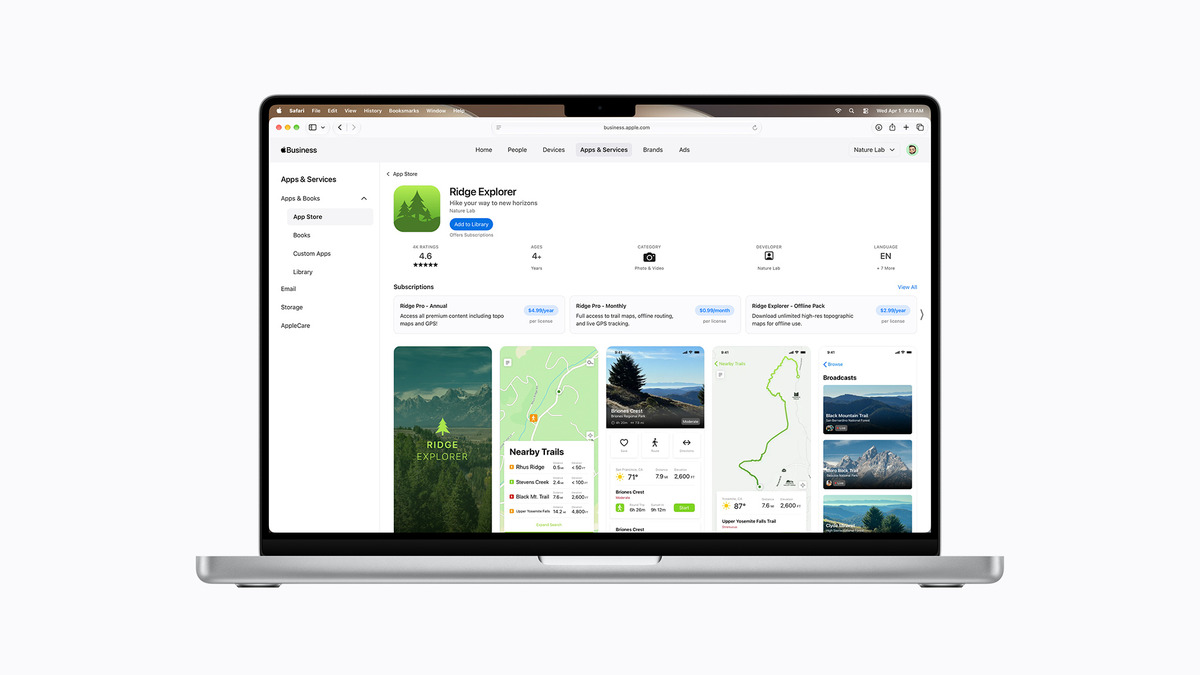
Les organisations et les établissements d'enseignement peuvent désormais acheter des abonnements automatiques d'applications en gros via l'achat multiplaces. Cette capacité est conçue pour les utilisateurs d'Apple Business ou d'Apple School Manager, leur permettant de découvrir et d'acheter des abonnements directement. En achetant le nombre de places requis via un seul Apple In-App Purchase, les organisations peuvent ensuite attribuer et gérer l'accès à l'aide de leurs outils de gestion des appareils existants. Le système offre une flexibilité, permettant aux administrateurs d'ajouter ou de supprimer des places à tout moment pour répondre aux besoins opérationnels actuels, sans renégociations complexes ni transactions séparées pour chaque utilisateur individuel.L'achat multiplaces pour les abonnements est activé par défaut dans App Store Connect, rendant votre abonnement disponible simultanément via Apple Business, Apple School Manager et l'App Store standard. Les développeurs conservent un contrôle total et peuvent ajuster ces options de disponibilité à tout moment pour s'adapter à leur stratégie de distribution. La plateforme prend également en charge les abonnements de groupe, introduisant un nouveau niveau de flexibilité pour l'usage des consommateurs et des petites équipes. À partir du 28 octobre 2026, les développeurs pourront configurer et tester les achats de groupe dans leur compte Apple Sandbox pour se préparer au lancement à venir. Cet hiver, les achats de groupe seront disponibles sur l'App Store, permettant aux utilisateurs d'acheter plusieurs places et d'inviter d'autres personnes à accéder à l'abonnement, élargissant ainsi la portée des modèles économiques basés sur l'abonnement.
- Public
- 23 Oct, 2026
Vector Gear : un casque de réalité virtuelle entièrement ouvert pour les makers et les passionnés
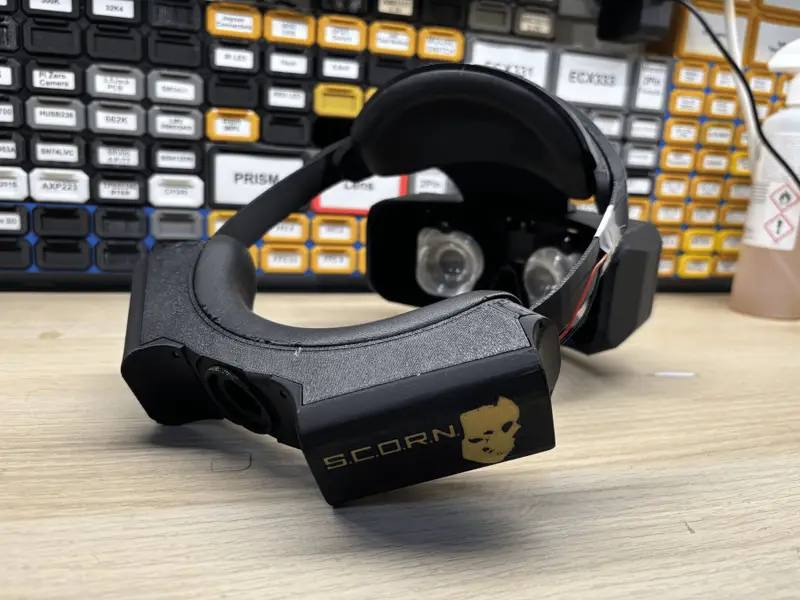
Walker Industries, une équipe de passionnés de réalité virtuelle basée au Japon, a lancé une campagne sur Kickstarter pour le Vector Gear, un casque de réalité virtuelle de milieu de gamme entièrement ouvert. Le projet vise à créer un appareil entièrement personnalisable, avec le matériel et le logiciel mis à la disposition du public. Cette approche permet aux développeurs et aux utilisateurs de modifier tous les aspects du système, du système d'exploitation sous-jacent aux composants physiques. L'entreprise décrit le projet comme la réalisation d'un rêve longtemps caressé : construire un casque non contraint par des restrictions propriétaires, offrant une plateforme transparente pour l'innovation et l'expérimentation dans le domaine de la XR.Le Vector Gear est positionné comme l'appareil phare de la gamme, fonctionnant à la fois en mode autonome et en réalité virtuelle sur PC. À ses côtés, la campagne propose le modèle Andromeda, destiné exclusivement à la réalité virtuelle sur PC et disponible en deux versions : un modèle abordable et une option à plus haute définition. Les spécifications du Vector Gear sont comparables à celles des leaders actuels du marché, tels que le Quest 3, avec des capacités de résolution et de puce similaires. Bien que développé par une petite équipe aux ressources limitées, l'appareil intègre une large gamme de fonctionnalités qui rivalisent avec les offres de grandes entreprises. L'objectif est d'offrir de hautes performances sans les coûts massifs habituellement associés au développement de ce type de matériel.Une caractéristique distinctive du Vector Gear est son système de suivi facial intégré, nommé « Shinra Meisin », développé en interne par l'équipe. Ce système est conçu pour animer les avatars des utilisateurs sur des plateformes sociales de réalité virtuelle comme VRChat en diffusant les données via OSC. De plus, le casque et les manettes utilisent un système de suivi propriétaire appelé « AstroSLAM ». Contrairement au suivi standard de type inside-out, les manettes sont équipées de caméras embarquées, permettant un positionnement polyvalent, même lorsqu'elles sont tenues derrière la tête ou utilisées pour le suivi d'objets sur des accessoires. Ce système de suivi est entièrement compatible avec SteamVR, garantissant une large compatibilité avec les titres PC-VR existants et offrant une base solide pour le développement de nouvelles applications.L'écosystème logiciel est tout aussi ambitieux, centré sur un système d'exploitation personnalisé appelé XRUIOS, basé sur Arch Linux. Conçu spécifiquement pour la réalité virtuelle, ce système d'exploitation permet aux utilisateurs de disposer des objets 3D pour créer des environnements domestiques personnalisés, d'exécuter des widgets et de lancer des applications depuis Steam ainsi que depuis un lanceur personnalisé de Walker. Il intègre FEX, permettant l'exécution d'applications x86 standard sur l'architecture Linux ARM64. Un widget notable est un émulateur MS-DOS, permettant aux utilisateurs de faire tourner des jeux anciens. Le système inclut également le « Yuuko Protocol », un outil multiplateforme qui crée une expérience cohérente entre les appareils, permettant aux utilisateurs de poursuivre sans interruption la lecture de médias ou l'accès aux fichiers entre leur casque, leur smartphone et leur PC.Le Vector Gear est au prix de 980 dollars, tandis que les modèles Andromeda sont disponibles pour 650 et 1 250 dollars, avec des remises pour les versions devkit à assembler soi-même. La livraison est attendue dans le monde entier d'ici mai 2027, bien que des retards potentiels soient reconnus. Le projet s'adresse aux makers, aux passionnés hardcore et aux instituts de recherche qui ont besoin de capacités de personnalisation complètes et de garanties de confidentialité des données. Bien que Steam Frame offre une alternative similaire, mais moins ouverte, le Vector Gear se distingue par sa conception permettant une démontage et une modification complets. Ce niveau d'ouverture en fait un outil unique pour ceux qui souhaitent s'immerger en profondeur dans les couches matérielles et logicielles de la réalité virtuelle, soutenant une approche du développement XR portée par la communauté.
- Public
- 22 Oct, 2026
Unity MethodReload : accélérer les itérations en contournant le rechargement du domaine
Unity a publié MethodReload, un package expérimental conçu pour éliminer les temps d'attente liés aux rechargements de domaine pendant le développement. Traditionnellement, la modification du code de jeu dans l'éditeur force un démontage complet et une réinitialisation du Mono AppDomain, un processus susceptible de briser l'élan créatif. Sur les appareils, la situation est encore plus critique, car IL2CPP ne prend pas du tout en charge le rechargement des domaines, ce qui impose une reconstruction complète du joueur pour chaque modification. MethodReload résout ce problème en permettant aux développeurs de mettre à jour instantanément les corps de méthodes spécifiques, transformant les longues attentes de compilation en une affaire de quelques secondes. Cette capacité est désormais disponible immédiatement, visant à fluidifier la boucle d'itération pour les tests basés sur l'éditeur comme pour les tests sur appareil.Le package, actuellement en version 0.7.0-exp.1, est distribué dans l'espace de noms com.unity.pipeline et nécessite Unity 6.0 ou une version ultérieure. Pour utiliser cette fonctionnalité, les développeurs doivent marquer des méthodes spécifiques avec l'attribut [MethodReload] avant d'entrer en mode Play ou de construire un joueur. Cet attribut doit être présent au moment de la compilation, car la logique de dispatch est tissée directement dans le bytecode de la méthode. Seules les méthodes publiques d'instance ou statiques qui renvoient void ou IEnumerator sont éligibles à ce traitement ; toutes les autres signatures sont ignorées lors du processus de construction avec un avertissement. Cette exigence de précompilation garantit que l'environnement d'exécution peut identifier correctement quelles méthodes sont candidates pour des mises à jour en direct, sans interférer avec le pipeline de compilation standard.Une fois les attributs en place, le processus de travail consiste à démarrer le MethodReload Watcher, situé dans les paramètres du projet sous les sections Pipeline et Editor. Dans l'Editor, l'entrée en mode Play active le système, permettant de compiler et d'injecter en temps réel toutes les modifications apportées au code balisé. Pour les tests sur appareil, les développeurs doivent créer un player de développement avec le pilote Pipeline d'exécution activé et se connecter via le Profiler ou la fenêtre Console. Lorsqu'un fichier contenant une méthode balisée est enregistré, l'Editor le compile en utilisant les définitions du préprocesseur du player et pousse la mise à jour vers tous les appareils connectés. Ce processus ne nécessite aucun redémarrage de l'application, offrant ainsi une boucle de rétroaction fluide. De plus, des commandes Unity CLI sont disponibles pour les flux de travail basés sur le terminal, permettant aux utilisateurs de déclencher des rechargements pour des fichiers ou des dossiers spécifiques directement depuis la ligne de commande.Malgré ses avantages en termes de vitesse, MethodReload fonctionne dans des limites strictes. Il ne modifie que les corps des méthodes balisées, laissant les sites d'appel, les champs et les structures de types intacts. Par conséquent, les développeurs ne peuvent pas ajouter de nouveaux champs ou classes via un rechargement. L'interpréteur exécute un sous-ensemble de C#, excluant certaines fonctionnalités complexes, bien qu'il prenne en charge les types primitifs, les boucles, les délégués et les coroutines. Un analyseur Roslyn inclus dans le paquet signale la syntaxe non prise en charge dans l'IDE. Sur les appareils IL2CPP, l'interpréteur ne peut appeler que les API déjà référencés dans la compilation ; les membres manquants entraîneront des exceptions. De plus, le code interprété s'exécute plus lentement que le code compilé, un compromis qui n'affecte que les compilations de développement. Les compilations de version finale n'incluent pas l'interpréteur, garantissant ainsi aucun impact sur les performances en production.Sous le capot, MethodReload combine l'interprétation IL avec l'intégration au moment de la compilation. Chaque méthode balisée contient un prologue qui vérifie un registre pour la présence d'une surcharge disponible. Si une surcharge existe, l'interpréteur exécute le nouveau bytecode IL ; sinon, le code compilé d'origine s'exécute. Cette architecture permet de compiler l'interpréteur via IL2CPP avec le reste du jeu, lui permettant de fonctionner sur les appareils sans serveurs externes ni ports ouverts. Bien que les outils existants de l'Asset Store offrent une prise en charge complète de C# dans l'Editor, ils échouent sur les compilations IL2CPP. MethodReload comble cette lacune en offrant une solution viable pour l'itération sur les appareils. Pour les développeurs dont les principaux problèmes se situent principalement dans l'Editor, les outils existants peuvent toujours être préférables, mais pour ceux qui ciblent les appareils IL2CPP, MethodReload offre une voie unique et puissante vers des cycles de développement plus rapides.
- Public
- 22 Oct, 2026
Unity CLI : plus de 200 millions d'événements générés par des agents IA
Unity CLI est un binaire unique qui installe et gère Unity depuis le terminal. Avec l'ajout du package Pipeline, il permet aux scripts, aux systèmes d'intégration continue et aux agents de code de piloter une instance d'Editor en cours d'exécution. Depuis juillet, plus de 226 000 utilisateurs connectés ont utilisé cet outil, générant plus de 200 millions d'événements. Les données indiquent un schéma de travail clair : les développeurs configurent l'environnement manuellement, tandis que la majeure partie des tâches opérationnelles est déléguée à des agents automatisés.Du 20 juillet au 13 octobre 2026, environ 98 % des exécutions du CLI provenaient d'agents de code et d'autres outils d'automatisation. La saisie manuelle dans le terminal ne représentait que 0,2 % des événements, tandis que les pipelines CI en représentaient 0,3 %. La petite part restante d'exécutions ne relève pas de ces catégories spécifiques. Cette répartition met en évidence un changement dans les habitudes de développement : le terminal est désormais utilisé principalement pour la configuration initiale et le paramétrage, plutôt que pour une interaction manuelle continue avec le moteur.Lorsque les développeurs interagissent manuellement avec le système, leurs actions se concentrent sur la préparation. Les tâches typiques incluent l'installation du package Pipeline, l'ouverture d'un projet avec la bonne version d'Editor, la connexion et la configuration de l'agent pour qu'il pointe vers Unity. Après avoir configuré la compétence CLI, les développeurs confient le contrôle à l'agent. Cette approche garantit une intégration sans couture de Unity dans l'écosystème d'agent spécifique choisi par le développeur, permettant à l'IA de prendre en charge les tâches suivantes sans friction.La commande unity elle-même représente plus de 80 % de tous les événements enregistrés. Le CLI est principalement utilisé pour exécuter des actions dans un Editor en cours d'exécution, avec des vérifications occasionnelles de son état. Les développeurs ont initié plus de 1,3 million de sessions MCP, le mode utilisé par les agents pour se connecter à Unity via le CLI, et ont ouvert des projets plus de 150 000 fois. Ce volume d'interaction souligne le rôle du CLI en tant que pont central entre les flux de travail pilotés par l'IA et l'environnement de développement Unity.L'utilisation a fortement augmenté après la sortie des plugins officiels Unity pour Claude Code, Codex et récemment Grok. Ces plugins fournissent aux agents des compétences rédigées par les équipes Unity, incluant des capacités spécifiques pour piloter le CLI. La commande unity setup claude installe le plugin nécessaire pour Claude Code, qui fonctionne également dans l'extension VS Code. Les agents sans plugins officiels, tels que Cursor et Cline, peuvent toujours fonctionner via le CLI. Claude Code est l'agent le plus fréquemment utilisé, suivi de Codex, avec les plus grandes bases d'utilisateurs situées aux États-Unis, au Japon, en Corée du Sud et en Allemagne.