La plateforme NVIDIA Minerva AIOps relie la télémétrie des usines IA pour maximiser l'efficacité des GPU
 Public
- 26 Oct, 2026
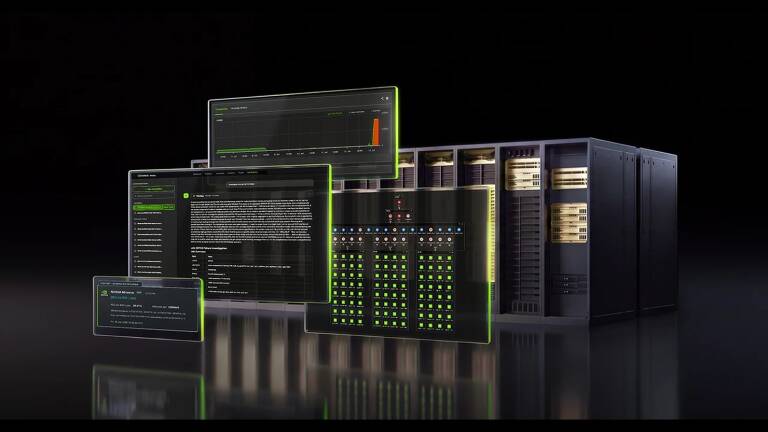
Les usines IA représentent certains des environnements opérationnels les plus complexes jamais créés, où des centaines de milliers de GPU, des réseaux NVIDIA Spectrum-X Ethernet, des réseaux de mise à l'échelle NVLink et des planificateurs distribués fonctionnent en synchronisation continue. Dans l'entraînement distribué synchrone, l'ensemble de la tâche progresse au rythme du rang le plus lent, ce qui signifie qu'un GPU, une interface ou un chemin de commutateur dégradé peut gaspiller du temps utile sur de nombreuses ressources saines. Les pannes qui nuisent au rendement sont souvent subtiles, comme un GPU fonctionnant légèrement plus chaud que ses pairs, un dispositif NVMe perdant en performance sous charge soutenue, ou un commutateur générant des tempêtes de trames de pause. Ces signaux ne dépassent rarement les seuils statiques individuellement, mais collectivement, ils créent des retards, allongent les temps d'étape et retardent les points de contrôle, entraînant des pertes de production significatives.
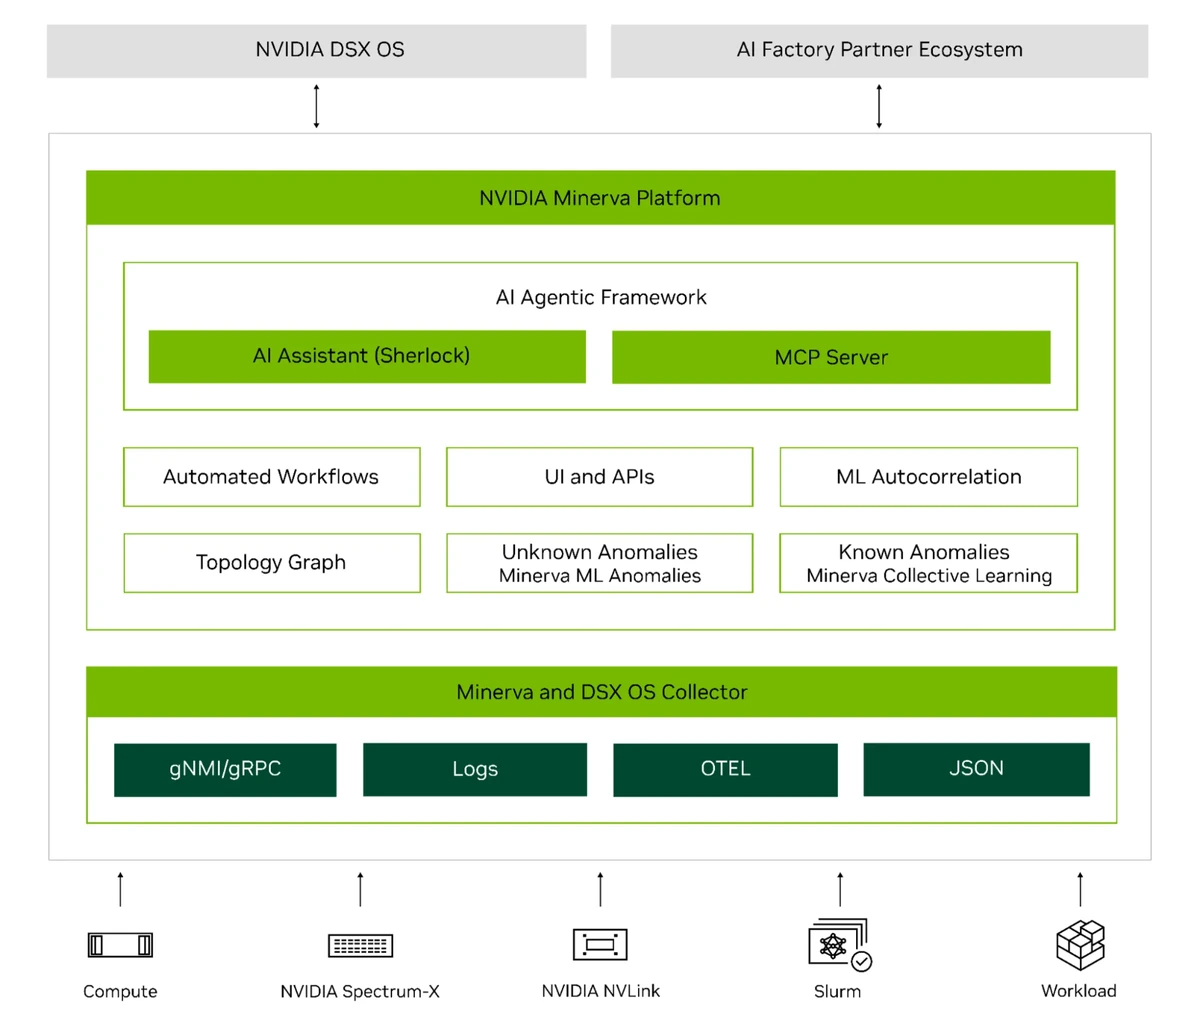
Le diagnostic est encore compliqué par le fait que les preuves sont dispersées entre différentes équipes : les opérateurs réseau voient les compteurs d'interfaces, les opérateurs de calcul voient l'état des nœuds, et les équipes ML voient les variations des temps d'étape. Cette fragmentation transforme le triage en une chaîne de recherches sur les tableaux de bord et de transferts entre équipes, pouvant potentiellement transformer une panne contenue en des jours de temps de production perdus. NVIDIA Minerva comble ces lacunes en collectant la télémétrie sur l'ensemble de la pile et en cartographiant l'infrastructure aux tâches actives dans un graphe de connaissances dynamique. Elle applique un apprentissage automatique sur mesure pour corréler les symptômes dépendants en incidents de haute fidélité. Un assistant propulsé par un agent IA et un serveur MCP connecté à des outils agentiques externes offrent un chemin conversationnel à travers ces données en direct, avec l'objectif principal de préserver les heures GPU effectives et de maintenir le bon déroulement de l'entraînement des modèles.
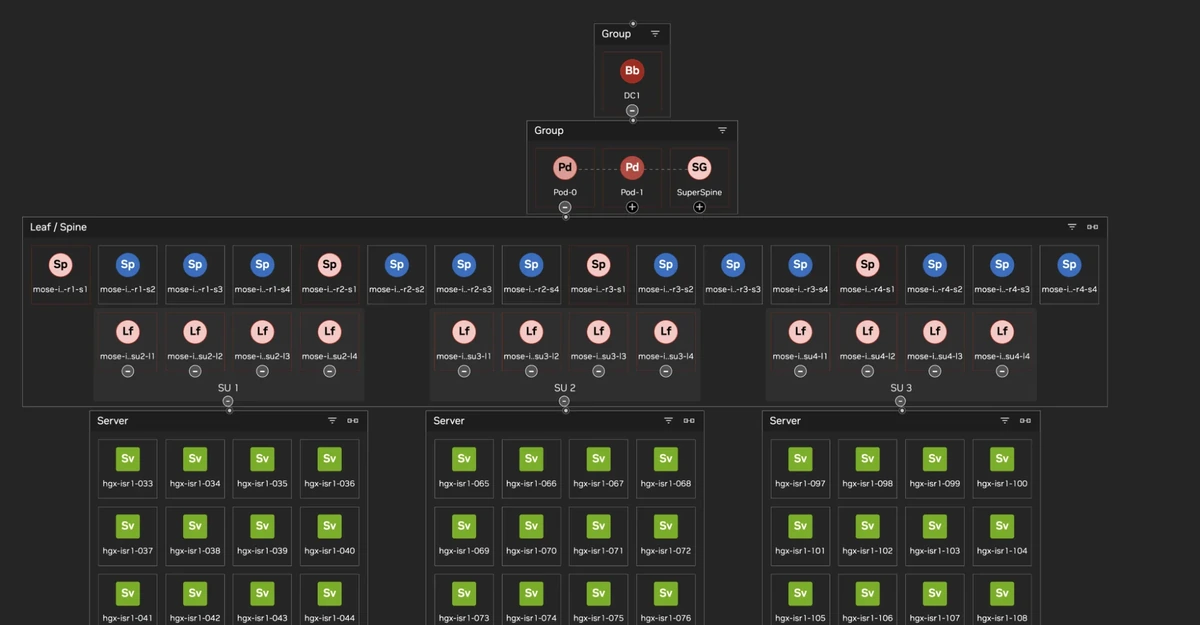
La surveillance basée sur des règles a du mal à gérer les « pannes grises », où les composants restent disponibles mais ne présentent des problèmes que sous charge ou par rapport à leurs pairs. Les seuils absolus manquent souvent ces changements, tandis que les seuils agressifs génèrent du bruit lors des variations normales de charge. L'échelle amplifie ce problème, car une seule panne physique peut produire des erreurs d'interface, des indicateurs de congestion et des changements d'utilisation du GPU qui apparaissent comme des événements non liés sur des tableaux de bord distincts. Minerva ingère les métriques, les journaux et la topologie des GPU, des commutateurs Spectrum-X et NVLink, des SuperNIC, des DPU, du stockage, de NCCL et des planificateurs. L'auto-découverte fournit des relations que la télémétrie brute ne possède pas, créant un graphe de connaissances qui cartographie les éléments de l'infrastructure, du planificateur et des charges de travail. Ce graphe se met à jour dynamiquement au fur et à mesure que les tâches démarrent, s'arrêtent ou que les nœuds sont remplacés, soutenant la navigation depuis une vue d'ensemble de l'usine jusqu'à une interface individuelle.
Le graphe de topologie transforme le parcours d'investigation en permettant aux opérateurs de suivre les anomalies depuis une interface jusqu'à son nœud, son chemin de réseau et son affectation de tâche actuelle. Inversement, les ingénieurs ML peuvent suivre un identifiant de tâche à travers les preuves sur le GPU, l'hôte, la NIC et le commutateur. Minerva traite des milliards de points de données de métriques et de journaux par heure à l'aide de modèles supervisés et non supervisés. La détection supervisée identifie les motifs d'erreurs critiques connus et les associe à des conseils de remédiation, tandis que les modèles non supervisés apprennent les motifs normaux pour les composants matériels ou logiques et les comparent aux pairs pertinents. La comparaison avec les pairs est cruciale car une mesure peut paraître acceptable isolément, mais anormale dans son contexte, par exemple une température de GPU dans les limites de la spécification, mais nettement plus élevée que celle des GPU voisins sous la même charge. Les modèles multivariés combinent température, puissance, fréquences et utilisation pour détecter la dégradation avant une panne complète.
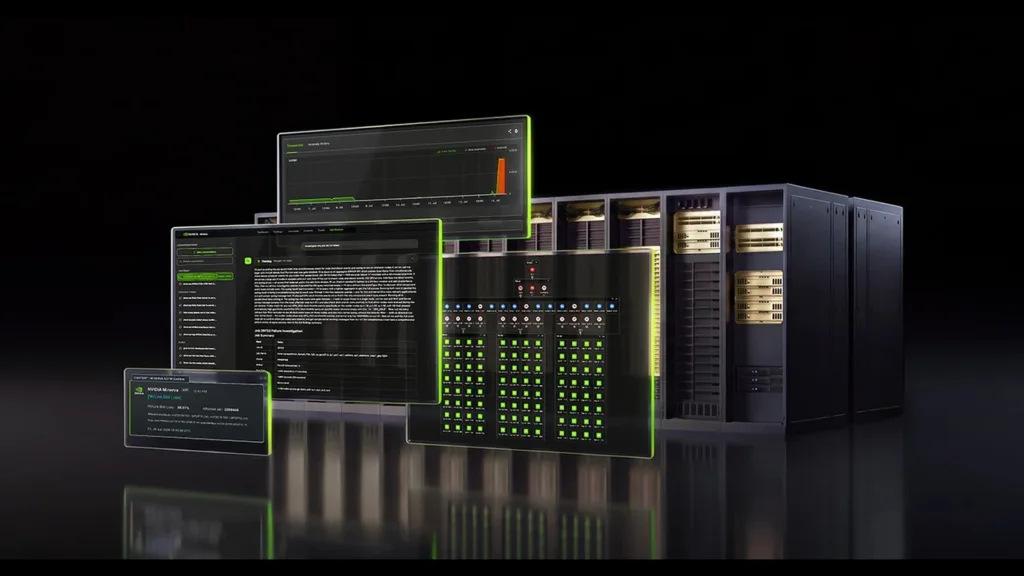
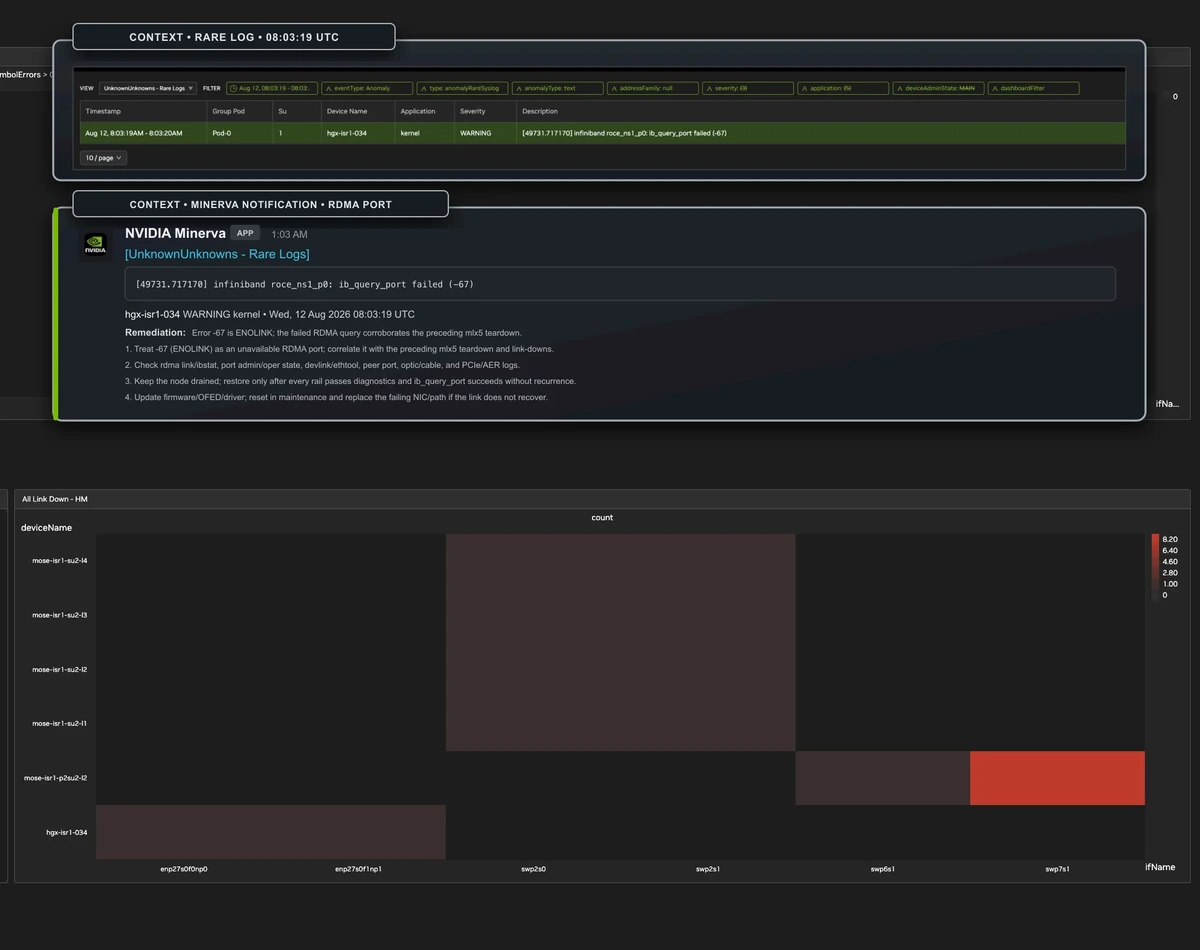
Les journaux reçoivent un traitement similaire, avec une détection d'anomalies basée sur le NLP qui fait émerger des motifs jamais vus auparavant et un appariement supervisé qui identifie les erreurs critiques connues. Les détections peuvent alimenter les flux de travail du planificateur pour drainer les nœuds affectés avant que de nouvelles tâches n'y soient affectées, ou à des intervalles de points de contrôle sûrs. La corrélation tenant compte de la topologie relie la détection à l'action de l'opérateur en exploitant le graphe de connaissances pour déterminer quels événements partagent un chemin de dépendance. Les symptômes en aval sont regroupés en un seul incident plutôt que de concourir pour l'attention, réduisant les événements redondants et les séries de métriques associées en un seul signal avec la topologie et les charges de travail affectées jointes. Les tests de NVIDIA montrent des réductions significatives des événements notifiés et des tickets pour les scénarios pris en charge, permettant aux opérateurs de commencer avec un espace de recherche beaucoup plus restreint pour l'analyse des causes racines.
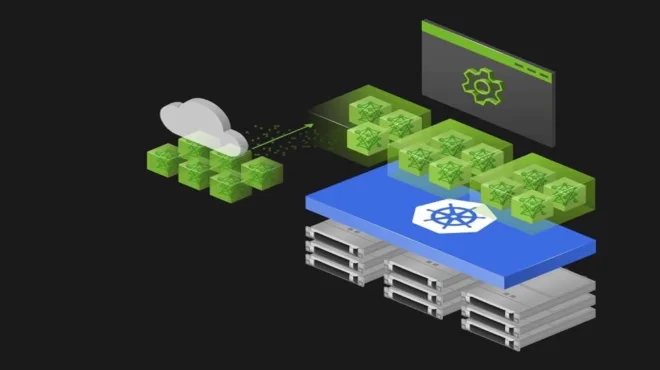
NVIDIA Minerva inclut un agent IA natif nommé Sherlock, ancré dans la télémétrie en direct et le graphe de connaissances, qui permet aux opérateurs d'interroger le système pour l'analyse des causes racines dans un langage humain. Sherlock peut présenter des preuves à l'appui et recommander des mesures de remédiation sans exiger des opérateurs qu'ils connaissent des métriques spécifiques ou des langages de requête, offrant un accès aux connaissances du domaine qui nécessitaient traditionnellement une escalade vers des spécialistes. De plus, le serveur MCP de Minerva permet aux outils agentiques externes d'interroger le même contexte opérationnel, permettant aux équipes d'intégrer les preuves en direct de la fabrique IA dans leurs propres flux de travail. Les actions d'atténuation peuvent rester approuvées par un humain ou être automatisées selon la politique locale et l'évaluation des risques. Dans un grand centre de données IA, Minerva a identifié une connexion NVLink unique parmi 400 000 interfaces perdant de la bande passante, permettant à un SRE de drainer les nœuds affectés et de restaurer la vitesse complète en quelques minutes plutôt qu'en heures.