Limitation de la mémoire GPU par charge de travail dans Kubernetes avec CUDA 13.4 et le planificateur KAI
 Public
- 28 Oct, 2026
Les charges de travail IA nécessitent souvent seulement une fraction d'un GPU, mais l'attribution de dispositifs entiers entraîne une capacité inactive et une utilisation inefficace de l'infrastructure. Les GPU NVIDIA prennent en charge divers mécanismes de partage, y compris Multi-instance GPU (MIG) pour l'isolation matérielle, le time-slicing pour l'exécution séquentielle des processus et Multi-Process Service (MPS) pour l'exécution concurrente dans des espaces d'adresses séparés. Bien que MPS permette le partage des ressources de calcul, il manquait auparavant de limites de mémoire strictes. CUDA 13.4 comble cette lacune en introduisant un nouveau mode de partage temporel qui applique des limites de mémoire de manière transparente pour l'application, garantissant que chaque charge de travail fonctionne dans des contraintes de mémoire définies sans nécessiter de modifications de code.
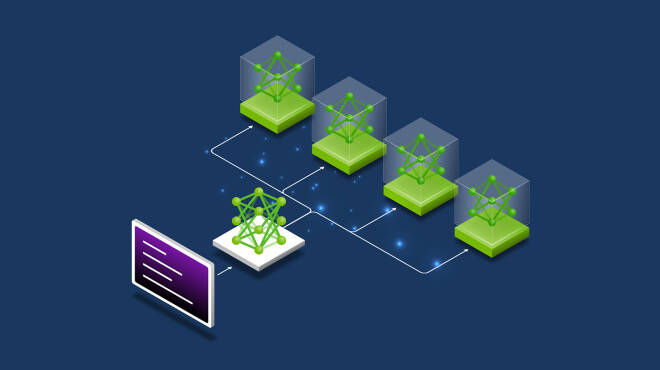
La mise en œuvre de ces fonctionnalités dans un cluster Kubernetes nécessite une coordination au niveau des nœuds, indépendante du planificateur. L'opérateur open source gpu-fractioning, hébergé sous l'organisation KAI Scheduler sur GitHub, fonctionne en parallèle avec NVIDIA GPU Operator pour gérer cette configuration. Il remplit trois fonctions essentielles : lire les annotations des pods pour déterminer les besoins en mémoire et en calcul, configurer les GPU attribués pour imposer ces limites et gérer la transition entre les différents modes de partage. Cet opérateur garantit que le matériel respecte les limites logiques définies par le planificateur du cluster, comblant ainsi l'écart entre les décisions de planification de haut niveau et l'exécution de bas niveau sur les GPU.
Le processus commence par la spécification des besoins en ressources et des modes par les développeurs via les annotations YAML des pods. Le planificateur sélectionne ensuite les GPU appropriés, enregistre l'allocation de mémoire et le mode de partage du calcul dans les annotations des pods pour chaque conteneur, puis affecte la charge de travail. L'opérateur gpu-fractioning lit ces annotations et configure les GPU en conséquence. Tout planificateur Kubernetes capable d'écrire ces annotations peut imposer des fractions de GPU, à condition de respecter deux règles : sélectionner des GPU disposant d'une mémoire libre suffisante et éviter de mélanger les modes de calcul sur un même appareil. KAI Scheduler est le premier à intégrer cette fonctionnalité, introduisant un mode de partage de GPU appelé NvFractions à partir de la version v0.18.0.
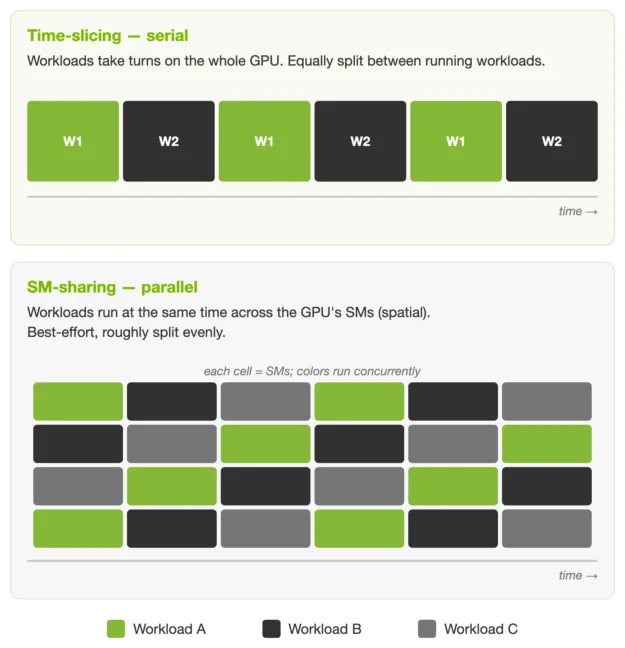
Le mode NvFractions de KAI Scheduler permet aux administrateurs de définir des charges de travail fractionnaires à l'aide de quatre annotations clés qui gèrent les requêtes de mémoire, les limites de croissance, les modes de partage du calcul et le nombre d'appareils. Les requêtes de mémoire peuvent être spécifiées comme des tailles absolues en utilisant les unités standard de Kubernetes ou comme des fractions d'un GPU à l'aide de l'annotation gpu-fraction. Une nouvelle fonctionnalité permet aux charges de travail de déclarer une requête minimale garantie et une limite de pic maximale, cette dernière étant facultative et prenant par défaut la valeur de la requête si elle est omise. Les limites de fraction doivent dépasser gpu-fraction et rester inférieures à 1. Le partage du calcul est désormais explicite et défini par conteneur, permettant de choisir entre sm-sharing et time-slicing.
Un GPU partagé fonctionne dans un seul mode de calcul à la fois, c'est pourquoi KAI Scheduler empêche le placement de charges de travail avec des modes différents sur le même GPU, bien qu'un seul nœud puisse héberger les deux modes sur des appareils distincts. Pour les configurations multi-GPU, l'annotation gpu-fraction-num-devices spécifie le nombre d'appareils sur lesquels s'étend la charge de travail, la requête de mémoire s'appliquant individuellement à chaque appareil. Par exemple, une requête de 40Gi avec quatre appareils alloue 40Gi sur chaque GPU. Cette configuration est idéale pour les serveurs d'inférence qui nécessitent une mémoire garantie par GPU et peuvent augmenter leur utilisation lorsque les voisins sont inactifs, en utilisant sm-sharing pour les charges de travail de confiance exécutées simultanément dans un même domaine d'erreurs.
En revanche, le time-slicing convient au développement ou aux tâches par lots, telles que les notebooks et les petits runs de fine-tuning, où l'isolement est préférable. Dans ce mode, chaque charge de travail reçoit son propre domaine d'erreurs, ce qui signifie qu'un plantage dans une tâche n'affecte pas les autres. Une charge de travail peut demander la moitié de deux GPU avec une limite de croissance jusqu'à 80 % lorsque la mémoire est disponible. L'exécution de nvidia-smi à l'intérieur du conteneur affichera la part fractionnaire de mémoire pour chaque GPU attribué. Les deux outils, KAI Scheduler et l'opérateur gpu-fractioning, sont disponibles sur GitHub sous l'organisation KAI Scheduler, avec des guides détaillés d'installation et de configuration pour tous les mécanismes de partage.