Blog
 Public
- 24 Sep, 2026
Gafas Meta VR: un visor de 100 gramos con un módulo de cómputo independiente
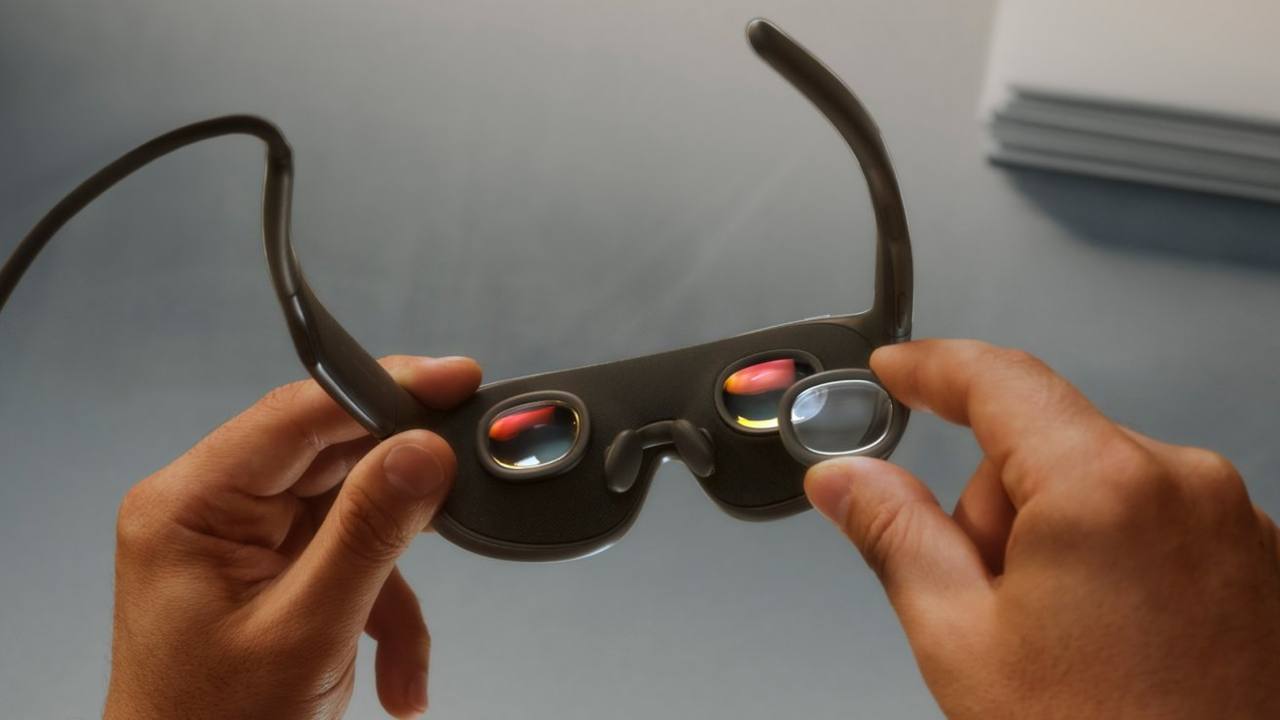
Meta ha presentado las Meta VR Glasses, un dispositivo que la compañía define como el comienzo de una nueva era para la realidad virtual. El visor, que saldrá a la venta en primavera de 2027, pesa unos 100 gramos y reúne en un formato similar al de unas gafas un cine, un espacio de trabajo y una consola. No hay correas ni componentes pesados en el rostro: los laterales abiertos y la cámara de passthrough permiten ver lo que ocurre alrededor, tanto si estás viendo una película completa como si trabajas en una pantalla privada durante un vuelo largo.La ligereza del diseño se logra gracias a un sistema de dos partes. Las gafas se encargan de los sensores y la pantalla, y su estructura de aleación de magnesio aporta rigidez, resistencia y disipación del calor. Un módulo independiente, conectado mediante un cable óptico, se ocupa del cómputo, la batería y el almacenamiento, y se sujeta al bolsillo o a la bolsa. El resultado es un visor cinco veces más ligero que el Meta Quest 3.La pantalla es una 5K Infinite Display con paneles micro-OLED y una densidad de 37 píxeles por grado, lo que mantiene el texto nítido y legible. Las lentes pancake ultracompactas, creadas específicamente para este dispositivo, ofrecen una nitidez de calidad cinematográfica en un formato del tamaño de unas gafas. Dolby Vision se encarga de un color y un contraste intensos, y el audio espacial Dolby Atmos está integrado directamente en la montura.Meta AI está integrada en el sistema operativo, de modo que se puede reproducir una película, abrir aplicaciones, ajustar el espacio de trabajo o buscar mediante la voz, el seguimiento ocular y gestos naturales de las manos, sin necesidad de mandos. El visor funciona con el procesador Qualcomm Snapdragon Reality Elite, que garantiza una carga rápida y una alta eficiencia. La batería del módulo dura hasta tres horas de reproducción continua en alta resolución y admite carga rápida de 45 W.Para juegos y trabajo, las gafas Meta VR admiten en el lanzamiento más de 75 títulos con control solo por gestos, acceso completo a todo el catálogo de Quest y compatibilidad con los mandos Touch Plus. Xbox Cloud Gaming transmite cientos de juegos a través de un mando Bluetooth, y es posible conectar un Mac o un PC con Windows por Wi-Fi o mediante USB-C. Cualquier mesa se convierte en un teclado y un panel táctil, y el passthrough a todo color mantiene a la vista el teclado real y el escritorio mientras se trabaja.Las gafas Meta VR saldrán a la venta en la primavera de 2027 por 1299,99 USD. La plataforma presenta además Hologram, una copia digital fotorrealista del usuario en tiempo real para videollamadas con las manos libres. El audio espacial sitúa la voz del interlocutor en el espacio tridimensional, y la función se puede usar en diversas aplicaciones de llamadas, desde WhatsApp hasta Zoom.
- Public
- 24 Sep, 2026
Renderizado y animación de cientos de miles de bloques con RenderMeshPrimitives
Una imagen se puede dividir en un enorme conjunto de bloques de colores mediante Graphics.RenderMeshPrimitives y después animarla con olas, ensamblaje, repulsión y colapsos a una tasa de fotogramas jugable. El enfoque comienza convirtiendo la textura original en una lista de datos de posición y color de cada bloque. Se define el número horizontal de bloques gridWidth, y el recuento vertical se deriva de la relación de aspecto de la imagen: así los píxeles originales se submuestrean a intervalos regulares, mientras que los píxeles totalmente transparentes y casi negros se omiten como fondo.Cada bloque se almacena en una estructura PixelBlock con los campos float3 position y float4 color, que replica exactamente la disposición de HLSL. En Awake método texture.GetPixels32 lee la imagen de origen, y el bucle for por las coordenadas de la cuadrícula asigna a cada celda de la cuadrícula un píxel de origen, desplazando las posiciones para que el centro de la cuadrícula quede en el origen de coordenadas. Los bytes de color se dividen entre 255 y se convierten en valores de 0 a 1. Una primera pasada ingenua crea un GameObject por bloque con una malla, un material y un MaterialPropertyBlock, pero con unos 100 000 bloques todo se desploma a 6 FPS, porque cada objeto añade comandos de dibujo y costes adicionales de componentes.La solución es Graphics.RenderMeshPrimitives Una API creada específicamente para dibujar muchas veces la misma malla. Los datos de las instancias se cargan una sola vez en GraphicsBuffer (GraphicsBuffer.Target.Structured, sizeof(float) * 7 por elemento), luego SetData(blocks) transfiere todo el array de la CPU a la GPU con una sola llamada. El argumento stride debe coincidir con el tamaño de la estructura HLSL y hay que actualizarlo si cambian los campos. Una única llamada a Graphics.RenderMeshPrimitives(renderParams, cubeMesh, 0, blocks.Length) renderiza todo mientras el shader obtiene la posición y el color mediante SV_InstanceID. worldBounds debe ser lo bastante grande para contener todos los bloques: si es demasiado pequeño oculta bloques, y si es demasiado grande anula el culling; el búfer conviene liberarlo en OnDisable, para evitar fugas.Con aproximadamente 100 000 bloques, la versión con GameObject subió hasta 54 525 llamadas de dibujo y unos 6 FPS, mientras que la versión con RenderMeshPrimitives se mantuvo en 42 llamadas de dibujo para toda la escena y alcanzó entre 700 y 865 FPS. Al escalar aproximadamente diez veces, hasta 1,04 millones de bloques, las llamadas de dibujo se quedaron en 42 y la tasa de fotogramas se mantuvo en torno a 435 FPS; las cifras proceden de la ventana Statistics de Unity. Dado que el desplazamiento se lee desde el búfer en el lado de la GPU y la CPU emite una sola orden de dibujo, el coste sigue siendo bajo incluso cuando crece el número de bloques.La animación sigue dos caminos según si hace falta el estado del fotograma anterior. El movimiento definido solo por el tiempo se ejecuta por completo en el shader de vértices: una onda añade sin a lo largo de Z, usando _WaveAmplitude, _WaveFrequency y _WaveSpeed, mientras que un efecto de ensamblaje interpola desde una posición dispersa hasta la posición original, controlado por el valor _Progress. Las direcciones de dispersión se obtienen de GenerateHashedRandomFloat con clave por ID de instancia, por lo que son deterministas y no requieren estado almacenado, mientras que los umbrales de inicio, desplazados según la altura, hacen que la imagen suba desde la parte inferior.Para los movimientos que arrastran velocidad o posición entre fotogramas se usa, en cambio, un compute shader. Un efecto de imán almacena las posiciones actuales en un búfer de lectura y escritura y repele los bloques cercanos al cursor; después, en cada fotograma, interpola (lerp) las posiciones hacia sus objetivos antes de dibujar la actualización. Un colapso por gravedad integra la velocidad en cada fotograma en un búfer BlockState, rebotando al aterrizar con _Restitution y entrando en reposo cuando la velocidad cae por debajo de _SleepThreshold; _DeltaTime limitado a 1/30 de segundo para evitar que la integración se descontrole, y con las posiciones de reposo calculadas de antemano a partir de la densidad por columna.
- Public
- 24 Sep, 2026
DLSS 5 lleva a los desarrolladores de juegos el renderizado neuronal guiado por 3D
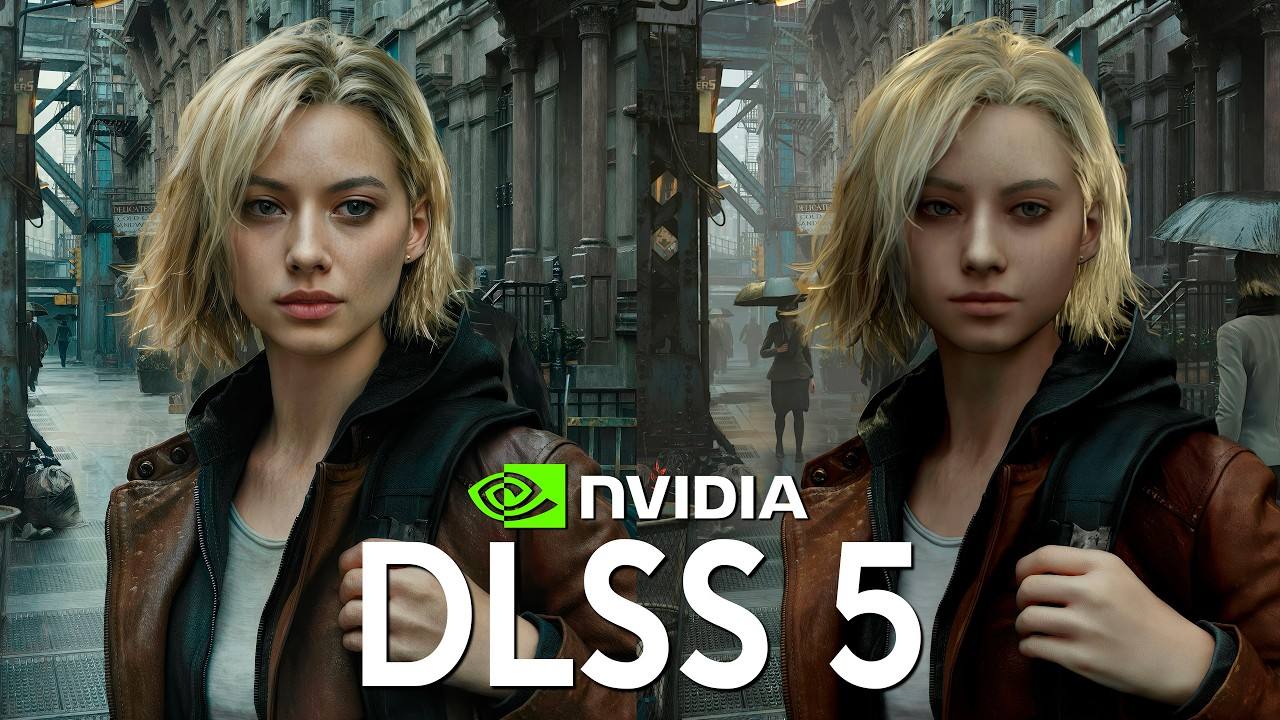
DLSS 5 presenta 3D-Guided Neural Rendering, una nueva etapa final que amplía el pipeline gráfico con una pasada de renderizado neuronal. Como base se toma el fotograma renderizado por el motor, junto con la geometría, las texturas y los búferes de iluminación creados por los artistas, y esa base permanece inalterable. El fotograma del motor define lo que debe conservarse, mientras que los desarrolladores deciden qué puede cambiar. A partir del color del fotograma y de los vectores de movimiento, el modelo añade iluminación realista y detalle de materiales sin alterar la estructura de la escena, la identidad de los personajes ni la intención artística.Diseñado específicamente para el renderizado 3D en tiempo real, DLSS 5 ofrece un resultado determinista y estable en el tiempo. Funciona con un esquema estricto de «un fotograma de entrada, un fotograma de salida», usando los vectores de movimiento del motor del juego, por lo que la imagen se mantiene coherente cuando el jugador se mueve. El modelo compacto y especializado se ejecuta localmente en una sola tarjeta gráfica GeForce RTX 50 Series con resolución de hasta 4K.Figura 1. DLSS 5 aprende a preservar la intención artística, manteniendo la identidad del personaje, la semántica de la escena y de la iluminación, así como la composición del fotogramaDLSS 5 ya está disponible en NBA 2K27, el juego de Visual Concepts publicado por 2K, en todas las GPU GeForce RTX 50 Series de escritorio y portátiles. Los suscriptores de GeForce NOW Ultimate también pueden probar la tecnología al jugar en la nube en servidores de NVIDIA con GPU GeForce RTX 5080. Visual Concepts utiliza controles generales de tono y estilo, además de una máscara de refuerzo por píxel, para ajustar con precisión el detalle de los personajes sin perder su parecido con los jugadores reales. En NBA 2K27, DLSS 5 conserva la geometría facial escaneada y, al mismo tiempo, mejora la dispersión subsuperficial de la piel, la transmisión de la luz a través del cabello y las orejas, y las sombras de contacto.Además de DLSS 5, el anuncio incluye actualizaciones de NVIDIA ACE y del RTX Kit. NVIDIA ACE amplía el flujo de procesamiento de voz y el framework de inferencia para crear personajes conversacionales en los juegos, y el SDK NVIDIA In-Game Inferencing (NVIGI) permite la ejecución en el mismo proceso en C++ para desplegar modelos de IA locales junto con los gráficos del juego. RTX Mega Geometry SDK se ha actualizado a la versión 2.0, con compatibilidad para la transmisión en streaming de clústeres continuos de nivel de detalle para mallas de alta densidad, algo que se muestra en la recién publicada versión glTF con texturas de Zorah. RTX Mega Geometry llegará pronto a Gears of War: E-Day.
- Public
- 22 Sep, 2026
Unity Simulation Pro llega a Early Access para tareas de robótica
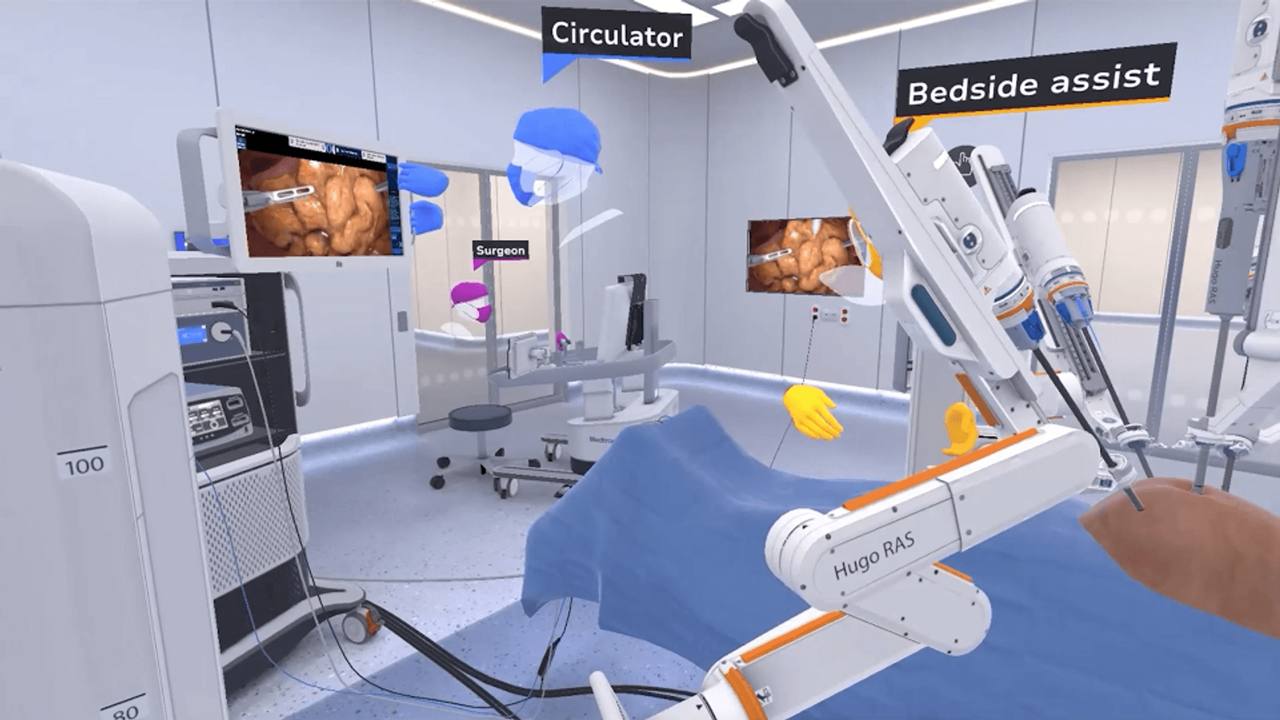
Unity ha lanzado Unity Simulation Pro en Early Access, un paquete de simulación para robótica dirigido a los equipos que crean y validan sistemas robóticos. El paquete es compatible con Unity 6.3 y versiones posteriores, y requiere una licencia Unity Industry. La idea es reunir en un mismo lugar lo que antes los equipos tenían que hacer por su cuenta: reconstruir a mano la descripción física de un robot, escribir sensores desde cero y mantener integraciones con estándares abiertos como ROS. Al reunir todo esto en un único conjunto de herramientas con soporte oficial, Unity Simulation Pro busca reducir el tiempo dedicado a la infraestructura de simulación, para que los equipos puedan centrarse en validar los propios sistemas robóticos.El paquete abarca una amplia gama de tareas: simulación de sensores, entrenamiento de robots y puesta en marcha virtual. Unity lo presenta como una base para llevar los robots del laboratorio al mundo real, construida sobre renderizado en tiempo real, física precisa y simulación de sensores. Los primeros usuarios destacan aplicaciones distintas. TIER IV utilizó su simulador de código abierto AWSIM, basado en Unity, para probar, validar y optimizar el software de conducción autónoma Autoware. Los escenarios de AWSIM pueden exigir el funcionamiento simultáneo de ocho o más cámaras, algo que las técnicas de optimización estándar no lograban manejar. En su lugar, el equipo desarrolló optimizaciones propias: renderizado escalonado entre cámaras para suavizar los picos de fotogramas, control de la escala de tiempo para asignar más recursos a cada fotograma, optimización de assets y la posibilidad de usar distintos pipelines de renderizado dentro de un mismo proyecto, equilibrando precisión y tasa de fotogramas.TIER IV también se apoyó en el sistema de trabajos (job system) de Unity y en la física integrada para mantener el rendimiento en tiempo real en la simulación de vehículos, tráfico y peatones. Para las pruebas hardware-in-the-loop, el equipo analizó los paquetes de datos sin procesar de los sensores y reprodujo una salida equivalente desde Unity. Así, las configuraciones de cámaras se podían probar en el bucle antes de instalarlas en un vehículo de pruebas real, lo que redujo las horas de uso del vehículo de pruebas y el coste de las pruebas en carretera. Por su parte, el Instituto Coreano de Tecnología Industrial (KITECH) construyó un gemelo digital de una planta de fundición a partir de escaneos de nubes de puntos, con el fin de generar datos de entrenamiento para una IA que comprende la proximidad entre humanos y robots en una planta de producción. El equipo añadió encima sistemas de física, sensores y simulación, utilizó un montaje de sensores con componentes personalizados que replicaban el real, de modo que todas las observaciones compartieran un único reloj de simulación, y aprovechó los componentes Articulation Body para reproducir trayectorias de articulaciones grabadas, calculando de forma conjunta la inercia y los contactos.Esa fidelidad física permitió a KITECH generar automáticamente más de 100 000 fotogramas de entrenamiento ya etiquetados en 14 semanas. Esto evitó tener que escenificar manualmente escenarios peligrosos de proximidad en una planta de fábrica en funcionamiento y, al mismo tiempo, favoreció una transferencia fiable de la simulación a la realidad. Medtronic construyó en Unity un flujo de registro y reproducción de datos en torno a un gemelo digital de su sistema de cirugía asistida por robot Hugo, con el que capturó 195 procedimientos en cinco sedes de todo el mundo. Las grabaciones se convirtieron en un conjunto de datos reutilizable: los ingenieros podían cargar un procedimiento grabado, recorrerlo, aislar un momento e inspeccionarlo desde cualquier ángulo. Los mismos datos alimentaron además repeticiones deterministas que se usaron para entrenar nuevos modelos de IA y para orientar el diseño de dispositivos de próxima generación.Unity señala que le interesan especialmente los equipos que ejecutan a gran escala la validación de robots, las pruebas de sensores o la generación de datos sintéticos en los sectores de fabricación, logística, almacenamiento y robótica avanzada. El equipo de desarrollo invita a enviar comentarios en Unity Discussions.
- Public
- 22 Sep, 2026
NVIDIA Isaac ROS 5.0 incorpora flujos de trabajo agénticos y compatibilidad con ROS Lyrical al desarrollo de robótica
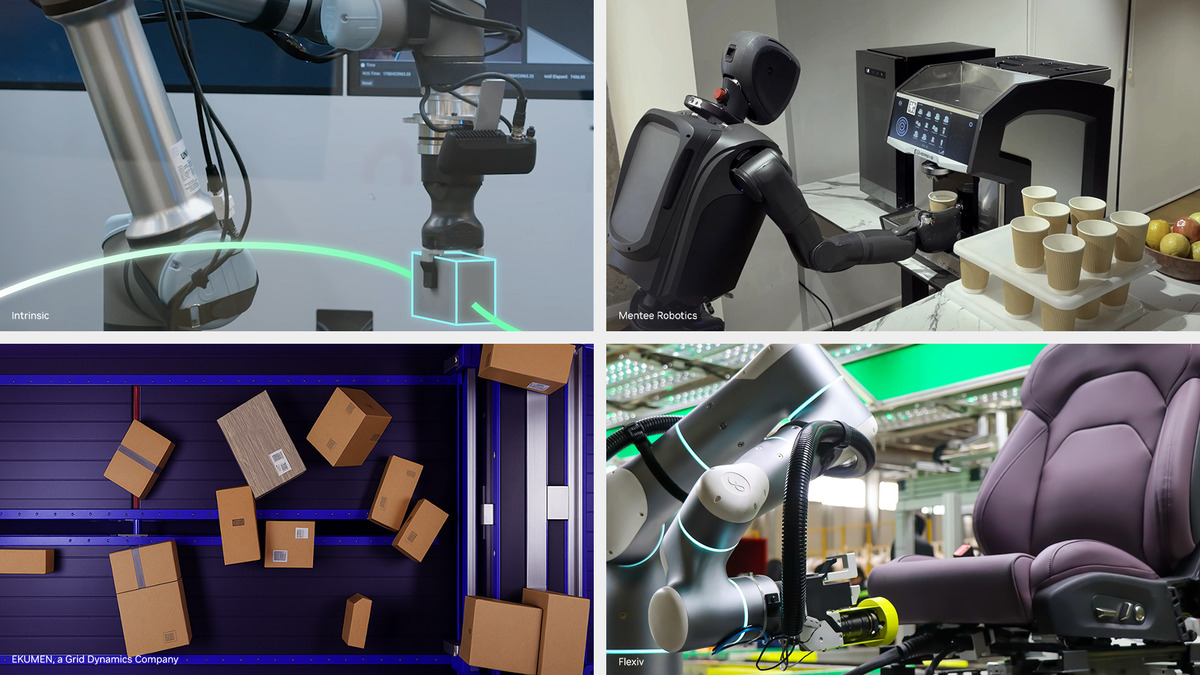
NVIDIA ha lanzado Isaac ROS 5.0, un conjunto de paquetes con aceleración por GPU basados en el framework de código abierto ROS. El anuncio tuvo lugar en la conferencia ROSCon de Toronto. El lanzamiento está dirigido a un amplio público de desarrolladores: ofrece a casi 1,3 millones de usuarios de ROS acceso a la computación acelerada de NVIDIA, a modelos de IA física y a bibliotecas listas para producción, lo que permite crear aplicaciones de robótica de alto rendimiento con herramientas gratuitas y de código abierto.El tema central de la actualización es el desarrollo agéntico: los agentes de IA ahora también participan en la creación de robots. Isaac ROS 5.0 incorpora «habilidades» reutilizables para la configuración y la manipulación, que pueden usar tanto los desarrolladores como los agentes de IA, además de documentación preparada para agentes, de modo que las herramientas y los flujos de trabajo resulten más fáciles de entender para la IA. La idea es convertir más rápido la intención del desarrollador en aplicaciones funcionales: automatizar tareas repetitivas y ayudar a orientarse en bases de código complejas.Algunas de estas habilidades van más allá de la simple asistencia en la escritura de código. Una nueva habilidad de ajuste fino de FoundationStereo permite que un agente de IA adapte un modelo de percepción estéreo a las cámaras, el entorno y la aplicación específicos de un desarrollador. FoundationPose, un modelo base para la estimación y el seguimiento de la pose de objetos, ahora incluye una biblioteca de inferencia lista para agentes, gracias a la cual los robots perciben y siguen la posición y la orientación de los objetos hasta 5,5 veces más rápido. La habilidad de pick and place, que conecta la detección, la estimación de profundidad y la salida de la pose, también está disponible como habilidad independiente para agentes.En cuanto a la plataforma, Isaac ROS 5.0 incorpora compatibilidad con ROS Lyrical y Ubuntu 24.04, lo que ofrece a los desarrolladores un camino hacia la plataforma ROS más reciente sin renunciar a la aceleración por GPU. NVIDIA, junto con la Open Source Robotics Alliance, aportó a ROS Lyrical una interfaz estándar de gestión de datos para que el software de robótica funcione de forma eficiente en distintos equipos, incluidas las GPU, con CUDA como ejemplo práctico. La compatibilidad de cómputo escala desde el básico Jetson Orin Nano hasta los dispositivos de alto rendimiento Jetson Thor.Intrinsic utiliza FoundationPose para el reconocimiento fluido de objetos en su solución Open Machine Tending.El ecosistema ya está adoptando este enfoque agéntico. Intrinsic Open Machine Tending Solution, parte del recién lanzado Intrinsic Core, incluye compatibilidad integrada con FoundationPose para el registro, el seguimiento y la estimación de la pose de objetos listos para usar, lo que reduce la necesidad de sujeciones físicas rígidas. Entre los demás socios se encuentran reBot Arm de Seed Studio, Magna, el gestor de paquetes Pixi de Prefix.dev, Foxglove, Flexiv Rizon 4, Ekumen, las cámaras Stereolabs ZED de Ouster, MenteeBot de Mentee Robotics, el SDK AI Accelerator de Universal Robots, ROBOTIS, FieldAI y Noble Machines. Ekumen, por ejemplo, utiliza isaac_ros_cumotion en una GPU para trazar una trayectoria sin colisiones para un brazo de almacén en aproximadamente 2-5 milisegundos.Isaac ROS 5.0 ya está disponible, es gratuito y de código abierto, y los detalles y las instrucciones para empezar se encuentran en GitHub.
- Public
- 21 Sep, 2026
Meta lanzará gafas inteligentes sin cámara en medio de la creciente preocupación por la privacidad
Según informa The Information, Meta prepara una nueva línea de gafas inteligentes que prescinden por completo de la cámara. Los micrófonos y los altavoces seguirán estando, pero el botón físico que en los modelos actuales inicia la grabación de vídeo pasará a activar una conversación con el chatbot Meta AI o con Muse, el agente de IA que la empresa presentó hace poco. Este cambio elimina el hardware de captura de imagen que ha hecho que el formato actual de estas gafas sea tan controvertido.Todos los modelos actuales de gafas inteligentes de Meta incorporan un LED blanco en el extremo de una de las patillas: parpadea al capturar imágenes y emite pulsos mientras se graba vídeo. Con la excepción de las Ray-Ban Stories de 2021, ya descatalogadas, todos los modelos se niegan a grabar si el LED está tapado, gracias a un sensor de luz ambiental integrado en él. El problema es que mucha gente ni siquiera sabe que existen gafas con cámara, por lo que el indicador pasa fácilmente desapercibido en exteriores a plena luz del día. Ese punto ciego permite a personas malintencionadas grabar a los transeúntes sin su consentimiento ni conocimiento.Incluso ha surgido un mercado secundario en el que se desmontan físicamente las gafas para quitar el LED. Meta ha respondido con actualizaciones de firmware que desactivan la cámara cuando se detecta una manipulación, pero sigue siendo un juego del gato y el ratón con los hackers de hardware. La compañía afirma que menos del 0,1 % de las unidades vendidas han sido manipuladas, lo que aun así equivale a unas diez mil unidades, dado que Meta y su socio EssilorLuxottica ya han vendido más de diez millones. La grabación encubierta, ya sea para contenido en redes sociales, por perversión personal o, en ocasiones, para filmar a la policía, ha impulsado peticiones de prohibir el producto por completo, y los críticos las han bautizado como «gafas espeluznantes».Sin cámaras, según Meta, los nuevos modelos podrán adoptar un diseño más estilizado, con patillas más finas, y parecerse más a unas gafas normales. También deberían llegar a un precio más bajo y atraer a compradores que buscan comodidad o que simplemente quieren evitar el estigma social de llevar una cámara. La contrapartida es evidente: sin visión, la IA integrada ya no puede ver lo que ve quien las lleva, lo que limita su utilidad. El mismo informe añade que Meta podría presentar en Connect su visor de próxima generación con Codec Avatars de cuerpo completo.
- Public
- 21 Sep, 2026
Acute Immersive: aplicaciones white-label de visionOS para vídeo inmersivo
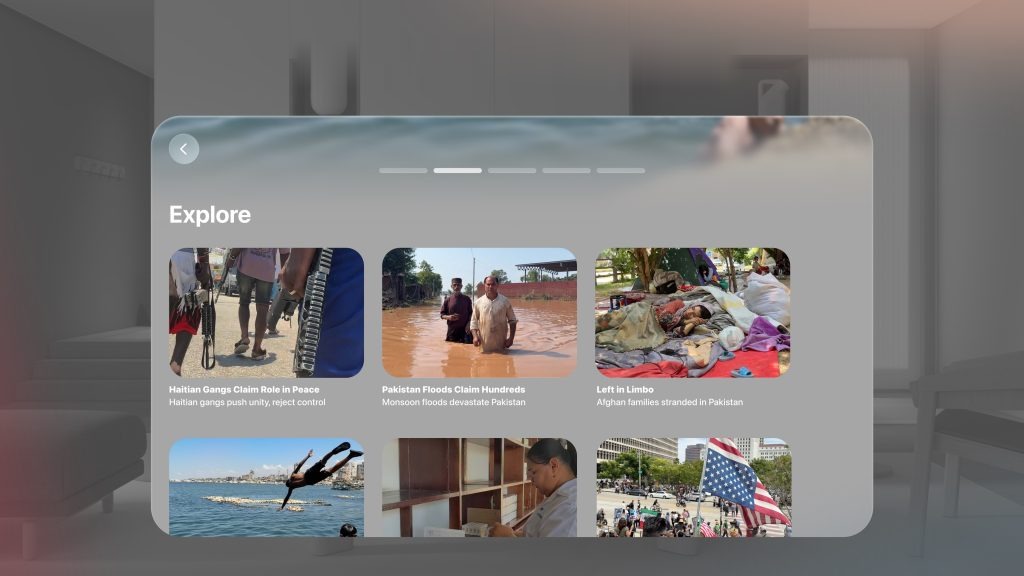
Acute Immersive es una plataforma de publicación que permite a las empresas lanzar su propio espacio de vídeo inmersivo en Apple Vision Pro, en lugar de depender de aplicaciones compartidas como Apple TV, Amplium, Fovii o Theatre. Desde su lanzamiento el año pasado, ha ayudado a llevar al mercado Primary: News in Depth, ganador del Apple Design Award 2026 en la categoría Social Impact, y Blue Frog Immersive. Para las revisiones privadas de contenido se creó una aplicación complementaria, Acute Pro. El equipo planea ampliar su alcance con el próximo soporte para Android XR, incluidas las gafas XREAL Aura.La plataforma genera aplicaciones white-label de vídeo inmersivo semipersonalizadas, con un backend que cubre la publicación, la monetización y la analítica. Se centra sobre todo en el contenido grabado con la cámara Blackmagic URSA Cine Immersive, aunque también admite vídeo estándar 16:9, películas en 3D, vídeo mono o estéreo de 180 y 360 grados, y Spatial Video grabado con iPhone. Los estudios que prefieren dedicarse a contar historias en lugar de gestionar una aplicación pueden recurrir a otras plataformas de distribución o publicar directamente, manteniendo el control total sobre la experiencia de usuario, los precios y el acceso a la analítica.Captura de pantalla de la vista previa de la aplicación, cortesía de Acute ImmersiveLa publicación es sencilla: los usuarios suben y organizan los archivos en listas de reproducción, revisan el vídeo inmersivo directamente en el visor, añaden títulos y miniaturas, y lanzan contenido nuevo sin tener que enviar una nueva versión de la aplicación. Para la gestión de la audiencia, la plataforma admite notificaciones push sobre nuevas cargas y ofrece datos sobre el comportamiento de los espectadores, que ayudan a tomar decisiones sobre el contenido y la participación. Entre las métricas de marketing se incluyen la atribución del tráfico mediante enlaces profundos, la conversión de las miniaturas y el seguimiento de la conversión desde el clic en un enlace profundo hasta la reproducción del vídeo, lo que resulta útil para perfeccionar la creatividad, la segmentación y las estrategias de captación.La monetización queda en manos de cada cliente: son posibles vídeos individuales, paquetes o suscripciones, y los clientes de curación pueden cerrar sus propios acuerdos de licencia directamente con los propietarios del contenido. Los precios se estructuran en niveles: una tarifa de licencia cubre el funcionamiento de la aplicación para los clientes, el ancho de banda se factura por separado y las personalizaciones se realizan a cambio de una tarifa de servicio. A medida que el vídeo inmersivo resulta más barato de producir, esto ofrece una vía para incorporar más contenido de marcas y de estilo de vida a una biblioteca todavía limitada de vídeo inmersivo accesible.
- Public
- 20 Sep, 2026
«Middle of Nowhere» de Kacey Musgraves demuestra lo buena que puede ser la música inmersiva en Quest
«Kacey Musgraves Middle of Nowhere: An Immersive Experience» es un concierto filmado específicamente para RV en Billy Bob's Texas, en Fort Worth. Meta asegura que la producción se concibió desde cero para 3D estereoscópico en formato VR180: la puesta en escena, la coreografía, la iluminación y la colocación de las cámaras se diseñaron pensando en una persona que mira con un visor. La experiencia de 49 minutos recorre varias zonas del local en lugar de limitarse a filmar un concierto convencional desde unos pocos asientos distintos. La producción y la dirección creativa estuvieron a cargo de Untold Studios, con MediaMonks y 7 Cinematics como coproductores, y se rodó con cámaras Blackmagic URSA.Todo empieza con la llegada de Musgraves a caballo, antes de que la acción pase al interior del honky-tonk. Desde la primera canción, «Dry Spell», las cámaras sitúan al espectador muy cerca de Musgraves y su banda. A veces estás de pie en la pista, mirando ligeramente hacia arriba, hacia el escenario, con el público a tu alrededor; otra cámara está más atrás, detrás de la multitud, y una más se ha colocado en el escenario, entre el teclista y el batería. Las posiciones de cámara no son muchas, pero la disposición del local hace que no hagan falta más.Musgraves pasa buena parte del tiempo actuando hacia la cámara, a veces a apenas un par de metros, y parece cantar casi directamente al espectador. Después, la imagen vuelve a llevarnos entre el público: la sensación de ser una persona más en la sala se alterna con la de asistir a un concierto privado. Más adelante, cuando la gente llena la pista de baile, Musgraves y un acordeonista salen entre ellos mientras la cámara retrocede, y así el espectador queda justo en medio de la multitud.La presentación estereoscópica en Quest 3 es excelente: profundidad natural, personas con el tamaño correcto y ninguna fatiga visual apreciable. La calidad 4K a través del wifi de un hotel se veía aun así impresionantemente nítida, y el audio sonaba potente, claro y bien mezclado. Aproximadamente a la mitad, la experiencia pasa al rodeo con suelo de tierra dentro de Billy Bob's, un edificio que data de 1910. Musgraves se sienta en las gradas entre dos guitarristas, y el espectador queda colocado justo frente al trío, lo bastante cerca como para sentir que está sentado con ellos mientras conversan y tocan.El set termina como empezó: Musgraves sale de Billy Bob's en la caja de una camioneta, y el espectador va con ella, con una cámara situada en la caja del vehículo. El formato demuestra su valor como forma de descubrir a un artista nuevo, y el caso de uso evidente de la RV se ve reforzado por los visores más ligeros y las pantallas de mayor resolución que están apareciendo ahora. La experiencia ya está disponible en Meta Quest a través de la aplicación Meta Quest TV.
- Public
- 20 Sep, 2026
Meta podría mostrar el visor Phoenix en Connect 2026 con avatares de cuerpo completo Codec Avatars
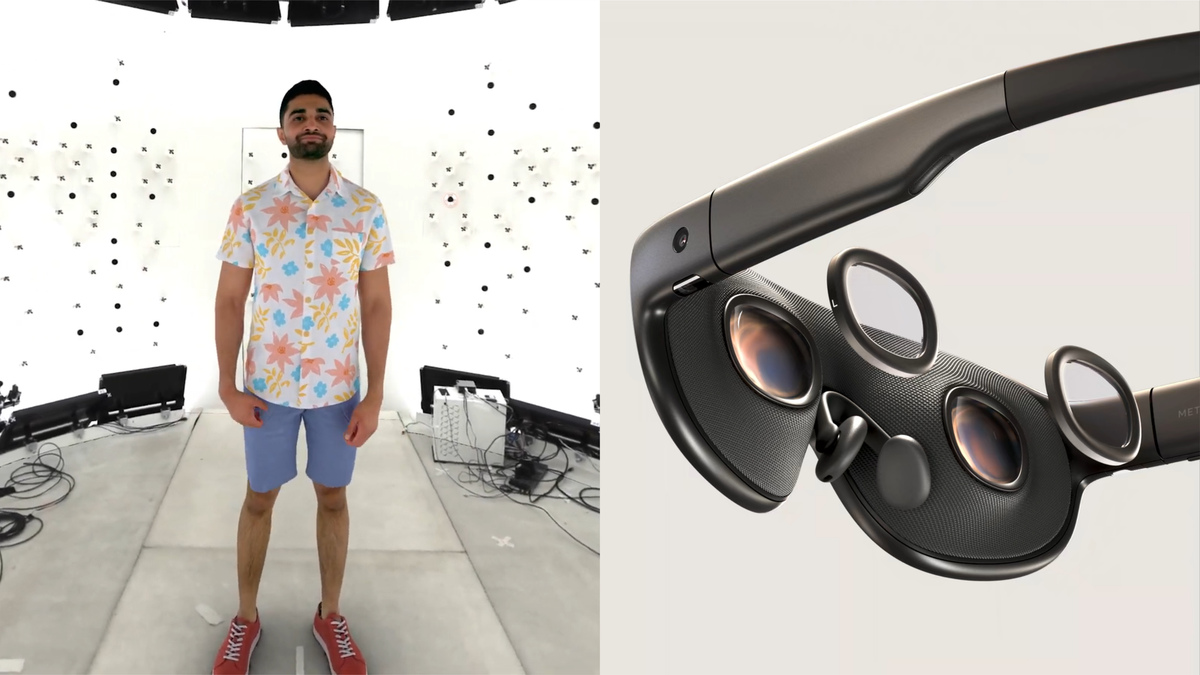
Varios medios de prestigio han informado de que Meta está desarrollando un visor premium ultraligero, con periferia abierta y un módulo de cómputo conectado por cable. Apunta al mismo segmento alto que Meta Quest Pro, pero con un cuerpo mucho más delgado. El proyecto y sus capas subyacentes han aparecido con los nombres en clave Phoenix, Stanley y Loma. Las imágenes oficiales del dispositivo se encontraron en el firmware de Horizon OS a principios de este mes, después de que UploadVR publicara en agosto un análisis detallado.Ahora The Information afirma que Meta podría mostrar Phoenix durante la keynote de Connect 2026 junto con una «llamada holográfica fotorrealista de cuerpo completo» basada en Codec Avatars. El medio describe Phoenix como una «herramienta de productividad y entretenimiento» formada por unas gafas y un módulo, que Meta quiere comercializar para pantallas virtuales y para ver películas. También lo califica de «gafas de realidad aumentada», aunque según otras fuentes Phoenix es técnicamente un visor de Passthrough VR (realidad mixta) con aspecto de gafas, que funciona con el mismo principio que Quest 3 y 3S. Algunas cadenas del firmware incluso llaman al dispositivo «VR Glasses», pero esa denominación no es definitiva.Cadenas de texto encontradas en el paquete de firmware Prescription Lens de HorizonOS.El reportaje afirma que, a principios de este mes, el director ejecutivo Mark Zuckerberg y el director de tecnología Andrew Bosworth revisaron el trabajo de la empresa en videollamadas de tipo holograma. Desde entonces, Meta ha decidido mostrar «una experiencia de llamada holográfica de cuerpo completo y fotorrealista durante una demostración en vivo de Phoenix en la keynote de Connect la próxima semana, con Bosworth como holograma», si los planes se mantienen. Esa experiencia funcionaría con Codec Avatars, la investigación de larga trayectoria de Meta sobre telepresencia espacial fotorrealista mediante sensores de Face Tracking en visores de RV/RM y, con el tiempo, en gafas. En términos generales, es similar a Personas en visionOS y Likeness en Android XR.Archivos Smali que hacen referencia a Holograms, encontrados en el paquete Horizon OS Social Platform.Meta lleva años perfeccionando esta tecnología; el ejemplo más conocido es la entrevista en RV de Mark Zuckerberg con Lex Fridman, en la que ambos usaron prototipos de Codec Avatars fotorrealistas. Esas versiones se capturaron con un equipo especializado y se renderizaron en ordenadores de gama alta, pero desde entonces Meta ha mostrado maneras de generar Codec Avatars a partir de pocas fotos y de ejecutarlos en hardware de clase móvil como Quest 3. A principios de este año, la empresa publicó el artículo «Large-scale Codec Avatars: The Unreasonable Effectiveness of Large-scale Avatar Pretraining», que describe un modelo que genera Codec Avatars de cuerpo completo a partir de datos de entrada limitados y los anima mediante sensores orientados hacia el interior y SLAM del visor.A agosto de 2026, los planes de Meta para Codec Avatars se centran cada vez más en las videollamadas y la telepresencia para experiencias sociales dentro de su familia de aplicaciones, y el nombre Hologram está muy ligado a esta orientación. Varios paquetes de Horizon OS contienen lo que parecen ser subframeworks de un sistema más amplio de «Hologram Calling», con numerosas referencias a Codec Avatars. Las cadenas de texto de la aplicación móvil Meta AI para Smart Glasses y otros dispositivos vestibles también describen la configuración de un avatar «Hologram», lo que apunta a un posible nombre de cara al consumidor. Meta Connect 2026 se celebrará los días 23 y 24 de septiembre y presentará los «últimos avances de la compañía en tecnologías de IA, gafas con IA y RV».Cadenas de texto que hacen referencia a Holograms, encontradas en las compilaciones de la aplicación móvil Meta AI de agosto de 2026.
- Public
- 20 Sep, 2026
visionOS 27 llega a Apple Vision Pro: asistente Siri con IA, seguimiento de objetos en la mano y nuevas API para accesorios con seguimiento
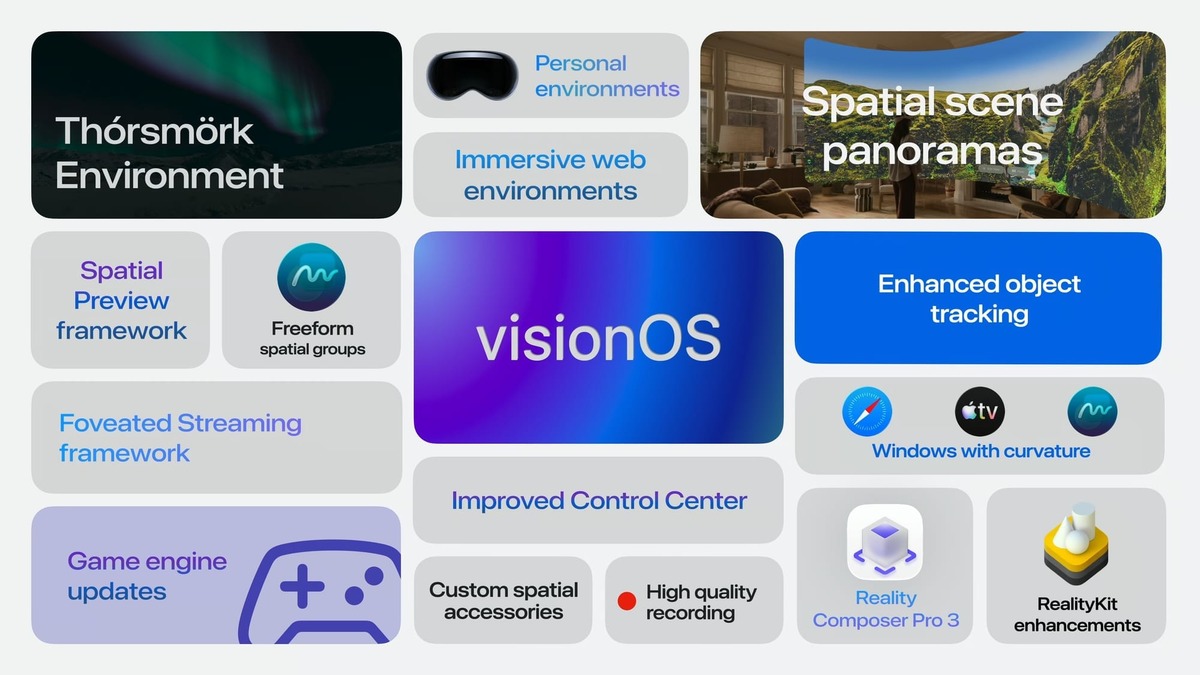
Apple ha lanzado visionOS 27, la cuarta gran actualización del sistema operativo para los visores Vision Pro. Está disponible tanto en los modelos con M2 como en los modelos con M5. La actualización llegó casi sin ruido, pero por su alcance es una de las mayores hasta la fecha. La novedad principal es Siri AI, el asistente de Apple rediseñado sobre grandes modelos de lenguaje, que ahora se despliega en versión beta. Para acceder, hay que apuntarse a una lista de espera en los ajustes de visionOS; Apple indica que el tiempo de espera varía y que, en cuanto se concede el acceso, la función empieza a descargarse automáticamente. Por ahora Siri AI solo funciona en inglés: tanto el idioma del dispositivo como el de Siri deben estar configurados con la misma variante de inglés compatible.Siri AI se apoya en los modelos fundacionales de nueva generación de Apple, que la compañía desarrolló junto con Google a partir de sus modelos Gemini. Como ocurre con Apple Intelligence en general, una parte de las tareas se ejecuta en un modelo pequeño integrado en el propio dispositivo, mientras que el trabajo más complejo se envía a Private Cloud Compute de Apple. En visionOS, Siri AI aparece como una esfera fija en el espacio que se puede anclar a un punto concreto de la habitación; para empezar a hablar basta con mirarla, sin necesidad de decir «Siri». También admite Visual Intelligence, para hacer preguntas sobre el entorno físico y virtual, y se incluye como una aplicación independiente preinstalada con historial de conversaciones.Accesorios de referencia con seguimiento para visionOS 27, de DFRobot y MikroE.Para los desarrolladores, visionOS 27 añade un modo de seguimiento de objetos con alta tasa de fotogramas, adecuado para objetos en movimiento y objetos sostenidos en la mano. Apple no indica la frecuencia de actualización, pero los primeros informes apuntan a unos 30 Hz. Para los objetos sostenidos, Apple recomienda encarecidamente el nuevo modo Extended Training, que mejora notablemente el seguimiento pero aumenta «significativamente» el tiempo de entrenamiento: un desarrollador contó que entrenar un pez de juguete le llevó cerca de 18 horas. El seguimiento óptico funciona a 90 Hz y se combina con los datos del acelerómetro y el giroscopio (IMU) del propio objeto. La actualización también abre la vía a los accesorios con seguimiento: antes, Sony y Logitech tenían integrado directamente el soporte para los mandos PS VR2 Sense y el lápiz Muse, que utilizan constelaciones de LED infrarrojos.El entorno Thórsmörk en visionOS 27.visionOS 27 añade las API que permiten a cualquier empresa crear sus propios accesorios con seguimiento mediante LED infrarrojos, de forma similar a como funcionan en PC los accesorios SteamVR «Lighthouse». DFRobot y MikroE ya han anunciado hardware de referencia y kits para desarrolladores, y el hardware de DFRobot se puede comprar ya. Además, ha aparecido una opción de grabación en alta calidad: permite grabar hasta tres minutos de vídeo 4K sin renderizado foveado directamente en el visor, sin necesidad de un Mac. Era una función muy esperada para mostrar contenido de visionOS. visionOS 27 también incorpora el entorno del valle de Thórsmörk, en Islandia, el décimo entorno virtual, con una variante nocturna de aurora boreal.El nuevo centro de control de visionOS 27.Otras mejoras se dirigen a los desarrolladores de aplicaciones y a los flujos de trabajo. Al conectarse mediante Mac Virtual Display, macOS 27 incorpora una API para generar un objeto 3D en visionOS como vista previa, con compatibilidad integrada con Preview.app; las ediciones hechas en el visor se reflejan en el lado de macOS, y SharePlay permite la edición colaborativa con Personas. Xcode 27 incluye la aplicación Device Hub, para que los desarrolladores puedan iniciar demos de forma remota en lugar de guiar a los invitados con la mirada y el pellizco. visionOS 27 también añade ventanas curvas en Safari, Freeform y Apple TV Multiview (aunque sigue siendo una API privada de uso exclusivo de Apple), además de widgets para accesorios, entornos web de Safari mediante la API requestImmersive() y una conexión Wi-Fi más rápida tras el arranque.
- Public
- 19 Sep, 2026
Optimización de Deep Rock Galactic: Survivor para dispositivos móviles
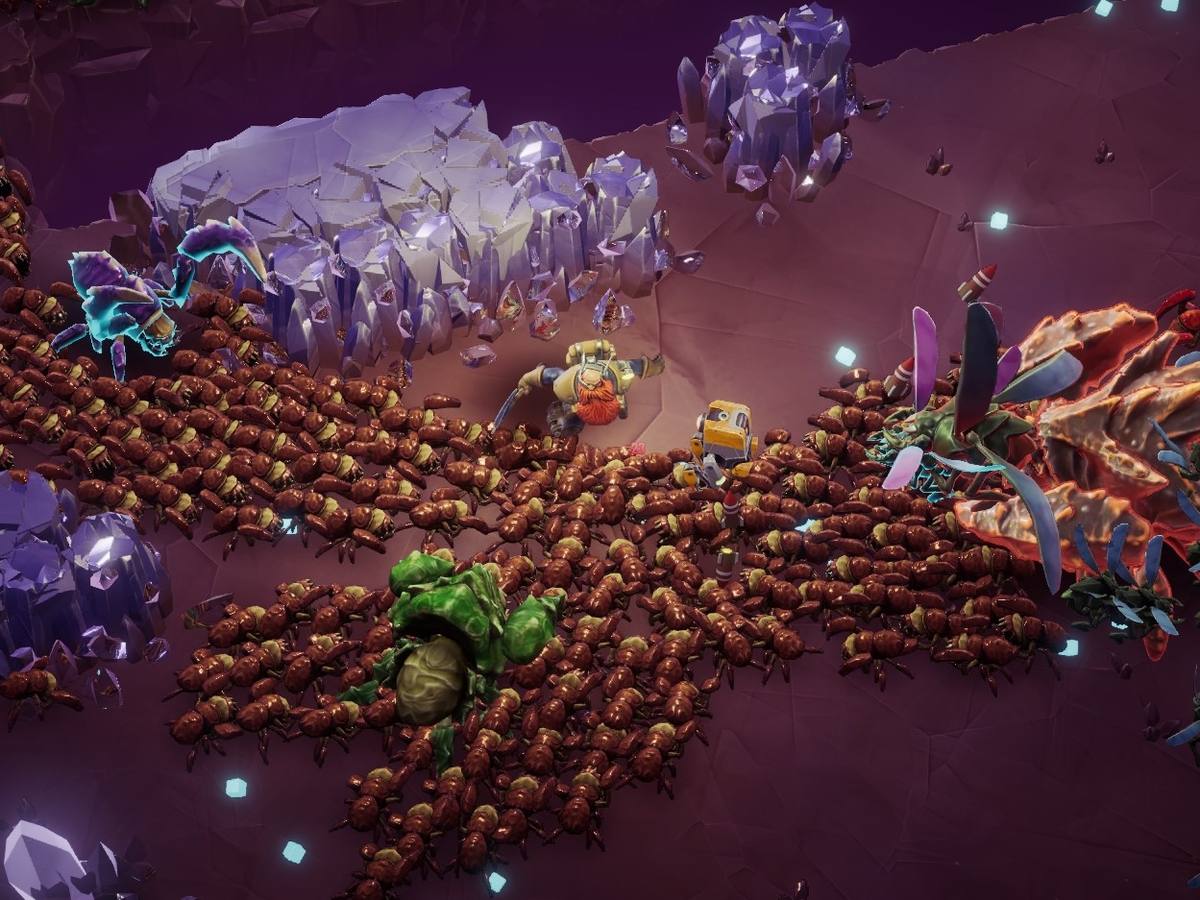
Llevar Deep Rock Galactic: Survivor a los móviles significó tomar un juego bullet-heaven de PC y conseguir que funcionara en un hardware con una fracción del presupuesto de GPU, CPU y memoria. El port corrió a cargo de Piktiv mientras la rama de PC seguía en pleno desarrollo, y los equipos se distanciaron tanto que la fusión iba en una sola dirección: de PC a móvil, nunca al revés. Esa separación le dio a Piktiv libertad para ser drástica con los sistemas originales: desmontar enfoques consolidados y reconstruirlos en torno a un conjunto de objetivos de optimización muy distinto. La restricción principal era la memoria: casi todos los dispositivos objetivo tenían 4 GB de RAM, salvo un iPad con solo 3 GB. En ese dispositivo el equipo disponía de unos 1850 MB para todo, y superarlos significaba un cierre inesperado.El trabajo de rendimiento se centró en los sistemas cuyo coste crece con el número de enemigos. Los números de daño eran originalmente GameObjects con TextMesh Pro, pero generar una malla de texto para mil enemigos a la vez se convirtió en un cuello de botella. La solución fue un sistema de partículas estándar de Unity con una spritesheet que contiene los dígitos del 0 al 9. El pathfinding dejó el sistema NavMesh integrado, que tiene dificultades cuando miles de agentes calculan cada uno su propia ruta, y pasó a un enfoque de flow field, donde el coste depende del tamaño del área y no del número de agentes. Las consultas de físicas se optimizaron con un KD-tree para búsquedas espaciales, por ejemplo, para encontrar a todos los enemigos dentro del radio de explosión de una granada, aunque eso exigía reconstrucciones frecuentes a medida que los enemigos se movían. En el renderizado de enemigos, unos mil skinned mesh renderers se sustituyeron por animación de vértices precalculada (baked): cada fotograma clave se almacena en una textura y un shader de la GPU lo reproduce, lo que reduce el coste de CPU casi a cero y permite el GPU instancing sobre una única malla y un único material compartidos.Los detalles técnicos más profundos explican cómo funcionan estos reemplazos. El flow field invierte el modelo de coste del pathfinding: se superpone una cuadrícula sobre el nivel y, a partir del objetivo, las celdas dibujan flechas que apuntan hacia vecinas que ya tienen flecha, hasta cubrir todo el campo. Entonces el coste depende del área cubierta y no del número de agentes, y se puede limitar aún más calculando una caja delimitadora alrededor de todos los enemigos y del jugador, y actualizando el campo solo dentro de esa región. El KD-tree divide el espacio de forma recursiva, de modo que una consulta de punto y radio devuelve rápidamente todo lo que hay dentro, sustituyendo consultas de físicas más pesadas. Estos sistemas alimentaron una cadena de jobs de Burst, de 10 a 15 dependencias de longitud, que mueve a todos los enemigos fuera del sistema de físicas habitual y eleva de forma notable el mínimo de fotogramas por segundo.Addressables fueron esenciales para ajustarse al límite del iPad de 3 GB. Como el juego nunca muestra más de un bioma a la vez, Piktiv separó los recursos gráficos y los ajustes específicos de cada bioma para que solo se carguen cuando hacen falta. La contrapartida es que Addressables introducen comportamiento asíncrono en código que antes era síncrono, y reconstruir un sistema para que sea async puede ser un gran desafío de arquitectura, pero aquí fue la opción acertada. Las pruebas se basaron en un sistema automatizado de mediciones que ejecutaba seis escenarios en todos los biomas: uno base con el jugador inactivo, mil enemigos acercándose, o 500 enemigos más armas que disparan automáticamente. Se midieron CPU, GPU y memoria en todo momento, y el Unity Profiler guió las primeras auditorías de CPU. Un escenario que generaba unos 4000 cubos azules de recogida en diez segundos suponía un golpe serio antes de la optimización, y después pasó a ser imposible de medir. La geometría del nivel, construida de forma procedural a partir de objetos individuales, también se agrupó en lotes con comandos de dibujo personalizados, ya que la cámara fija cenital hace que el área visible sea fácil de calcular.Para los equipos que se planteen un port similar, las conclusiones tienen menos que ver con un único truco que con la disposición de los datos y la colaboración entre sistemas. Mover datos hacia dentro y fuera de los componentes resulta caro cuando miles de entidades se ejecutan en cada fotograma, así que compensa mantenerlo todo en contenedores nativos y pasar esos mismos contenedores por toda la canalización. Y un juego que debería haber usado ECS o el Data-Oriented Technology Stack no necesita una reescritura completa: este proyecto se apoyó en el compilador Burst y en tipos de datos nativos sin convertir todo el juego. Deep Rock Galactic: Survivor está disponible en Steam, Xbox, App Store y Google Play.