Blog
 Public
- 16 Nov, 2026
Android XR incorpora OpenXR Spatial Containers para aplicaciones con varios motores
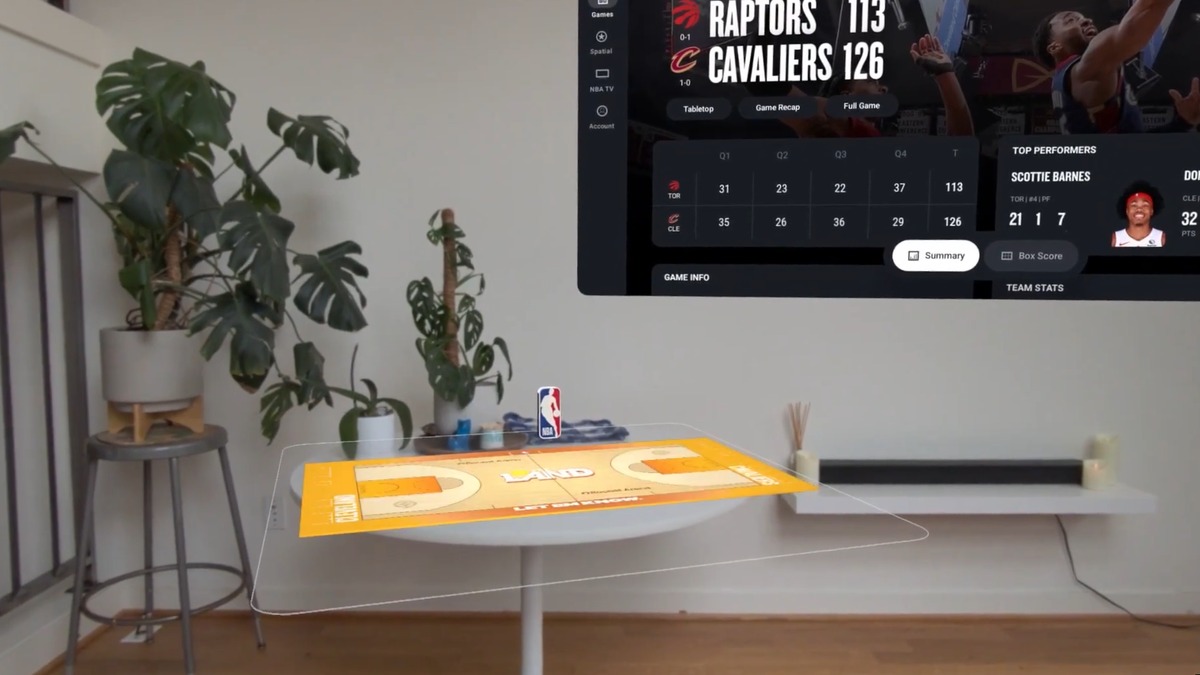
Android XR ahora es compatible con las extensiones OpenXR Spatial Container, estandarizadas recientemente. Para que funcionen se necesita un dispositivo con Spatial API Level 4 o superior, y la aplicación debe ejecutarse en modo Full Space. Las extensiones definen espacios gestionados por el sistema en los que la aplicación muestra contenido 3D volumétrico. Es parecido a cómo un sistema operativo de escritorio coloca el contenido 2D dentro de ventanas.Hasta ahora, una sesión de OpenXR en Android XR tomaba el control exclusivo de la pantalla. Con Spatial Containers, la aplicación puede renderizar contenido 3D dentro de un volumen 3D acotado o cambiar a un modo inmersivo sin límites, que se comporta como una aplicación OpenXR convencional. El sistema se encarga de los controles de ventana y de la ubicación de cada contenedor. Cuando un contenedor tiene el foco y es interactivo, el usuario puede manipular su contenido directamente mediante el seguimiento de manos, la mirada o mandos 6DoF.La principal ventaja práctica es que ahora se pueden combinar distintas tecnologías en una misma aplicación. La interfaz de Jetpack Compose, las actividades 2D habituales de Android y el contenido 3D basado en OpenXR pueden convivir. La parte 3D se puede renderizar con motores como Unity o Godot, o bien escribirse directamente sobre OpenXR nativo. La aplicación de la NBA es una de las primeras en usarlo, en una función llamada Court View. Su interfaz principal está creada en Compose, mientras que, en algunos partidos, se muestran canchas 3D volumétricas renderizadas con Unity. La función reproduce Tabletop de la aplicación de la NBA para Apple Vision Pro, que también ha pasado a llamarse Court View.A nivel de estándar, Spatial Containers abre la puerta a aplicaciones similares a las de visionOS. Allí, gracias a la arquitectura Shared Space y a RealityKit, las aplicaciones con ventanas y las volumétricas funcionan una junto a otra y pueden pasar a la inmersión completa de Full Space. La primera implementación en Android XR es más modesta. Los contenedores requieren el modo Full Space Managed, y no Home Space, que es el modo de multitarea. Una aplicación puede mostrar varios contenedores propios, pero no junto al contenido de otras aplicaciones. Esto concuerda con que Android XR limite los componentes espacializados a Full Space.Por ahora, la función sirve más bien para crear aplicaciones con varios motores que para ofrecer multitarea espacial entre aplicaciones. Esto coincide con la forma en que Google la describió en I/O este año, cuando presentó por primera vez estas capacidades: como «experiencias multimotor» (multi-engine experiences). Todavía queda un largo camino para igualar la multitarea espacial completa que ofrecen visionOS en Apple Vision Pro y Pico OS 6 en el próximo Pico Space Pro.
- Public
- 16 Nov, 2026
CUDA cumple 20 años: de los primeros programas para GPU a 11 millones de desarrolladores
En la conferencia de supercomputación SC26, NVIDIA celebra el 20.º aniversario de CUDA y rinde homenaje a los investigadores, desarrolladores e ingenieros gracias a los cuales la computación en GPU se convirtió en la base de la ciencia y la IA modernas. La plataforma se anunció en noviembre de 2006 y se presentó a la comunidad científica en SC06. Ofreció a los desarrolladores un modelo de programación de alto nivel, familiar, para las GPU y llevó la computación acelerada mucho más allá de los gráficos: a la simulación y a otras tareas que exigen muchos recursos.Dos décadas después, más de 11 millones de desarrolladores trabajan con CUDA en todos los niveles de la pila de cómputo. La plataforma está detrás de investigaciones de IA galardonadas con el Premio Nobel, de aplicaciones científicas que se ejecutan en supercomputadoras y de efectos visuales de películas ganadoras del Óscar. Hoy el ecosistema incluye más de 1000 bibliotecas CUDA-X, que se usan en el descubrimiento de fármacos, el diseño de fábricas, los vehículos autónomos, el modelado de mercados financieros y la computación cuántica.Uno de los primeros hitos importantes está vinculado al equipo del biofísico Klaus Schulten, de la Universidad de Illinois en Urbana-Champaign. Las herramientas que creó, Nanoscale Molecular Dynamics y Visual Molecular Dynamics, unieron la computación en GPU con la biología molecular. En 2013, investigadores de Illinois, de la Universidad de Pittsburgh y de la Universidad Vanderbilt utilizaron herramientas aceleradas con CUDA para determinar la estructura atómica de la cápside del VIH. Para ello combinaron experimentos con simulaciones en Blue Waters, por entonces una de las supercomputadoras más potentes del mundo.En el ámbito de la IA, los investigadores de la Universidad de Toronto Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton entrenaron con CUDA el modelo AlexNet con solo dos GPU de NVIDIA. Este modelo de reconocimiento de imágenes ganó el concurso ImageNet de 2012 y demostró de qué eran capaces las GPU en el aprendizaje profundo. Más tarde, Demis Hassabis y John Jumper compartieron el Premio Nobel de Química de 2024 por la predicción de la estructura de proteínas con AlphaFold. El software AlphaFold 2, que su equipo publicó de forma abierta, se ejecuta en GPU a través de CUDA.Estos ejemplos muestran cómo el trabajo de una generación abre el camino a la siguiente. El punto de partida para trabajar con la plataforma sigue siendo CUDA Toolkit. Además, en el estand de NVIDIA en SC26 se ha instalado, con motivo del aniversario, el panel 20-Year CUDA Celebration Event Wall.
- Public
- 16 Nov, 2026
Unity Fellowship otorgará subvenciones de 50 000 USD a diez estudios indie
Unity ha lanzado Unity Fellowship, un programa de ayuda financiera y apoyo para estudios de juegos independientes. Se seleccionarán diez equipos cuyos juegos saldrán aproximadamente dentro de un año y se les dará acceso a recursos, apoyo y contactos útiles. Cada equipo recibirá una subvención de 50 000 USD. No es necesario ceder participación en el estudio a cambio ni devolver el dinero. Los estudios deciden por sí mismos cómo y cuándo usar lo recibido y conservan por completo el control creativo, tanto sobre la visión del juego como sobre la estrategia de negocio.Unity busca juegos únicos con una sólida visión creativa. Los solicitantes deben enviar un vídeo del juego, una versión jugable y una hoja de ruta del desarrollo, además de explicar cómo los recursos del programa ayudarían a impulsar el proyecto. El programa está dirigido principalmente a equipos sin el respaldo de un distribuidor, pero los estudios que ya cuentan con uno también pueden presentar su solicitud. Los solicitantes deben ser propietarios de todos los contenidos del juego, incluidos los generados con IA, o tener los derechos sobre ellos.No todas las regiones pueden participar. Unity no aceptará solicitudes de desarrolladores de países y territorios sujetos a sanciones de EE. UU., ni de Brasil, Italia y la provincia de Quebec. El programa está pensado para estudios indie que desarrollan juegos con Unity. Los equipos seleccionados se anunciarán en la GDC en marzo de 2027.
- Public
- 16 Nov, 2026
FunFitLand en Meta Quest ya cuenta con entrenamientos multijugador a los que puedes unirte en cualquier momento
FunFitLand, una aplicación de fitness en RV para Meta Quest, ya cuenta con modo multijugador. Este modo resuelve uno de los principales problemas de los entrenamientos domésticos en RV: la falta del contacto social y de la motivación que da entrenar con otras personas en un gimnasio físico. Todos los tipos de entrenamiento de la aplicación admiten multijugador: CombatFit (boxeo rítmico), GrooveFit (baile), SwingFit (movimientos fluidos con bates), FlowFit (movimientos relajantes, de inspiración zen y tai chi) y Space, un conjunto de entornos virtuales meditativos donde no hay que entrenar en absoluto. En Space, los grupos pueden simplemente reunirse y charlar, por ejemplo durante el enfriamiento. Esto encaja con el objetivo de los autores: que la aplicación sea no solo un programa de fitness, sino también un lugar al que acudir en busca de bienestar.Modo multijugador de FunFitLand. Foto: FunFitLandAdemás, los desarrolladores han resuelto el problema del lobby vacío. En otras aplicaciones de fitness para RV, el entrenamiento en grupo solo empieza cuando se ha reunido todo el grupo. En FunFitLand se puede abrir una sala en solitario y empezar a entrenar de inmediato, y hasta tres personas más pueden unirse sobre la marcha. El equipo dedicó unas tres semanas a un único desafío técnico: el recién llegado debe incorporarse exactamente al punto al que ha llegado el anfitrión de la sala, incluso si quedan solo los últimos cinco segundos de la vuelta a la calma. Las salas pueden llevar etiquetas de idioma: los usuarios de la aplicación viven en todo el mundo, y así se ve de un vistazo si los participantes de la sesión hablan tu idioma.Menú del modo multijugador. Foto del autor.Selección de idioma. Foto del autor.En el modo multijugador, los jugadores aparecen como simpáticas figuras de dibujos animados. Se puede elegir la forma de la cabeza y la «cara» entre varias opciones, y personalizar los acentos de color. Los autores esperan que cada persona tenga varios avatares y los cambie según su estado de ánimo. Además, el avatar oculta el aspecto real, por lo que algunos usuarios entrenan con libertad y sin sentirse cohibidos. Otras aplicaciones adoptan un enfoque distinto: FitXR usa avatares de Meta, y en la versión antigua de Supernatural se representaba a los usuarios con modelos corporales «difuminados». El modo multijugador de la nueva Supernatural aún no se ha mostrado. El aspecto de los avatares de FunFitLand se ha pulido muchas veces a partir de los comentarios del equipo interno y de beta testers externos de la comunidad de Facebook de la aplicación.Los objetivos llegan por varios carriles y hay que moverse hasta 360º. Cuando se abren los carriles laterales y empiezan a llegar objetivos por ellos, el avatar de tu compañero se vuelve translúcido para que no se pierdan de vista. Este detalle sutil también surgió gracias a las pruebas y los comentarios de los usuarios. Con la opción «omitir enfriamiento», es fácil encadenar entrenamientos grupales uno tras otro. El estudio presenta el multijugador como una pieza clave de su plan de conectar a las personas a través del ejercicio, el movimiento consciente y la comunidad, y promete nuevas funciones. FunFitLand se puede descargar gratis en Meta Quest. La suscripción cuesta $9.99 al mes o $99.99 al año.
- Public
- 15 Nov, 2026
Cómo debe ser un personaje 3D listo para usar en un juego: consejos de cuatro artistas de personajes
Todo juego gira en torno a un héroe, pero la mayor parte de lo que aparece en pantalla es el reparto secundario: enemigos, aliados, comerciantes, jefes, guardias, criaturas y personajes de fondo. Un protagonista puede justificar una geometría pesada y materiales complejos. Con los NPC no es posible: hay que equilibrar el impacto visual con el rendimiento, la coherencia y la eficiencia de producción. Cuatro artistas que venden personajes listos para usar en juegos, RyanReos, Hisqie Furqoni, Andryuha1981 y KirTheGreat, explican cómo logran ese equilibrio.Para ellos, «listo para el juego» significa más que «de pocos polígonos». En su día, Furqoni valoraba los assets por el número de polígonos. Ahora se pregunta si el modelo encaja en el pipeline: qué rig tiene, cómo se deforma, cómo están organizados los archivos y si es compatible con el motor. KirTheGreat enumera una topología limpia, una geometría optimizada, UV correctos, texturas PBR y la preparación para el rigging y la implementación en el motor. RyanReos define el ideal como «plug-and-play». Sus personajes modulares de fantasía están preparados para Unreal Engine 5 y se entregan como archivos FBX con rig, pensados para pasar sin problemas a Unity o Godot.El nivel de detalle debe depender del papel del personaje. Andryuha1981 señala que los héroes y los jefes importantes pueden permitirse una geometría compleja, porque hay pocos en pantalla al mismo tiempo, mientras que los enemigos comunes deben ser más ligeros: «Un juego no consta de un solo personaje principal». La modularidad ayuda a sacar más personajes de un mismo conjunto. RyanReos mantiene por separado el cuerpo, el pelo, la armadura y la ropa. Andryuha combina atuendos, peinados, armas, materiales y rostros, y así convierte a un personaje en varios NPC. Furqoni conserva la cohesión de sus series: dentro de un mismo estilo varía el papel, la silueta, las armas y las armaduras. Considera que los nombres y el orden de los archivos son la «interfaz y la experiencia de usuario de un producto 3D».Los cuatro advierten: al comprar, no conviene fiarse de la imagen promocional. Kir recomienda revisar la topología, los mapas UV, las texturas, el número de polígonos, los materiales, el rig, la estructura de los archivos y la compatibilidad con el motor. RyanReos subraya las versiones compatibles del motor: por ellas los assets suelen fallar en el proyecto del comprador. Furqoni añade la resolución de las texturas, el tipo de rig, los formatos de archivo y lo que incluye el paquete, y advierte de que, con las imágenes promocionales generadas por IA, la verificación se vuelve aún más importante. Andryuha aconseja leer la descripción completa, estudiar las capturas de pantalla y ver el vídeo de presentación. Todos coinciden en algo: un buen personaje debe encajar tanto en el mundo del juego como en su pipeline.
- Public
- 14 Nov, 2026
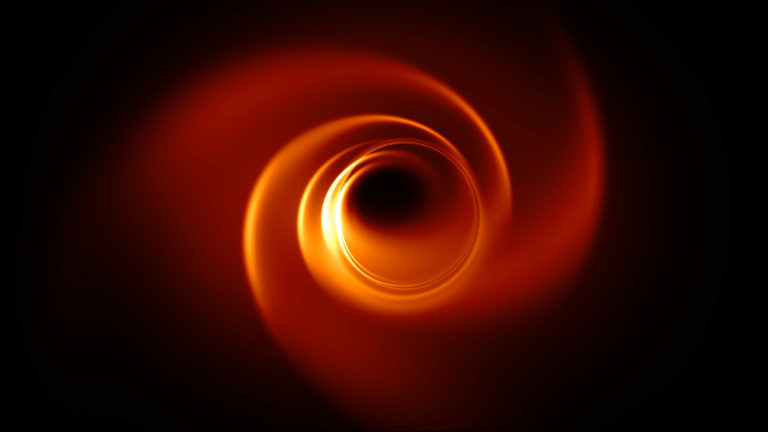
NVIDIA cuPhoton.xBeam traslada a la GPU la correlación de los datos de interferometría de agujeros negros
Obtener la imagen de un agujero negro exige resolver un objeto diminuto: el anillo observado de M87* abarca apenas 42 microsegundos de arco. El Event Horizon Telescope (EHT) conecta 13 radioestaciones, entre ellas las de Hawái, Chile, España, México y el Polo Sur, mediante interferometría de línea de base muy larga (VLBI). Cada estación registra dos polarizaciones a hasta 64 gigabits por segundo, de modo que se acumulan petabytes de datos de voltaje. La correlación de pares de telescopios produce visibilidades. Se trata de muestras de Fourier dispersas del brillo del cielo a lo largo de las trayectorias que traza la rotación de la Tierra. A partir de esas muestras, los algoritmos de reconstrucción resuelven un problema inverso. Con fuentes variables como Sgr A*, que cambian durante la propia sesión de observación, la tarea resulta todavía más difícil. El EHT de nueva generación (ngEHT) planea añadir más estaciones para mejorar la calidad de las imágenes y seguir los cambios a lo largo del tiempo.Figura 2. Ejemplo sintético al estilo del EHT que muestra el muestreo de frecuencias espaciales, las amplitudes de las visibilidades, la imagen «sucia» y un modelo en forma de media lunaNVIDIA cuPhoton.xBeam es un correlador FX basado en GPU. A partir de grabaciones sin procesar, obtiene una visibilidad compleja por cada par de estaciones, canal de frecuencia e intervalo de tiempo corto. El correlador se desarrolló junto con el Centro de Astrofísica Harvard-Smithsonian y el Observatorio MIT Haystack. En un sistema NVIDIA Vera Rubin NVL72 procesó un conjunto de datos de 10 TB en 70 segundos. Para ello se necesitaron 64 GPU y GPUDirect Storage en modo de compatibilidad. Es aproximadamente 460 veces más rápido que con un procesador x86, que tardó 31 992 segundos, es decir, 8,89 horas. La calibración y la formación de imágenes posteriores, por ejemplo los modelos tridimensionales de gas basados en Gaussian splatting, no forman parte de cuPhoton. xBeam no calcula los retardos a partir de las coordenadas de las estaciones ni traza las trayectorias de la luz. Los resultados se validan con el correlador abierto para CPU DiFX, y los datos de salida están pensados para herramientas como HOPS, rPICARD y eht-imaging.Figura 4. Aceleración de cuPhoton.xBeam respecto a la línea base en un procesador x86 (izquierda) y rendimiento de carga de datos (derecha) con distinto número de GPU en NVIDIA Vera Rubin NVL72El flujo de procesamiento consta de cinco etapas. En la etapa de ingesta, cada trama VDIF se coloca en su posición temporal. Junto a ella se crea un archivo .vdix que indexa las tramas por marca de tiempo, hilo y ubicación física, sin copiar los datos. Los datos ausentes o no válidos se marcan de forma explícita. En la etapa de corrección de retardo y de fase de franjas, los datos se alinean antes de la FFT con precisión de una muestra entera y se les aplica la rotación de fase de franjas. El retardo fraccionario restante se compensa con una corrección de fase dependiente de la frecuencia.El retardo se toma del archivo de trabajo. Se compone de un polinomio geométrico alrededor de t0, el desfase y la deriva del reloj de cada estación y el desfase de reloj de cada banda. Dentro de una misma FFT, el retardo puede ser constante, lineal o parabólico, y esto lo determina el parámetro fringe_approximation_order (0, 1 o 2). En la etapa de canalización se ejecuta una FFT para cada estación. En la etapa de multiplicación cruzada con acumulación, el espectro de una estación se multiplica por el conjugado complejo del espectro de la otra. Los datos de entrada no válidos se enmascaran y el resultado se normaliza con los pesos de exposición. La salida tiene formato DiFX SWIN o xbeam-v1.La versión 0.1.3 acepta un trabajo normalizado en JSON (versión de esquema 1) o un archivo DiFX .input compatible. En él se enumeran las estaciones, los relojes, las frecuencias, los flujos de datos VDIF, las líneas base y los escaneos. El directorio de salida debe ser nuevo. El comando cuphoton xbeam inspect-vdif RECORDING.vdif --json lee solo las cabeceras. El comando build-vdif-sidecar con los parámetros --index-dir, --backend cufile (o posix, si no se dispone de GPUDirect Storage) y --devices crea índices reutilizables, mientras que los archivos de origen permanecen sin cambios. El comando cuphoton xbeam correlate JOB.json con --backend cupy ejecuta la correlación en la GPU. De forma predeterminada, los datos se leen mediante POSIX a través de memoria del host fijada (pinned), y con --vdif-io cufile - mediante GPUDirect Storage. Entre las opciones se incluyen --scan, --first-integration y --integration-count. Desde Python se puede llamar a load_job y correlate con CorrelationWindow y obtener registros uno a uno, pero la escritura en SWIN solo está disponible desde la CLI.Para grabaciones con huecos hay un perfil --profile interop-real-usb-buffered-window-replay-v1. Con este perfil, las muestras dentro del búfer retenido siguen leyéndose con la referencia temporal anterior hasta que aparece un nuevo punto de anclaje. El perfil también determina qué bloques FFT se tienen en cuenta y cómo se informan los pesos. No recupera las muestras perdidas, y un peso completo no garantiza que los datos estén completos. Sin el perfil, los fotogramas se alinean por las marcas de tiempo de las cabeceras, las ranuras vacías se marcan como no válidas y, por tanto, las visibilidades y los pesos pueden diferir. Al escalar, un scan se divide en el tiempo. En un solo nodo, --devices 0,1,2,3 lanza un proceso por cada GPU, escribe los resultados en RUN/shards/ y los combina. En varios nodos, cada proceso recibe --shard-count y --shard-index, por ejemplo 64 con los índices 0-63, con la misma configuración de escaneos e integraciones. Luego merge-shards combina los resultados parciales de SWIN.Figura 1. Los radiotelescopios registran señales que se correlacionan en visibilidades para reconstruir la imagen. Ilustración conceptualFigura 3. cuPhoton.xBeam convierte las grabaciones de los telescopios en visibilidades para la posterior generación de imágenes
- Public
- 14 Nov, 2026
Curso de creación de una Lee-Enfield lista para juegos: todo el pipeline en Blender, Substance y Marmoset
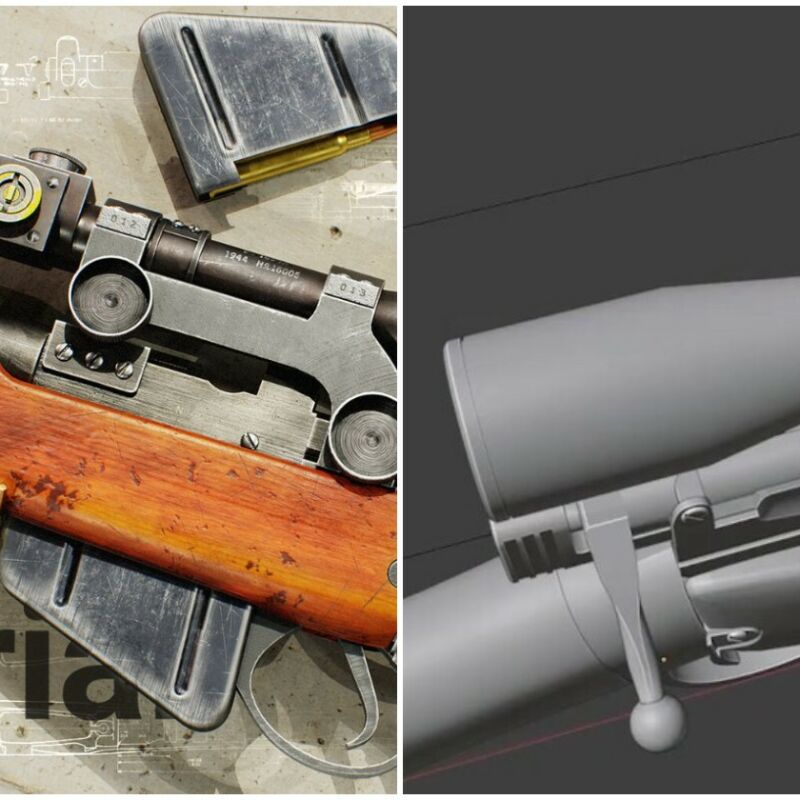
Titanium Studio ha lanzado el curso Mastering LEE-ENFIELD NO4 MK1 Game Ready Creation in Blender. Está orientado a la producción real y cuenta con más de 26 horas de vídeo. Lo imparte Navid Valizadeh, artista sénior de armas y props, especializado en assets fotorrealistas. El proyecto del curso es un rifle de francotirador inspirado en la Segunda Guerra Mundial: se crea desde cero y se lleva hasta un render final pulido.El modelado se realiza en Blender y se basa en técnicas profesionales de modelado hard-surface. Se pone el foco en una geometría limpia, en el detalle de los componentes y en un flujo de trabajo estructurado. Después, el asset pasa a Substance 3D Painter para el texturizado: los estudiantes crean materiales realistas, añaden variación de superficie, ajustan la rugosidad y aplican desgaste y detalles finos. El curso enseña el proceso completo de creación de un asset, y no solo cómo manejar cada herramienta por separado.En la última etapa, el rifle se prepara para su presentación en Marmoset Toolbag 5. Aquí se estudian la iluminación profesional, la configuración de materiales, la composición de cámara y las técnicas que ayudan a mostrar el arma terminada de forma atractiva. Juntas, las tres etapas reproducen un pipeline típico de creación de props game-ready, utilizado en producción.
- Public
- 14 Nov, 2026
Meta-Optics Mirror de TDK y el escaneo Lissajous coherente: el regreso de las gafas de RA con láser
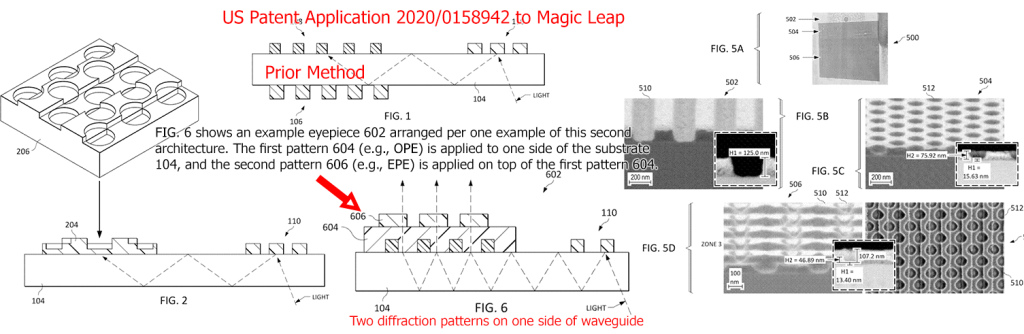
El 2 de octubre de 2026, TDK presentó Meta-Optics Mirror, un nuevo tipo de «combinador en espacio libre» (free-air combiner) para gafas de RA. El anuncio fue precedido por dos acuerdos cerrados a principios de ese mismo año. En mayo de 2026, TDK adquirió los activos principales, la propiedad intelectual y el equipo de Oqmented. Esta empresa fabricaba espejos MEMS en encapsulado de vacío para el escaneo láser de haz (LBS) siguiendo figuras de Lissajous. En junio de 2026, TDK firmó un acuerdo de cooperación empresarial con el fabricante de láseres QD Laser: ambas compañías desarrollarán conjuntamente motores ópticos con proyección sobre la retina para gafas inteligentes. Trabajan juntas al menos desde 2020. QD Laser, escindida de Fujitsu, muestra el escaneo directo de la retina con tecnología LBS al menos desde 2016.El acuerdo cambia el rumbo de TDK. Oqmented se dedicaba al LBS basado en guías de ondas. En ese esquema, la guía de ondas expande la pupila y, a la salida, la imagen se comporta más bien como la de una pantalla plana: la luz deja de ser «maxwelliana», es decir, deja de no requerir enfoque. El espejo de TDK, en cambio, está pensado para la proyección directa sobre la retina, el camino que antes siguieron Microvision, Bosch, North Focals, Intel Vaunt y Eyeway Vision. Las guías de ondas ofrecen una zona de visión mucho mayor y evitan los inconvenientes de un trayecto láser abierto desde el proyector de la patilla hasta el ojo. Cuando el haz viaja por el aire, una mota de polvo en una superficie o un solo cabello en su trayectoria pueden proyectar sobre parte de la imagen una sombra grande y nítida, y además surgen recelos sobre la seguridad ocular. En el sitio web de TDK sigue figurando el enfoque de guías de ondas, así que la compañía, al parecer, desarrolla ambas vías.El espejo dirige la luz del escáner hacia el ojo mediante nanoestructuras de entre 200 nm y 1 µm de tamaño. Un espejo normal reflejaría la luz del proyector situado en la patilla con un ángulo tal que pasaría de largo del ojo. La estructura se fabrica con una tecnología similar a la de los semiconductores, sobre un sustrato delgado. Se puede integrar en una lente de gafas convencional, probablemente intercalada entre dos mitades de la lente, como se hace hoy con las guías de ondas. En el esquema de TDK, el haz del proyector va casi paralelo a la montura hasta un segundo espejo situado junto a la lente. Desde allí incide sobre el nanorreflector con un ángulo muy rasante, de modo que el recorrido por el aire sigue siendo corto. La versión actual funciona solo en verde, y el tamaño de las estructuras probablemente depende de la longitud de onda, como en las guías de ondas difractivas. TDK afirma que está acelerando el trabajo en una demo a todo color y prevé la producción en masa «en los próximos años». Aquí, «metaóptica» significa óptica plana con estructuras subondas y no tiene nada que ver con la empresa Meta. Además, las redes de las guías de ondas, con subestructuras complejas de menos de 100 nm, ya difuminan el límite entre redes y metasuperficies.En MicroLED and AR/VR/MR Connect 2026, TDK mostró una breve demostración funcional de lo que Oqmented llamaba originalmente «escaneo de Lissajous progresivo» (Progressive Lissajous Scanning). Ahora el sitio web de TDK lo denomina escaneo de Lissajous «coherente», el mismo término que Meta usó en SPIE AR/VR/MR 2025, aunque TDK asegura que llegó a la idea de forma independiente. En el escaneo de Lissajous, un único espejo se controla con dos senoidales y el haz describe una trayectoria parecida a un ocho. El eje rápido de Oqmented funciona a 20-40 kHz. En el LBS de trama todo es distinto: el eje vertical funciona a unos 60-120 Hz y el horizontal a 20-60 kHz. En el escaneo de Lissajous, el eje lento se acerca mucho más en velocidad al rápido, por lo que el haz sigue trayectorias diagonales muy curvadas. Tradicionalmente, los píxeles se escriben de forma pseudoaleatoria, cuando el haz pasa por ellos, y el láser se modula teniendo en cuenta tanto el brillo como la velocidad del haz. Como resultado, durante los movimientos sacádicos del ojo se ven fotogramas incompletos y el propio patrón de escaneo.La variante coherente conserva el mismo movimiento del espejo, pero dibuja los píxeles en el orden de barrido del haz, formando segmentos curvos similares a una trama. El láser se apaga mientras el haz da la vuelta lentamente en cada extremo de la trayectoria. Así desaparece la fragmentación de la imagen durante los movimientos sacádicos, pero las limitaciones fundamentales permanecen. Hay que remuestrear la cuadrícula rectangular de píxeles sobre líneas de escaneo curvas que nunca coinciden exactamente con un píxel, y según la teoría básica de Nyquist esto cuesta aproximadamente un factor de dos en resolución efectiva por eje. Para que la mayoría de las personas no perciban parpadeo, cada punto debe refrescarse, incluso en el peor caso, a más de unos 90 Hz. Con un eje rápido de 40 kHz, tras el remuestreo resultan unas 300 líneas efectivas. A modo de comparación: NTSC, con una frecuencia de línea de unos 15 kHz, ofrecía 720×480 entrelazado a 60 Hz, sin ningún remuestreo sobre una cuadrícula curva. Históricamente, los sistemas LBS han tenido que elegir entre parpadeo y resolución.El prototipo de Oqmented/TDK que se mostró, de baja resolución, sí eliminó la fragmentación de la imagen, pero aún se apreciaba cierto parpadeo. Entre otros desarrollos de combinadores, CREAL trabaja en un combinador HOE. También surgen enfoques más radicales, como los minespejos activos de Gixel y el combinador de cristal no lineal de Smith Display.
- Public
- 13 Nov, 2026
Apple confirma que no abandona visionOS en una sesión para desarrolladores de computación espacial
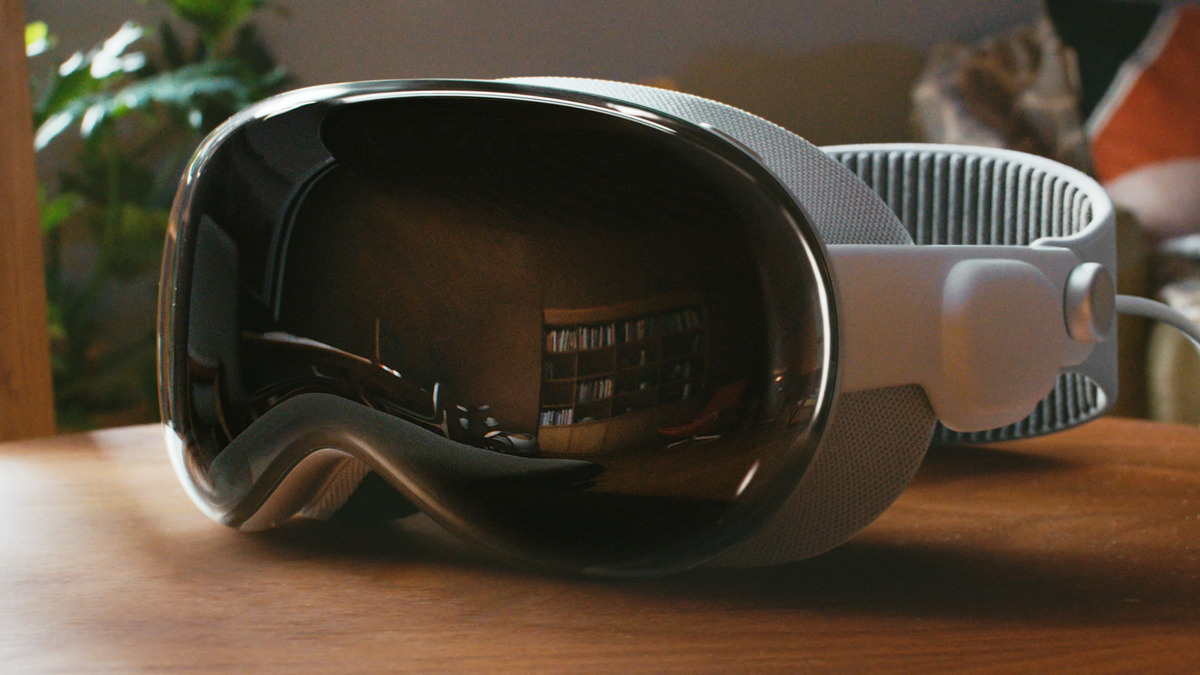
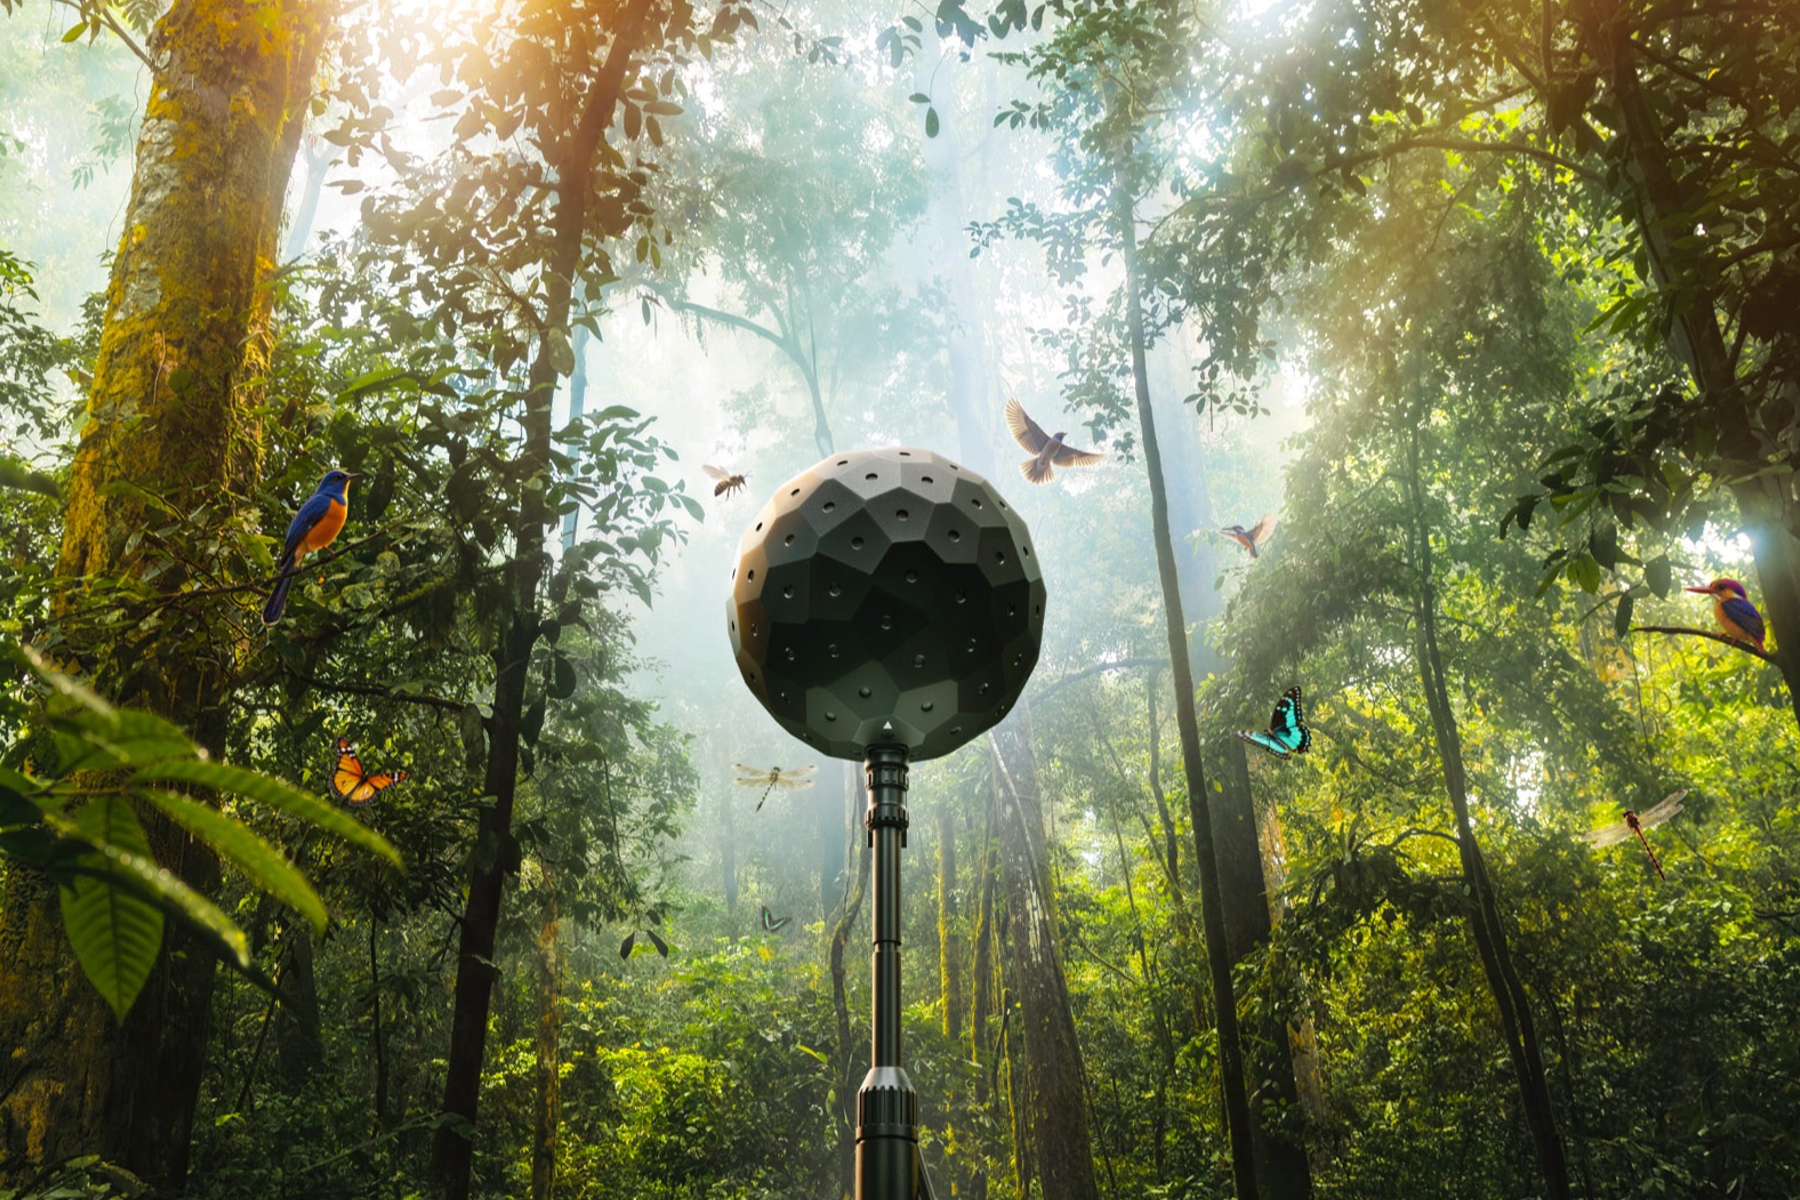
Apple celebró una sesión para desarrolladores de un día completo, «Meet with Apple», dedicada íntegramente a visionOS, su plataforma de computación espacial, y la aprovechó para responder a las dudas sobre sus planes de XR que se habían acumulado durante meses. Yuri Imoto, product manager de la división Spatial Computing de Apple, declaró que la compañía está «muy comprometida con la plataforma» y señaló que la computación espacial ha avanzado rápidamente en poco tiempo. Como áreas clave para la plataforma, el evento destacó la cirugía, la sanidad, la educación, la formación del personal y el cine inmersivo.Uno de los anuncios más destacados fue el nuevo micrófono ambisónico profesional de Blackmagic. Incorpora una matriz de 108 micrófonos y un procesador interno que convierte de forma nativa la señal a un formato apto para el contenido espacial de Apple. Los creadores de audio inmersivo ya no tendrán que hacer una conversión aparte.Cortesía de BlackmagicEn cuanto al hardware, el último lanzamiento de visores fue la actualización de Vision Pro con el chip M5 en octubre de 2025. El visor ganó en rendimiento, la imagen es más nítida, la frecuencia de actualización es mayor y resulta más cómodo de llevar, pero aun así fue una mejora gradual y no una nueva generación. En cambio, durante el último año Apple se centró en la experiencia de uso de visionOS, tanto para usuarios comunes como para empresariales, lanzó documentales inmersivos y transmisiones de partidos de la MLB, y añadió compatibilidad con controladores y accesorios con seguimiento de terceros.Sin embargo, el compromiso con visionOS no significa necesariamente un compromiso con el Vision Pro en concreto. Apple desarrolla no solo visores de realidad mixta, sino también gafas inteligentes y dispositivos de RA, y visionOS podría funcionar de alguna forma en todos ellos, de manera similar a como hoy AndroidXR funciona en distintos dispositivos. El analista Ming-Chi Kuo informó este verano, sin confirmación de Apple, de que el Vision Pro 2 se ha retrasado a finales de 2028 o incluso a 2029, ya que Apple da prioridad a las gafas inteligentes para finales de 2027 con el fin de competir con Meta y Google/Samsung.Gafas inteligentes con AndroidXR | Cortesía de Google, Samsung
- Public
- 13 Nov, 2026
Blackmagic presenta un micrófono ambisónico con 108 cápsulas para grabar contenido para Apple Vision Pro
Blackmagic Design ha lanzado el Blackmagic Ambisonic Microphone, un micrófono profesional para grabar audio espacial en la producción de vídeo inmersivo. Es compatible de forma nativa con Apple Vision Pro. Incorpora 108 micrófonos MEMS digitales que registran todo el campo sonoro alrededor del dispositivo.Cortesía de BlackmagicUn procesador integrado aplica la geometría del array y los filtros de codificación ambisónica licenciados por Apple, y convierte en tiempo real las 108 señales originales en 64 canales de audio de 32 bits. Por eso no hacen falta cajas de conexión externas ni programas de codificación independientes. La geometría y los filtros los aportó Apple, mientras que Blackmagic se encargó de la ingeniería y el diseño. Las cápsulas quedan empotradas al ras en un cuerpo metálico facetado y macizo, tan compacto que se puede sostener con una mano o fijar a una cámara.Cortesía de BlackmagicLos datos y la alimentación viajan por un único cable USB-C. El micrófono cumple con la clase estándar de dispositivos USB, de modo que no se necesitan controladores ni plugins. El flujo de trabajo principal es su uso junto con la cámara URSA Cine Immersive: el micrófono se coloca encima, se conecta, y el audio espacial se graba directamente en los archivos inmersivos de la cámara para contenido de Apple Immersive.El micrófono también se puede conectar a un ordenador para grabar y mezclar el sonido en directo en Fairlight Live, o grabar directamente en un iPhone mediante la aplicación Blackmagic Camera. Para configuraciones de transmisión avanzadas, también está previsto un convertidor de USB a SMPTE-2110. El micrófono cuesta 1695 dólares. Aún no se ha anunciado la fecha exacta de inicio de los envíos, pero se espera que esté a la venta en diciembre.
- Public
- 13 Nov, 2026
Cómo medir y reducir el tamaño de una app de iOS con Xcode y App Store Connect
Las apps de iOS suelen crecer con cada versión: se añaden nuevos SDK, imágenes de mayor resolución y contenido sin conexión. La descarga tarda más y el dispositivo tiene más espacio ocupado. La optimización empieza por la medición, porque la principal fuente de peso es distinta en cada app: en unas son los recursos, en otras el código compilado o las dependencias integradas. El "tamaño de la app" tampoco se reduce a un único número. El tamaño de descarga, el tamaño de instalación y el espacio ocupado tras el uso se solapan, pero no son intercambiables. Por eso, en un PR, un benchmark o un informe al equipo, indica qué métrica ha cambiado y dónde se midió. Si el contenido opcional se descarga más tarde, la descarga y la instalación iniciales son más pequeñas, pero una vez descargado ese contenido acaba igualmente en el dispositivo. Background Assets, incluidos los paquetes esenciales y el contenido de descarga anticipada, pueden llegar incluso antes del primer inicio. Hay que contabilizarlos por separado y compararlos con el mismo estado de descarga.El usuario ve estas cifras en dos lugares. En la página de la app en App Store, el campo "Información → Tamaño" muestra el tamaño de instalación. Si la app usa paquetes de recursos esenciales alojados en los servidores de Apple, puede aparecer un valor "Hasta …" que incluye ese contenido. En "Almacenamiento del iPhone" se indican por separado el tamaño de la app y "Documentos y datos", que se acumulan con las descargas y el uso. Los archivos locales APP, XCARCHIVE e IPA ayudan en el diagnóstico, pero no coinciden con lo que entrega App Store: los archivos pueden contener símbolos de depuración, y un IPA universal incluye recursos para varios dispositivos. Para estimar el tamaño en dispositivos concretos, exporta un archivo Release con el comando xcodebuild -exportArchive y los parámetros -archivePath, -exportPath y -exportOptionsPlist. Con firma manual, el plist también necesita signingStyle=manual, teamID y una asignación provisioningProfiles para cada app o extensión.En la carpeta de exportación aparecerá App Thinning Size Report.txt. En él se enumeran las variantes con la descripción del dispositivo y del sistema operativo y valores como "112 MB compressed, 260 MB uncompressed". El tamaño comprimido es una estimación de la descarga y el descomprimido, de la instalación. Para examinar el bundle, elija el IPA reducido por la descripción de la variante y no por el nombre del archivo: la exportación puede incluir también un IPA universal. Descomprímalo con ditto -x -k en un directorio nuevo creado con mktemp y localice el .app en la carpeta Payload. En App Store y TestFlight el thinning funciona en gran parte de forma automática, pero conviene verificarlo. Si los recursos de dispositivos concretos aparecen en todas las variantes, revise la configuración de los catálogos de recursos y los archivos sueltos. Al comparar, mantenga fijos la configuración de compilación, la versión de Xcode, el método de firma, el método de exportación y la descripción de la variante, y después repita la comparación con los valores procesados de App Store Connect. Estas cifras también son solo estimaciones: Apple puede añadir DRM y recomprimir los archivos, y los tamaños en TestFlight pueden diferir de los de App Store.El diagnóstico comienza con un inventario de todo el bundle reducido: ejecutable principal, Frameworks, PlugIns, catálogos de recursos y recursos sueltos, localizaciones, contenido multimedia, bases de datos y modelos de ML. El comando find con stat, sort -n y tail -30 mostrará los archivos más grandes, pero son tamaños lógicos sin comprimir, es decir, solo una pista. Si importa el binario, active en Build Settings el parámetro Write Link Map File (LD_GENERATE_MAP_FILE), compile el proyecto y analice el .txt en DerivedData. Agrupe los tamaños de la sección # Symbols por índice de archivo y relacione los índices con la sección # Object files. Así se ven el código generado pesado, las bibliotecas estáticas, las plantillas de C++ y los SDK de terceros. Las sumas por símbolos muestran a quién corresponde el peso, pero no dan una contabilidad completa: no incluyen encabezados, relleno de alineación, firmas ni datos del enlazador. El inlining, la optimización de todo el módulo y LTO difuminan la pertenencia del código. Excluya los símbolos eliminados como código muerto y genere un mapa para cada target de compilación y arquitectura.Mostraremos el método de trabajo con un ejemplo sintético con cifras inventadas: se cambia una sola cosa, se recompila y se vuelve a generar el informe de la misma variante. Una aplicación con muchos recursos pesa 112 MB comprimida y 260 MB descomprimida. La estimación baja 31 MB (alrededor del 28 %) y 58 MB (alrededor del 22 %), y App Store Connect muestra 80 MB de descarga y 200 MB de instalación. El ahorro no se traslada de forma lineal: intervienen la compilación, el slicing, la compresión, la alineación y la firma. Un tutorial trasladado a entrega remota se difiere, no se elimina. Tras su descarga, el espacio ocupado vuelve a crecer unos 32 MB, y en el disco pueden coexistir el archivo comprimido y los archivos extraídos. Por ello, pruebe el funcionamiento sin conexión, los reintentos, la limpieza y la nueva descarga, y mida las actualizaciones delta por separado.Los recursos suelen pesar más que el código. Mantenga las imágenes incluidas en la app dentro de .xcassets para que el app thinning elija los recursos adecuados para cada dispositivo. El número de píxeles debe corresponder al tamaño en pantalla: un icono de 24 × 24 puntos necesita 48 × 48 píxeles para 2x y 72 × 72 para 3x, y hay que reducirlo antes de importarlo. Use gráficos universales compartidos, añada variantes por dispositivo o gama de color solo cuando sea necesario y no duplique los conjuntos de imágenes. Tras la migración, cargue las imágenes por nombre, por ejemplo UIImage(named: "toolbar_search"), y elimine las copias sueltas restantes de Copy Bundle Resources. Confirme el resultado comparando los informes de la misma variante antes y después. Para los iconos, es preferible usar los SF Symbols del sistema, si el diseño y la versión mínima del sistema operativo lo permiten.