NVIDIA cuPhoton.xBeam traslada a la GPU la correlación de los datos de interferometría de agujeros negros
 Public
- 14 Nov, 2026
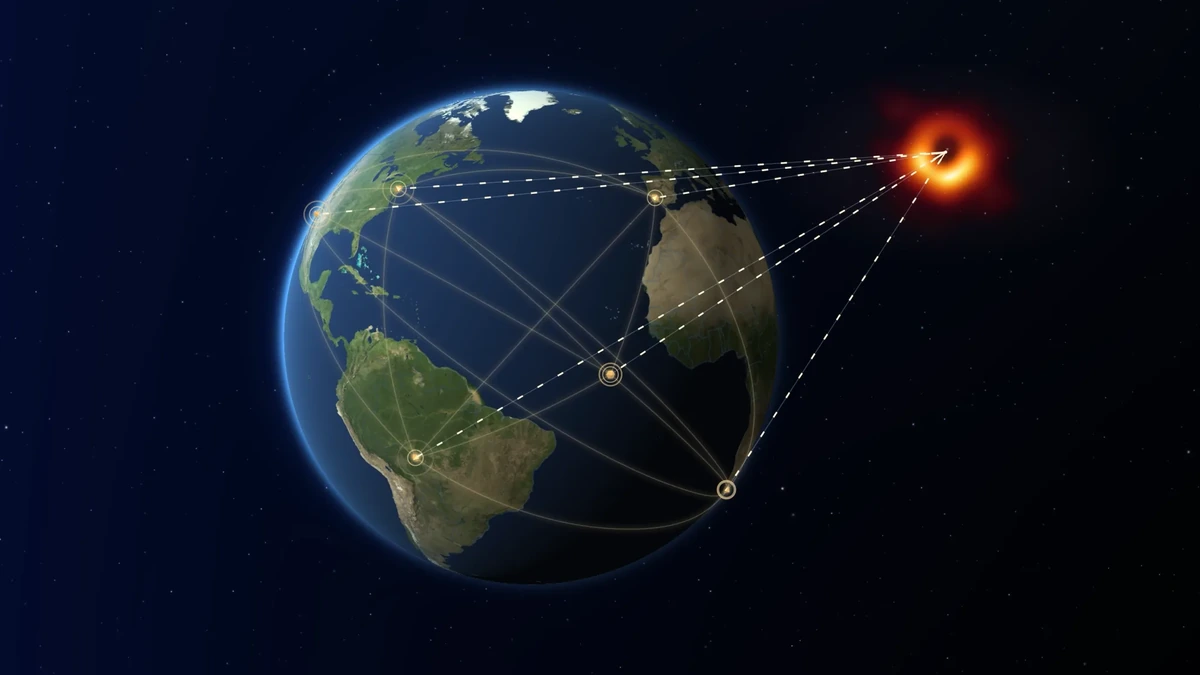
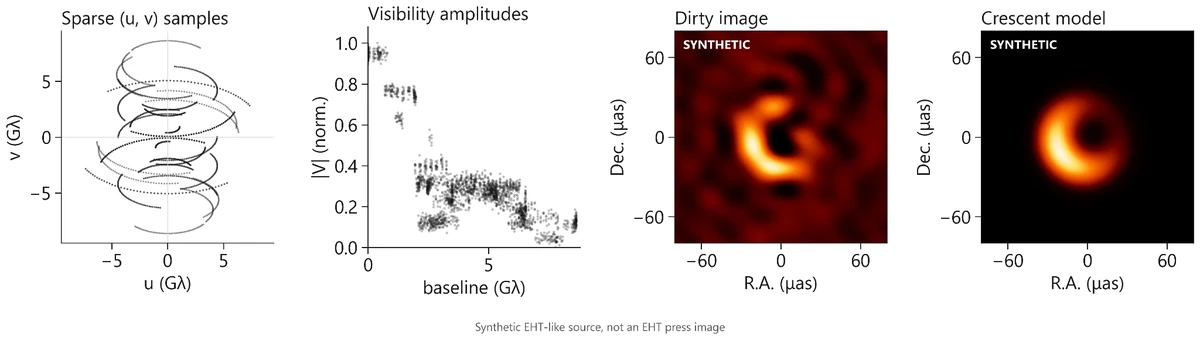
Obtener la imagen de un agujero negro exige resolver un objeto diminuto: el anillo observado de M87* abarca apenas 42 microsegundos de arco. El Event Horizon Telescope (EHT) conecta 13 radioestaciones, entre ellas las de Hawái, Chile, España, México y el Polo Sur, mediante interferometría de línea de base muy larga (VLBI). Cada estación registra dos polarizaciones a hasta 64 gigabits por segundo, de modo que se acumulan petabytes de datos de voltaje. La correlación de pares de telescopios produce visibilidades. Se trata de muestras de Fourier dispersas del brillo del cielo a lo largo de las trayectorias que traza la rotación de la Tierra. A partir de esas muestras, los algoritmos de reconstrucción resuelven un problema inverso. Con fuentes variables como Sgr A*, que cambian durante la propia sesión de observación, la tarea resulta todavía más difícil. El EHT de nueva generación (ngEHT) planea añadir más estaciones para mejorar la calidad de las imágenes y seguir los cambios a lo largo del tiempo.
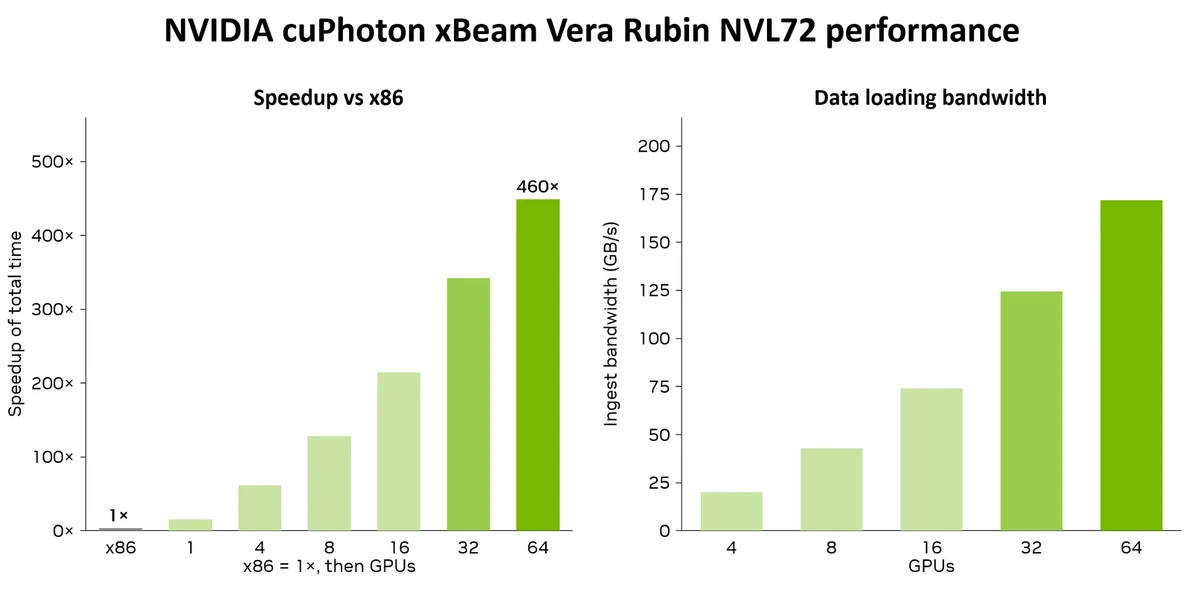
NVIDIA cuPhoton.xBeam es un correlador FX basado en GPU. A partir de grabaciones sin procesar, obtiene una visibilidad compleja por cada par de estaciones, canal de frecuencia e intervalo de tiempo corto. El correlador se desarrolló junto con el Centro de Astrofísica Harvard-Smithsonian y el Observatorio MIT Haystack. En un sistema NVIDIA Vera Rubin NVL72 procesó un conjunto de datos de 10 TB en 70 segundos. Para ello se necesitaron 64 GPU y GPUDirect Storage en modo de compatibilidad. Es aproximadamente 460 veces más rápido que con un procesador x86, que tardó 31 992 segundos, es decir, 8,89 horas. La calibración y la formación de imágenes posteriores, por ejemplo los modelos tridimensionales de gas basados en Gaussian splatting, no forman parte de cuPhoton. xBeam no calcula los retardos a partir de las coordenadas de las estaciones ni traza las trayectorias de la luz. Los resultados se validan con el correlador abierto para CPU DiFX, y los datos de salida están pensados para herramientas como HOPS, rPICARD y eht-imaging.
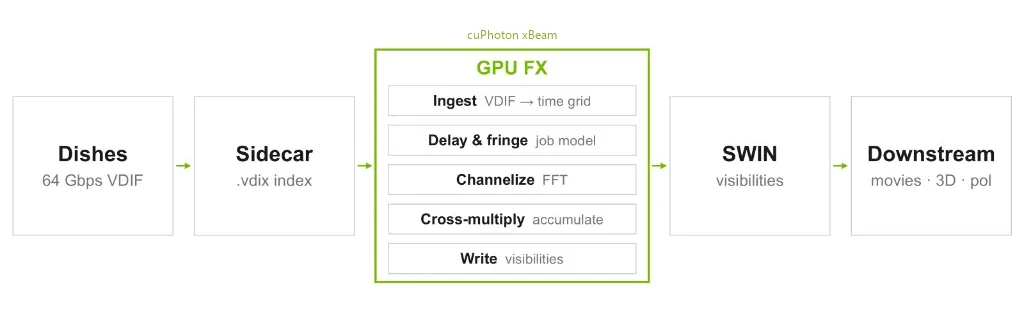
El flujo de procesamiento consta de cinco etapas. En la etapa de ingesta, cada trama VDIF se coloca en su posición temporal. Junto a ella se crea un archivo .vdix que indexa las tramas por marca de tiempo, hilo y ubicación física, sin copiar los datos. Los datos ausentes o no válidos se marcan de forma explícita. En la etapa de corrección de retardo y de fase de franjas, los datos se alinean antes de la FFT con precisión de una muestra entera y se les aplica la rotación de fase de franjas. El retardo fraccionario restante se compensa con una corrección de fase dependiente de la frecuencia.
El retardo se toma del archivo de trabajo. Se compone de un polinomio geométrico alrededor de t0, el desfase y la deriva del reloj de cada estación y el desfase de reloj de cada banda. Dentro de una misma FFT, el retardo puede ser constante, lineal o parabólico, y esto lo determina el parámetro fringe_approximation_order (0, 1 o 2). En la etapa de canalización se ejecuta una FFT para cada estación. En la etapa de multiplicación cruzada con acumulación, el espectro de una estación se multiplica por el conjugado complejo del espectro de la otra. Los datos de entrada no válidos se enmascaran y el resultado se normaliza con los pesos de exposición. La salida tiene formato DiFX SWIN o xbeam-v1.
La versión 0.1.3 acepta un trabajo normalizado en JSON (versión de esquema 1) o un archivo DiFX .input compatible. En él se enumeran las estaciones, los relojes, las frecuencias, los flujos de datos VDIF, las líneas base y los escaneos. El directorio de salida debe ser nuevo. El comando cuphoton xbeam inspect-vdif RECORDING.vdif --json lee solo las cabeceras. El comando build-vdif-sidecar con los parámetros --index-dir, --backend cufile (o posix, si no se dispone de GPUDirect Storage) y --devices crea índices reutilizables, mientras que los archivos de origen permanecen sin cambios. El comando cuphoton xbeam correlate JOB.json con --backend cupy ejecuta la correlación en la GPU. De forma predeterminada, los datos se leen mediante POSIX a través de memoria del host fijada (pinned), y con --vdif-io cufile - mediante GPUDirect Storage. Entre las opciones se incluyen --scan, --first-integration y --integration-count. Desde Python se puede llamar a load_job y correlate con CorrelationWindow y obtener registros uno a uno, pero la escritura en SWIN solo está disponible desde la CLI.
Para grabaciones con huecos hay un perfil --profile interop-real-usb-buffered-window-replay-v1. Con este perfil, las muestras dentro del búfer retenido siguen leyéndose con la referencia temporal anterior hasta que aparece un nuevo punto de anclaje. El perfil también determina qué bloques FFT se tienen en cuenta y cómo se informan los pesos. No recupera las muestras perdidas, y un peso completo no garantiza que los datos estén completos. Sin el perfil, los fotogramas se alinean por las marcas de tiempo de las cabeceras, las ranuras vacías se marcan como no válidas y, por tanto, las visibilidades y los pesos pueden diferir. Al escalar, un scan se divide en el tiempo. En un solo nodo, --devices 0,1,2,3 lanza un proceso por cada GPU, escribe los resultados en RUN/shards/ y los combina. En varios nodos, cada proceso recibe --shard-count y --shard-index, por ejemplo 64 con los índices 0-63, con la misma configuración de escaneos e integraciones. Luego merge-shards combina los resultados parciales de SWIN.