Blog
 Public
- 16 Nov, 2026
Lambda verbindet mehr als 10.000 GPUs mit NVIDIA Photonics Switches mit Co-Packaged Optics
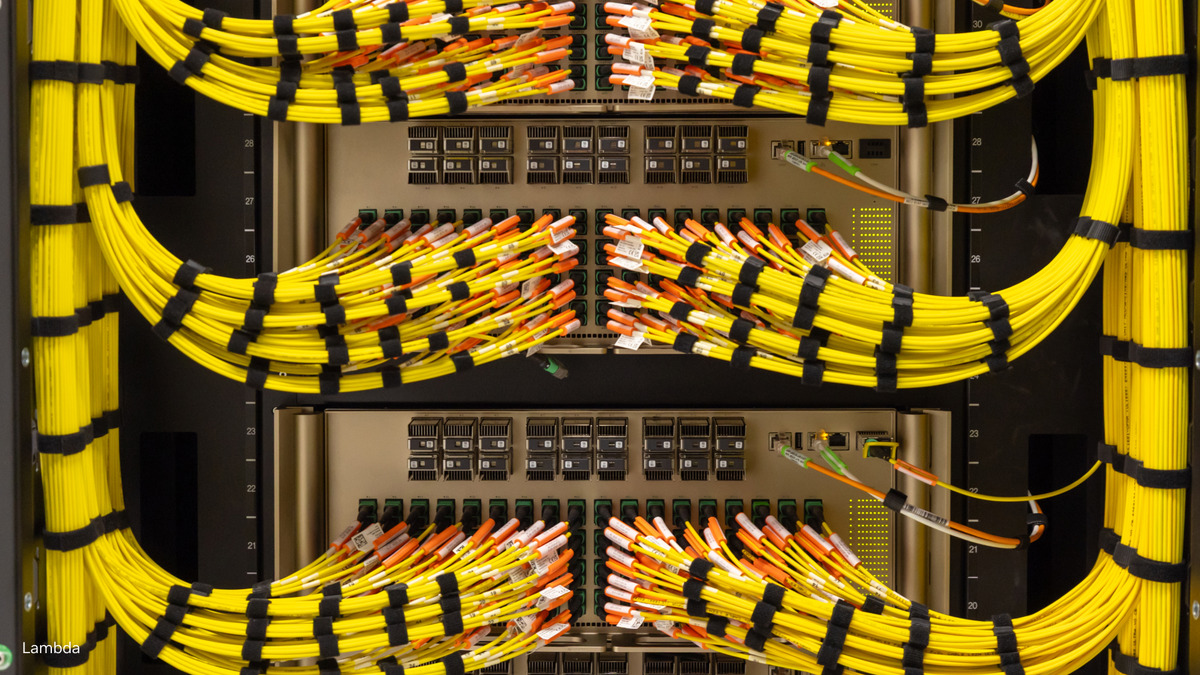
Lambda hat NVIDIA Photonics Switches mit Co-Packaged Optics (CPO) bereitgestellt und damit NVIDIA GB300 NVL72 Racks verbunden, die zusammen mehr als 10.000 GPUs umfassen. Ziel des Unternehmens war ein Netzwerk für groß angelegtes KI-Training und KI-Inferenz, das weniger Energie verbraucht, widerstandsfähiger gegenüber Ausfällen ist und länger ohne Unterbrechungen läuft (höhere MTBI, Mean Time Between Interruptions) als herkömmliche Lösungen.In den Tests von Lambda sank die Netzwerklatenz auf Rack-Ebene um etwa 4 % und auf Pod-Ebene um bis zu etwa 10 %. Der Durchsatz blieb in allen Konfigurationen auf dem Niveau herkömmlicher steckbarer Optik: auf Ebene des Racks, der skalierbaren Einheit und des Pods. Das Netzwerk ist hier entscheidend: Fällt bei einem großen Trainingsjob auch nur eine einzige Verbindung aus, können Tausende GPUs stillstehen, und bei agentenbasierter Inferenz kann sich eine einzige Störung kaskadenartig ausbreiten und die Antworten vieler Agenten verzögern. Zudem fehlt jedes Watt, das für das Netzwerk aufgewendet wird, bei der Rechenleistung.Bei diesen Switches ersetzen optische Engines, die direkt im Switch-Gehäuse neben dem Chip sitzen, die steckbaren Transceiver. Laut NVIDIA ist diese Bauweise bis zu 5-mal energieeffizienter und bis zu 15-mal zuverlässiger als steckbare Optik: Sie kommt mit viermal weniger Lasern aus und hat damit auch weniger Bauteile, die ausfallen können. Jeder Switch in der Installation von Lambda bietet 144 Ports mit je 800 Gbit/s, und eine Flüssigkeitskühlung führt die Wärme vom Switch-Chip und den optischen Engines ab. Nach Messungen von Lambda lag die mediane Temperatur der Optik bei 36 °C gegenüber 51 °C bei steckbaren Modulen, zudem war die Signalintegrität stabiler.Das Licht stammt aus 18 abnehmbaren externen Lichtquellen pro Switch. Sie speisen die optischen Engines, die elektrische Signale in Lichtsignale umwandeln, die dann über Glasfaser durch den gesamten Cluster laufen. Diese Module lassen sich direkt vor Ort austauschen, während bei einem Laserausfall in einem steckbaren Modul das ganze Modul ersetzt werden muss. Außerdem verkürzt sich durch das Co-Packaging der elektrische Pfad von Zoll auf Millimeter: Es geht weniger Signal verloren, und Retimer-Chips werden überflüssig. Dadurch sinkt der Stromverbrauch, und im Signalpfad verbleiben weniger Komponenten.
- Public
- 16 Nov, 2026
Android XR erhält OpenXR Spatial Containers für Apps mit mehreren Engines
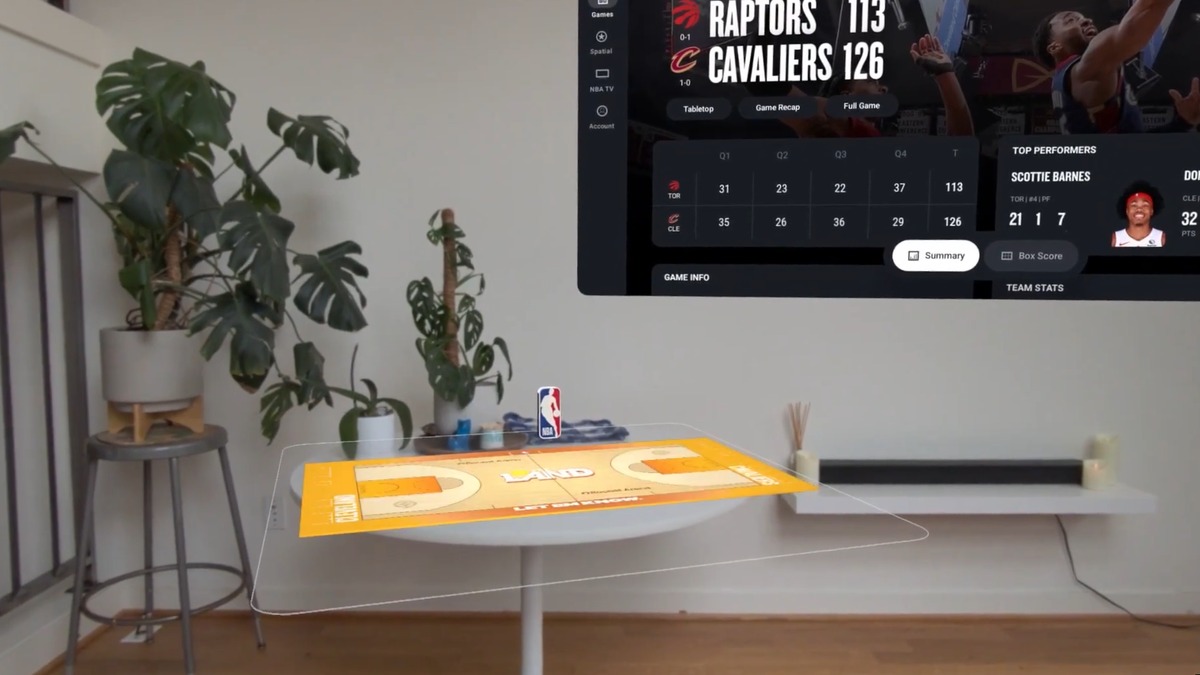
Android XR unterstützt jetzt die kürzlich standardisierten OpenXR-Spatial-Container-Erweiterungen. Voraussetzung ist ein Gerät mit Spatial API Level 4 oder höher, und die App muss im Full-Space-Modus laufen. Die Erweiterungen definieren vom System verwaltete Räume, in denen eine Anwendung volumetrische 3D-Inhalte anzeigt. Das ähnelt der Art, wie ein Desktop-Betriebssystem 2D-Inhalte in Fenstern platziert.Bisher übernahm eine OpenXR-Sitzung unter Android XR die exklusive Kontrolle über das Display. Mit Spatial Containers kann eine App 3D-Inhalte innerhalb eines begrenzten 3D-Volumens rendern oder in einen unbegrenzten immersiven Modus wechseln, in dem sie sich wie eine herkömmliche OpenXR-App verhält. Fenstersteuerung und Platzierung jedes Containers übernimmt das System. Ist ein Container fokussiert und interaktiv, können Nutzer seine Inhalte direkt per Hand-Tracking, Blicksteuerung oder 6DoF-Controllern bearbeiten.Der wichtigste praktische Vorteil besteht darin, dass sich in einer App nun verschiedene Technologien kombinieren lassen. Eine Oberfläche in Jetpack Compose, gewöhnliche 2D-Activities von Android und 3D-Inhalte auf Basis von OpenXR können jetzt nebeneinander bestehen. Der 3D-Teil lässt sich mit Engines wie Unity oder Godot rendern oder direkt in nativem OpenXR schreiben. Die NBA-App gehört zu den ersten, die dies nutzen, und zwar für die Funktion Court View. Die Hauptoberfläche ist in Compose umgesetzt, während für ausgewählte Spiele volumetrische 3D-Spielfelder angezeigt werden, die Unity rendert. Die Funktion entspricht Tabletop in der NBA-App für Apple Vision Pro, das ebenfalls in Court View umbenannt wurde.Auf Ebene des Standards könnten Spatial Containers Apps ermöglichen, die denen für visionOS ähneln. Dort sorgen die Shared-Space-Architektur und RealityKit dafür, dass Fenster- und volumetrische Apps nebeneinander laufen und in die vollständige Immersion von Full Space wechseln können. Die erste Umsetzung in Android XR ist bescheidener. Container benötigen den Modus Full Space Managed statt Home Space, des Multitasking-Modus. Eine App kann mehrere eigene Container anzeigen, jedoch nicht neben den Inhalten anderer Apps. Das passt dazu, dass Android XR räumliche Komponenten nur in Full Space zulässt.Vorerst ermöglicht die Funktion eher Apps mit mehreren Engines als räumliches Multitasking zwischen verschiedenen Apps. Das deckt sich mit Googles Beschreibung als „Multi-Engine-Erlebnisse" (multi-engine experiences), als das Unternehmen diese Funktionen Anfang des Jahres auf der I/O erstmals vorstellte. Bis zum vollwertigen räumlichen Multitasking, wie es visionOS auf Apple Vision Pro und Pico OS 6 auf der kommenden Pico Space Pro bieten, ist es noch ein weiter Weg.
- Public
- 16 Nov, 2026
20 Jahre CUDA: von den ersten GPU-Programmen zu 11 Millionen Entwicklern
Auf der Supercomputing-Konferenz SC26 feiert NVIDIA das 20-jährige Jubiläum von CUDA und würdigt die Forscher, Entwickler und Ingenieure, die GPU-Computing zu einem Fundament der modernen Wissenschaft und KI gemacht haben. Die Plattform wurde im November 2006 angekündigt und auf der SC06 der wissenschaftlichen Gemeinschaft vorgestellt. Sie bot Entwicklern ein vertrautes High-Level-Programmiermodell für GPUs und trug beschleunigtes Rechnen weit über die Grafik hinaus: in Simulationen und andere rechenintensive Aufgaben.Zwei Jahrzehnte später entwickeln mehr als 11 Millionen Entwickler auf CUDA, und zwar auf allen Ebenen des Computing-Stacks. Die Plattform steht hinter mit dem Nobelpreis ausgezeichneter KI-Forschung, hinter wissenschaftlichen Anwendungen auf Supercomputern und hinter visuellen Effekten in oscarprämierten Filmen. Heute umfasst das Ökosystem mehr als 1.000 CUDA-X-Bibliotheken. Sie werden in der Wirkstoffforschung, bei der Planung von Fabriken, in autonomen Fahrzeugen, bei der Modellierung von Finanzmärkten und im Quantencomputing eingesetzt.Zu den frühen Meilensteinen gehört die Arbeit des Teams um den Biophysiker Klaus Schulten an der University of Illinois Urbana-Champaign. Die dort entwickelten Werkzeuge Nanoscale Molecular Dynamics und Visual Molecular Dynamics verbanden GPU-Computing mit der Molekularbiologie. Im Jahr 2013 entschlüsselten Forschende aus Illinois, der University of Pittsburgh und der Vanderbilt University mithilfe CUDA-beschleunigter Werkzeuge die atomare Struktur des HIV-Kapsids. Dazu kombinierten sie Experimente mit Simulationen auf Blue Waters, damals einem der leistungsstärksten Supercomputer der Welt.Im Bereich KI trainierten die Forscher Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton von der University of Toronto mithilfe von CUDA das Modell AlexNet auf nur zwei NVIDIA-GPUs. Das Bilderkennungsmodell gewann 2012 den ImageNet-Wettbewerb und zeigte, was GPUs für Deep Learning leisten können. Später teilten sich Demis Hassabis und John Jumper den Nobelpreis für Chemie 2024 für die Vorhersage von Proteinstrukturen mit AlphaFold. Die von ihrem Team öffentlich veröffentlichte Software AlphaFold 2 nutzt CUDA für die Ausführung auf GPUs.Diese Beispiele zeigen, wie die Arbeit einer Generation der nächsten neue Türen öffnet. Das CUDA Toolkit ist nach wie vor der Einstiegspunkt für die Entwicklung auf der Plattform. Am Stand von NVIDIA auf der SC26 gibt es zudem anlässlich des Jubiläums die 20-Year CUDA Celebration Event Wall.
- Public
- 16 Nov, 2026
Unity Fellowship vergibt Zuschüsse von je 50.000 $ an zehn Indie-Studios
Unity hat Unity Fellowship gestartet, ein Programm zur finanziellen Hilfe und Unterstützung für unabhängige Spielestudios. Ausgewählt werden zehn Teams, deren Spiele etwa in einem Jahr erscheinen sollen. Sie erhalten Zugang zu Ressourcen, Unterstützung und nützlichen Kontakten. Jedes Team bekommt einen Zuschuss von 50.000 $. Dafür müssen keine Anteile am Studio abgegeben werden, und das Geld muss auch nicht zurückgezahlt werden. Die Studios entscheiden selbst, wie und wann sie die erhaltenen Mittel einsetzen, und behalten die volle kreative Kontrolle sowohl über die Vision ihres Spiels als auch über ihre Geschäftsstrategie.Unity sucht nach außergewöhnlichen Spielen mit einer starken kreativen Vision. Bewerber müssen ein Video mit Spielszenen, einen spielbaren Build und einen Entwicklungsplan einreichen und erläutern, wie die Ressourcen des Programms das Projekt voranbringen würden. Das Programm richtet sich vor allem an Teams ohne Publisher, doch auch Studios, die bereits einen Publisher haben, können sich bewerben. Alle Inhalte im Spiel, einschließlich der mit KI erstellten, müssen dem Bewerber gehören oder er muss die Rechte daran besitzen.Nicht alle Regionen sind teilnahmeberechtigt. Unity nimmt keine Bewerbungen von Entwicklern aus Ländern und Gebieten an, die US-Sanktionen unterliegen, sowie aus Brasilien, Italien und der Provinz Quebec. Das Programm richtet sich an Indie-Studios, die ihre Spiele mit Unity entwickeln. Die ausgewählten Teams werden im März 2027 auf der GDC bekannt gegeben.
- Public
- 16 Nov, 2026
FunFitLand auf Meta Quest bietet jetzt Multiplayer-Workouts, denen man jederzeit beitreten kann
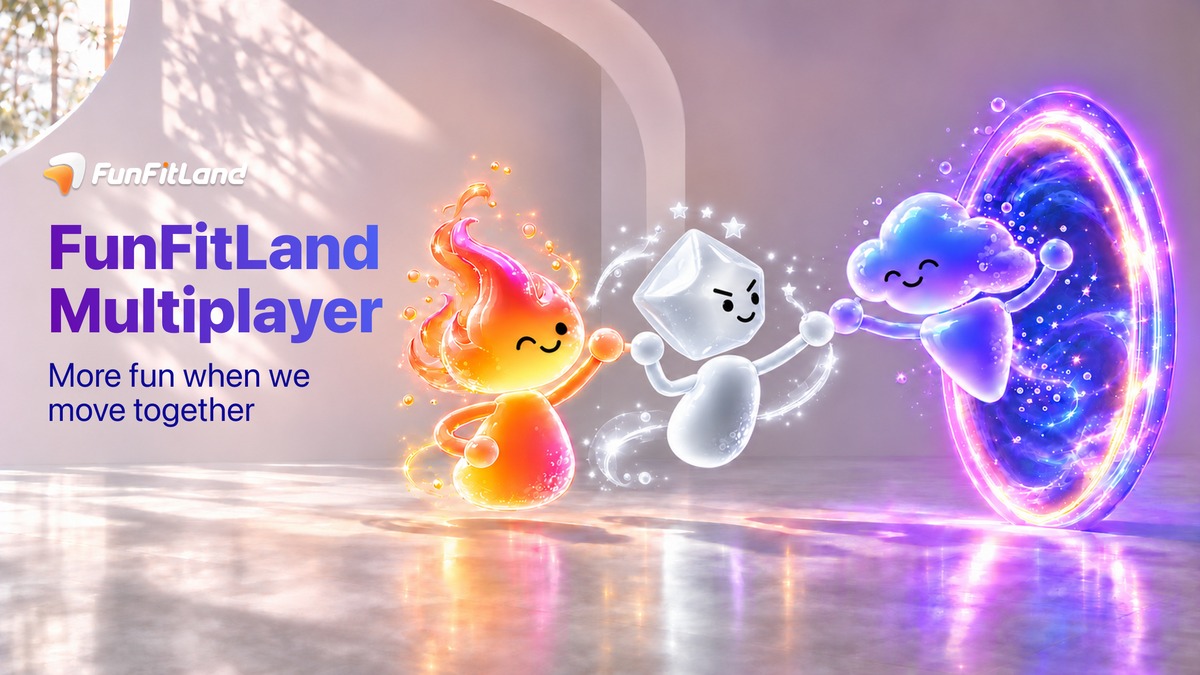
FunFitLand, eine VR-Fitness-App für Meta Quest, hat jetzt einen Multiplayer-Modus. Er behebt eine der größten Schwächen von VR-Workouts zu Hause: Den Menschen fehlen der soziale Kontakt und die Motivation, die gemeinsames Training in einem echten Fitnessstudio mit sich bringt. Alle Trainingsarten der App unterstützen den Multiplayer: CombatFit (Rhythmus-Boxen), GrooveFit (Tanz), SwingFit (fließende Bewegungen mit Schlägern), FlowFit (ruhige, von Zen und Tai-Chi inspirierte Bewegungen) und Space, eine Reihe meditativer virtueller Umgebungen, in denen überhaupt nicht trainiert wird. In Space kann eine Gruppe einfach zusammen abhängen und plaudern, zum Beispiel während des Cool-downs. Das passt zum Ziel der Entwickler: Die App soll nicht nur ein Fitnessprogramm sein, sondern auch ein Ort, an den man für sein Wohlbefinden kommt.Mehrspielermodus von FunFitLand. Foto: FunFitLandAußerdem haben die Entwickler das Problem der leeren Lobby gelöst. In anderen VR-Fitness-Apps beginnt ein Gruppentraining erst, wenn die ganze Gruppe versammelt ist. In FunFitLand kann man einen Raum allein eröffnen und sofort mit dem Training beginnen, bis zu drei weitere Personen können dann mitten in der Session dazukommen. Rund drei Wochen hat das Team in eine einzige technische Aufgabe gesteckt: Ein Neuankömmling soll genau an der Stelle einsteigen, die der Gastgeber des Raums erreicht hat, selbst wenn gerade die letzten fünf Sekunden des Cool-downs laufen. Räume lassen sich mit Sprach-Tags versehen: Die Nutzer der App leben auf der ganzen Welt, und so sieht man sofort, ob die Teilnehmer einer Session deine Sprache sprechen.Das Multiplayer-Menü. Foto: Autor.Die Sprachauswahl. Foto: Autor.Im Multiplayer erscheinen die Spieler als niedliche Cartoon-Figuren. Man kann aus mehreren Varianten eine Kopfform und ein „Gesicht“ wählen und die Farbakzente anpassen. Die Entwickler setzen darauf, dass man mehrere Avatare hat und sie je nach Stimmung wechselt. Zudem verbirgt der Avatar das eigene Aussehen, sodass manche ungezwungen trainieren, ohne sich zu genieren. Andere Apps gehen anders vor: FitXR nutzt Meta-Avatare, während die alte Version von Supernatural die Nutzer als „verschwommene“ Körpermodelle darstellte. Den Multiplayer des neuen Supernatural hat man bisher noch nicht gezeigt. Das Aussehen der Avatare in FunFitLand wurde viele Male anhand des Feedbacks des internen Teams und externer Betatester aus der Facebook-Community der App überarbeitet.Die Ziele fliegen über mehrere Bahnen heran, und man muss sich um ganze 360º bewegen. Wenn sich die seitlichen Bahnen öffnen und von dort Ziele kommen, wird der Avatar des Partners halbtransparent, damit die heranfliegenden Ziele gut sichtbar bleiben. Auch dieses unauffällige Detail ist aus Nutzertests und Feedback entstanden. Mit der Option „Cool-down überspringen" lassen sich Gruppenworkouts problemlos direkt hintereinander absolvieren. Das Studio bezeichnet den Mehrspielermodus als zentralen Bestandteil seines Plans, Menschen durch Bewegung, achtsames Training und Gemeinschaft zu verbinden, und kündigt weitere Funktionen an. FunFitLand ist kostenlos für Meta Quest erhältlich. Das Abo kostet 9,99 $ pro Monat oder 99,99 $ pro Jahr.
- Public
- 15 Nov, 2026
Wie ein spielfertiger 3D-Charakter sein sollte: Tipps von vier Character Artists
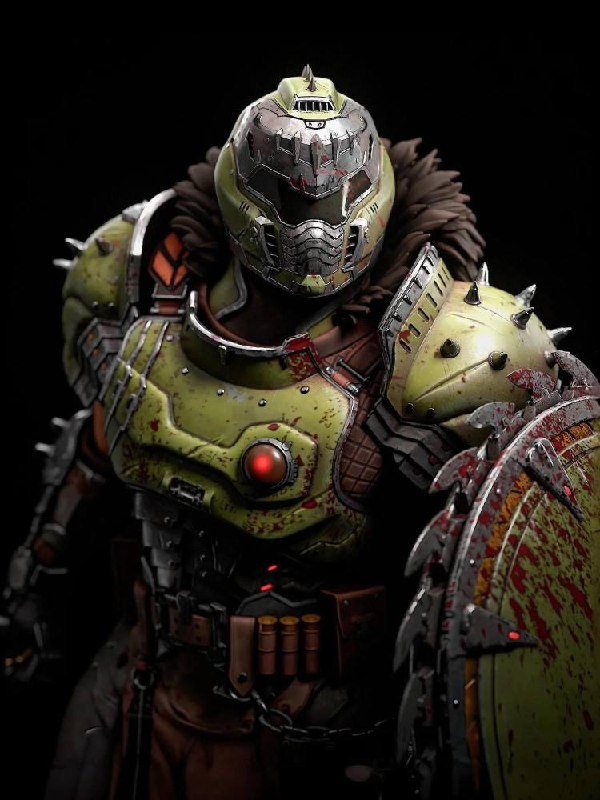
Im Mittelpunkt jedes Spiels steht ein Held, doch den Großteil des Bildschirms füllen Nebenfiguren: Gegner, Verbündete, Händler, Bosse, Wachen, Kreaturen und Statisten. Einem Protagonisten kann man aufwendige Geometrie und komplexe Materialien zugestehen. Bei NPCs geht das nicht: Hier gilt es, eine Balance zwischen visueller Wirkung, Performance, stilistischer Einheitlichkeit und Produktionseffizienz zu finden. Vier Künstler, die spielfertige Charaktere verkaufen, RyanReos, Hisqie Furqoni, Andryuha1981 und KirTheGreat, erklären, wie sie diese Balance finden.Für sie bedeutet „spielfertig“ mehr als nur „Low-Poly“. Früher beurteilte Furqoni Assets nach der Polygonanzahl. Heute achtet er darauf, ob ein Modell in die Pipeline passt: welches Rig es hat, wie es sich verformt, wie die Dateien aufgebaut sind und ob es mit der Engine kompatibel ist. KirTheGreat nennt saubere Topologie, optimierte Geometrie, korrekte UV-Layouts, PBR-Texturen sowie die Vorbereitung für Rigging und Engine-Integration. RyanReos bezeichnet das Prinzip „Plug-and-Play“ als Ideal. Seine modularen Fantasy-Charaktere sind für Unreal Engine 5 vorbereitet und werden als geriggte FBX-Dateien ausgeliefert, die sich problemlos in Unity oder Godot übertragen lassen.Der Detailgrad sollte sich nach der Rolle einer Figur richten. Andryuha1981 merkt an, dass sich Helden und große Bosse eine komplexe Geometrie leisten können, weil nur wenige von ihnen gleichzeitig auf dem Bildschirm zu sehen sind, während gewöhnliche Gegner leichter sein müssen: „Ein Spiel besteht nicht aus einer einzigen Hauptfigur." Modularität hilft, aus einem Set mehr Charaktere zu gewinnen. RyanReos hält Körper, Haare, Rüstung und Kleidung getrennt. Andryuha kombiniert Outfits, Frisuren, Waffen, Materialien und Gesichter und macht so aus einer Figur mehrere NPCs. Furqoni sorgt für die Geschlossenheit seiner Serien, indem er innerhalb eines Stils Rolle, Silhouette, Waffen und Rüstung variiert. Benennung und Ordnung der Dateien betrachtet er als „UI und UX eines 3D-Produkts".Alle vier warnen: Beim Kauf sollte man sich nicht auf ein Werbebild verlassen. Kir empfiehlt, Topologie, UVs, Texturen, Polygonanzahl, Materialien, Rig, Dateistruktur und Engine-Kompatibilität zu prüfen. RyanReos betont besonders die unterstützten Engine-Versionen: Ihretwegen funktionieren Assets im Projekt des Käufers häufig nicht. Furqoni nennt zusätzlich Texturauflösung, Rig-Typ, Dateiformate und den Lieferumfang und warnt, dass KI-generierte Werbebilder die Überprüfung noch wichtiger machen. Andryuha rät, die vollständige Beschreibung zu lesen, die Screenshots genau anzusehen und sich eine Videovorschau anzuschauen. In einem sind sich alle einig: Eine gute Figur muss sowohl zur Spielwelt als auch zur Pipeline des Spiels passen.
- Public
- 14 Nov, 2026
NVIDIA cuPhoton.xBeam verlagert die Korrelation von Interferometriedaten Schwarzer Löcher auf die GPU
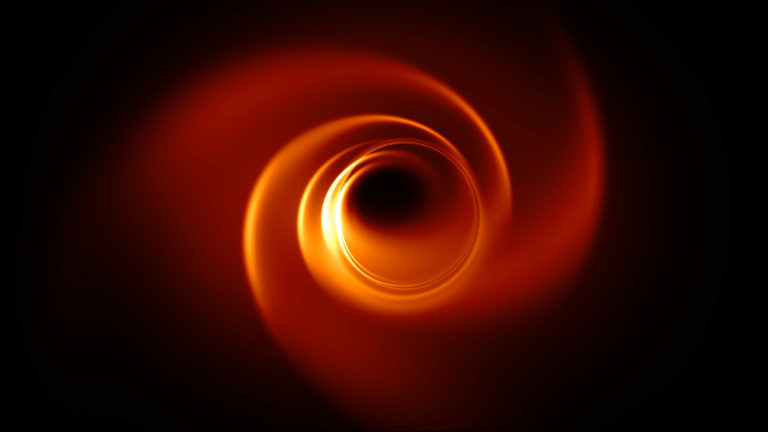
Um ein Schwarzes Loch abzubilden, muss man ein winziges Objekt auflösen: Der beobachtete Ring von M87* umfasst nur 42 Mikrobogensekunden. Das Event Horizon Telescope (EHT) verbindet 13 Radiostationen, unter anderem auf Hawaii, in Chile, Spanien, Mexiko und am Südpol, mittels Very-Long-Baseline-Interferometrie (VLBI). Jede Station zeichnet zwei Polarisationen mit bis zu 64 Gbit/s auf, sodass Petabytes an Spannungsdaten entstehen. Die Korrelation von Teleskoppaaren liefert Visibilities. Das sind spärliche Fourier-Stichproben der Himmelshelligkeit entlang von Spuren, die durch die Erdrotation gezogen werden. Aus diesen Stichproben lösen Rekonstruktionsalgorithmen ein inverses Problem. Variable Quellen wie Sgr A*, die sich noch während einer Beobachtungssitzung verändern, erschweren die Aufgabe zusätzlich. Für das EHT der nächsten Generation (ngEHT) ist geplant, weitere Stationen hinzuzufügen, um die Bildqualität zu verbessern und Veränderungen im Zeitverlauf zu verfolgen.Abbildung 2. Synthetisches Beispiel im Stil des EHT mit der Abtastung der Ortsfrequenzen, den Visibility-Amplituden, dem „schmutzigen" Bild und einem sichelförmigen ModellNVIDIA cuPhoton.xBeam ist ein GPU-basierter FX-Korrelator. Aus Rohaufzeichnungen erzeugt er jeweils eine komplexe Visibility pro Stationspaar, Frequenzkanal und kurzem Zeitintervall. Der Korrelator wurde gemeinsam mit dem Harvard-Smithsonian Center for Astrophysics und dem MIT Haystack Observatory entwickelt. Auf einem NVIDIA Vera Rubin NVL72-System verarbeitete er einen 10 TB großen Datensatz in 70 Sekunden. Dafür kamen 64 GPUs und GPUDirect Storage im Kompatibilitätsmodus zum Einsatz. Das ist etwa 460-mal schneller als auf einer x86-CPU: Dort dauerte es 31.992 Sekunden, also 8,89 Stunden. Die nachgelagerte Kalibrierung und Bildgebung, etwa 3D-Gasmodelle auf Basis von Gaussian Splatting, gehören nicht zu cuPhoton. xBeam berechnet keine Verzögerungen aus Stationskoordinaten und verfolgt keine Lichtwege. Die Ergebnisse werden mit dem Open-Source-CPU-Korrelator DiFX abgeglichen, und die Ausgabedaten sind für Werkzeuge wie HOPS, rPICARD und eht-imaging ausgelegt.Abbildung 4. Beschleunigung von cuPhoton.xBeam gegenüber der x86-CPU-Basislinie (links) und Datenaufnahme-Durchsatz (rechts) bei unterschiedlicher GPU-Anzahl auf NVIDIA Vera Rubin NVL72Die Pipeline besteht aus fünf Stufen. In der Aufnahmestufe wird jeder VDIF-Frame an seine korrekte zeitliche Position gesetzt. Daneben wird eine .vdix-Datei angelegt, die die Frames nach Zeitstempel, Thread und physischem Speicherort indiziert, ohne die Daten selbst zu kopieren. Fehlende und ungültige Daten werden dabei explizit gekennzeichnet. In der Stufe der Verzögerungs- und Fringe-Korrektur werden die Daten vor der FFT auf ganze Samples genau ausgerichtet, und es wird eine Fringe-Rotation angewendet. Die verbleibende gebrochene Verzögerung kompensiert eine frequenzabhängige Phasenkorrektur.Die Verzögerung stammt aus der Job-Datei. Sie setzt sich zusammen aus einem geometrischen Polynom um t0, Uhrenversatz und -drift jeder Station sowie einem Uhrenversatz pro Band. Innerhalb einer FFT kann die Verzögerung konstant, linear oder parabolisch sein: Das legt der Parameter fringe_approximation_order fest (0, 1 oder 2). In der Kanalisierungsstufe wird für jede Station eine FFT ausgeführt. In der Stufe der Kreuzmultiplikation mit Akkumulation wird das Spektrum einer Station mit dem komplex konjugierten Spektrum der anderen multipliziert. Ungültige Eingabedaten werden maskiert, und das Ergebnis wird mit Belichtungsgewichten normiert. Die Ausgabe erfolgt im Format DiFX SWIN oder xbeam-v1.Version 0.1.3 akzeptiert einen normalisierten Job im JSON-Format (Schemaversion 1) oder eine unterstützte DiFX-.input-Datei. Darin sind Stationen, Uhren, Frequenzen, VDIF-Datenströme, Basislinien und Scans aufgeführt. Das Ausgabeverzeichnis muss neu sein. Der Befehl cuphoton xbeam inspect-vdif RECORDING.vdif --json liest nur die Header. Der Befehl build-vdif-sidecar mit den Parametern --index-dir, --backend cufile (oder posix, falls GPUDirect Storage nicht verfügbar ist) und --devices erstellt wiederverwendbare Indizes, während die Quelldateien unverändert bleiben. Der Befehl cuphoton xbeam correlate JOB.json mit --backend cupy führt die Korrelation auf der GPU aus. Standardmäßig werden die Daten über POSIX in den gepinnten Hostspeicher gelesen, mit --vdif-io cufile - über GPUDirect Storage. Zu den Parametern gehören --scan, --first-integration und --integration-count. Aus Python lassen sich load_job und correlate mit CorrelationWindow und Datensätze einzeln abrufen, das Schreiben im SWIN-Format ist jedoch nur über die CLI möglich.Für Aufzeichnungen mit Lücken gibt es das Profil --profile interop-real-usb-buffered-window-replay-v1. Damit werden Samples innerhalb des vorgehaltenen Puffers mit der bisherigen Zeitreferenz weiter eingelesen, bis ein neuer Ankerpunkt auftritt. Das Profil legt außerdem fest, welche FFT-Blöcke berücksichtigt werden und wie die Gewichte ausgewiesen werden. Verlorene Samples stellt es nicht wieder her, und ein volles Gewicht garantiert keine vollständigen Daten. Ohne das Profil werden die Frames anhand der Zeitstempel in den Headern ausgerichtet, fehlende Slots werden als ungültig markiert, daher können Visibilities und Gewichte abweichen. Bei der Skalierung wird ein Scan zeitlich aufgeteilt. Auf einem einzelnen Knoten --devices 0,1,2,3 startet einen Prozess pro GPU, schreibt die Ergebnisse in RUN/shards/ und führt sie zusammen. Über mehrere Knoten hinweg erhält jeder Prozess --shard-count und --shard-index, zum Beispiel 64 mit den Indizes 0-63, mit identischen Scan- und Integrationseinstellungen. Anschließend merge-shards führt die partiellen SWIN-Ergebnisse zusammen.Abbildung 1. Radioteleskope zeichnen Signale auf, die zu Visibilities korreliert werden, um ein Bild zu rekonstruieren. Konzeptionelle IllustrationAbbildung 3. cuPhoton.xBeam wandelt Teleskopaufzeichnungen in Visibilities für die anschließende Bildrekonstruktion um
- Public
- 14 Nov, 2026
Kurs zur Erstellung eines game-ready Lee-Enfield-Gewehrs: die komplette Pipeline in Blender, Substance und Marmoset
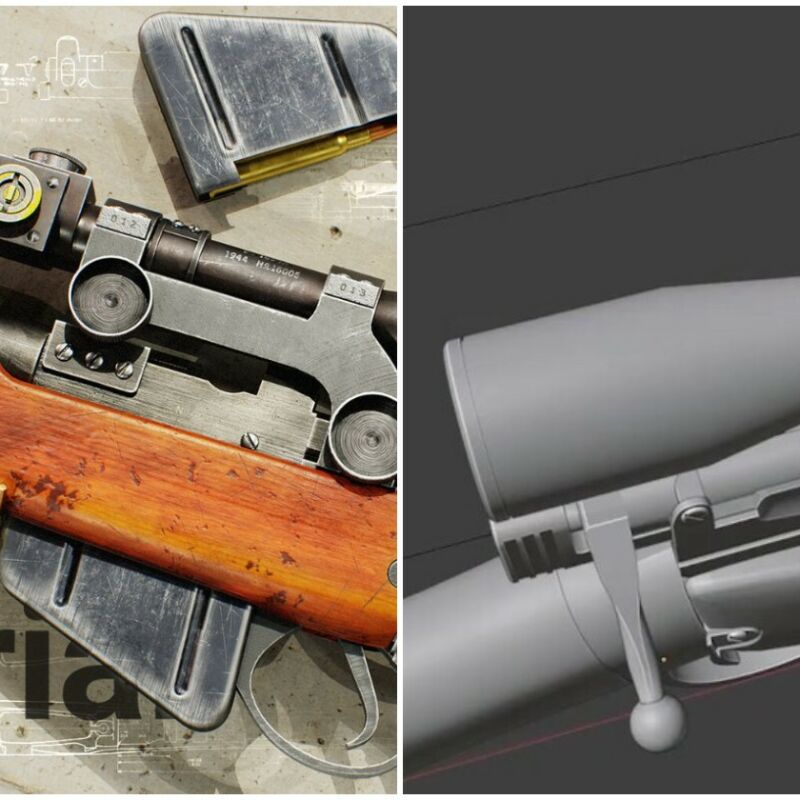
Titanium Studio hat den Kurs Mastering LEE-ENFIELD NO4 MK1 Game Ready Creation in Blender veröffentlicht. Er ist auf die reale Produktion ausgerichtet und umfasst mehr als 26 Stunden Videomaterial. Geleitet wird der Kurs von Navid Valizadeh, einem Senior Weapon and Prop Artist, der sich auf fotorealistische Assets spezialisiert hat. Das Lernprojekt ist ein vom Zweiten Weltkrieg inspiriertes Scharfschützengewehr: Es wird von Grund auf erstellt und bis zu einem ausgefeilten finalen Rendering gebracht.Das Modell wird in Blender mit professionellen Hard-Surface-Modeling-Techniken aufgebaut. Der Schwerpunkt liegt auf sauberer Geometrie, detailliert ausgearbeiteten Komponenten und einem strukturierten Workflow. Anschließend wird das Asset in Substance 3D Painter übertragen und texturiert: Die Teilnehmenden erstellen realistische Materialien, fügen Oberflächenvariationen hinzu, stellen die Rauheit ein und bringen Abnutzung sowie feine Details auf. Der Kurs vermittelt den gesamten Prozess der Asset-Erstellung und nicht nur die Bedienung einzelner Werkzeuge.In der letzten Phase wird das Gewehr in Marmoset Toolbag 5 für die Präsentation vorbereitet. Behandelt werden professionelle Beleuchtung, Materialeinrichtung, Kamerakomposition und Präsentationstechniken, mit denen sich die fertige Waffe wirkungsvoll in Szene setzen lässt. Zusammen bilden die drei Phasen eine typische Pipeline für Game-ready-Props ab, wie sie in der Produktion üblich ist.
- Public
- 14 Nov, 2026
Meta-Optics Mirror von TDK und kohärentes Lissajous-Scanning: die Rückkehr der Laser-AR-Brillen
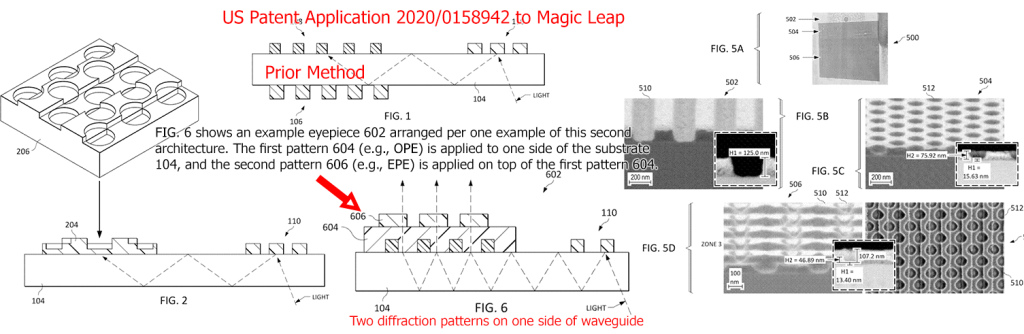
Am 2. Oktober 2026 kündigte TDK den Meta-Optics Mirror an, einen neuartigen „Freiraum-Combiner" (free-air combiner) für AR-Brillen. Der Ankündigung gingen zwei Geschäfte voraus, die früher im selben Jahr abgeschlossen wurden. Im Mai 2026 erwarb TDK die wesentlichen Vermögenswerte, das geistige Eigentum und das Team von Oqmented. Das Unternehmen stellte vakuumversiegelte MEMS-Spiegel für Laser Beam Scanning (LBS) nach Lissajous-Figuren her. Im Juni 2026 unterzeichnete TDK eine Vereinbarung über geschäftliche Zusammenarbeit mit dem Laserhersteller QD Laser: Die Unternehmen wollen gemeinsam optische Engines mit Netzhautprojektion für Smart Glasses entwickeln. Zusammen arbeiten sie mindestens seit 2020. QD Laser ist eine Ausgründung von Fujitsu und zeigt direktes Netzhaut-Scanning per LBS mindestens seit 2016.Das Geschäft ändert den Kurs von TDK. Oqmented hatte sich auf wellenleiterbasiertes LBS konzentriert. In dieser Anordnung erweitert der Wellenleiter die Pupille, und das Bild am Ausgang verhält sich eher wie bei einem Flachbildschirm: Das Licht ist nicht mehr „maxwellsch", also fokusfrei. Der Spiegel von TDK zielt dagegen auf direkte Netzhautprojektion ab, einen Weg, den zuvor Microvision, Bosch, North Focals, Intel Vaunt und Eyeway Vision verfolgt haben. Wellenleiter bieten einen deutlich größeren Sichtbereich und vermeiden die Nachteile eines offenen Laserpfads vom Projektor im Brillenbügel bis zum Auge. Verläuft der Strahl durch die Luft, können ein Staubkorn auf einer Oberfläche oder ein einzelnes Haar im Strahlengang einen großen, scharfen Schatten auf einen Teil des Bildes werfen, und bei den Nutzern entstehen Bedenken hinsichtlich der Augensicherheit. Auf der Website von TDK wird der Wellenleiter-Ansatz weiterhin aufgeführt, das Unternehmen verfolgt also offenbar beide Richtungen.Der Spiegel lenkt das Licht vom Scanner mithilfe von Nanostrukturen mit einer Größe zwischen 200 nm und 1 µm zum Auge. Ein gewöhnlicher Spiegel würde das Licht eines Projektors im Brillenbügel in einem Winkel reflektieren, bei dem es das Auge vollständig verfehlt. Die Struktur wird in einem halbleiterähnlichen Verfahren auf einem dünnen Substrat hergestellt. Sie lässt sich in ein gewöhnliches Brillenglas einbetten, vermutlich zwischen zwei Glashälften eingeschlossen, so wie man es heute bei Wellenleitern macht. In der Anordnung von TDK verläuft der Projektorstrahl nahezu parallel zum Rahmen zu einem zweiten Spiegel nahe dem Glas. Von dort trifft er unter einem sehr flachen Winkel auf den Nanoreflektor, wodurch der Weg durch die freie Luft kurz bleibt. Die aktuelle Version arbeitet nur in Grün, und die Strukturgrößen hängen wahrscheinlich von der Wellenlänge ab, wie bei diffraktiven Wellenleitern. TDK gibt an, die Arbeit an einer Vollfarb-Demo zu beschleunigen, und strebt die Massenproduktion „innerhalb der nächsten Jahre" an. „Meta-Optik" bedeutet hier flache Optik mit Subwellenlängenstrukturen und hat nichts mit dem Unternehmen Meta zu tun. Ohnehin verwischen Wellenleitergitter mit komplexen Substrukturen unter 100 nm die Grenze zwischen Gittern und Metaoberflächen.Auf der MicroLED and AR/VR/MR Connect 2026 zeigte TDK eine kurze funktionierende Demonstration dessen, was Oqmented ursprünglich „Progressive Lissajous Scanning" nannte. Auf der Website von TDK heißt es jetzt „kohärentes" Lissajous-Scanning, derselbe Begriff, den Meta auf der SPIE AR/VR/MR 2025 verwendete, wobei TDK angibt, die Idee unabhängig entwickelt zu haben. Beim Lissajous-Scanning wird ein einzelner Spiegel von zwei Sinuswellen angetrieben, und der Strahl beschreibt eine Bahn, die einer Acht ähnelt. Die schnelle Achse von Oqmented arbeitet mit 20-40 kHz. Beim Raster-LBS ist es anders: Dort arbeitet die vertikale Achse mit etwa 60-120 Hz, die horizontale mit 20-60 kHz. Beim Lissajous-Scanning liegt die langsame Achse in ihrer Geschwindigkeit viel näher an der schnellen, daher verläuft der Strahl auf stark gekrümmten, diagonalen Bahnen. Traditionell werden die Pixel pseudozufällig geschrieben, nämlich immer dann, wenn der Strahl sie gerade überquert, wobei der Laser sowohl nach Helligkeit als auch nach Strahlgeschwindigkeit moduliert wird. Bei Sakkaden sieht das Auge dadurch unvollständige Bilder und das Scanmuster selbst.Die kohärente Variante behält dieselbe Spiegelbewegung bei, zeichnet die Pixel jedoch in der Reihenfolge des Strahldurchlaufs und fügt sie zu gekrümmten, rasterähnlichen Segmenten zusammen. Während der Strahl an jedem Rand der Bahn langsam wendet, wird der Laser ausgetastet. Damit verschwindet der Bildzerfall bei Sakkaden, die grundlegenden Grenzen bleiben jedoch bestehen. Ein rechtwinkliges Pixelraster muss auf gekrümmte Scanlinien umgerechnet werden, die nie genau auf einem Pixel landen, und nach der grundlegenden Nyquist-Theorie kostet das etwa den Faktor zwei an effektiver Auflösung pro Achse. Damit die meisten Menschen kein Flimmern wahrnehmen, muss jeder Punkt selbst im ungünstigsten Fall häufiger als etwa 90-mal pro Sekunde aufgefrischt werden. Bei einer schnellen Achse mit 40 kHz ergeben sich nach der Umrechnung etwa 300 effektive Zeilen. Zum Vergleich: NTSC lieferte bei einer Zeilenfrequenz von rund 15 kHz 720×480 im Zeilensprungverfahren mit 60 Hz, und das ganz ohne Umrechnung auf ein gekrümmtes Raster. In der Vergangenheit mussten LBS-Systeme zwischen Flimmern und Auflösung abwägen.Der gezeigte Prototyp von Oqmented/TDK mit niedriger Auflösung beseitigte den Bildzerfall tatsächlich, doch ein gewisses Flimmern war noch sichtbar. Unter den weiteren Entwicklungen im Bereich der Combiner arbeitet CREAL an einem HOE-Combiner. Es entstehen auch radikalere Ansätze, etwa die aktiven Mini-Spiegel von Gixel und der Combiner auf Basis eines nichtlinearen Kristalls von Smith Display.
- Public
- 13 Nov, 2026
Apple bestätigt auf einer Entwicklersession zu Spatial Computing, dass das Unternehmen an visionOS festhält
Apple hat eine eintägige Entwicklersession „Meet with Apple“ abgehalten, die ganz visionOS, der Plattform des Unternehmens für Spatial Computing, gewidmet war, und nutzte sie, um auf die seit Monaten wachsenden Zweifel an seinen XR-Plänen zu reagieren. Yuri Imoto, Produktmanager im Bereich Spatial Computing bei Apple, erklärte, das Unternehmen sei „der Plattform sehr verpflichtet“, und betonte, dass sich Spatial Computing in kurzer Zeit rasant weiterentwickelt habe. Als zentrale Einsatzfelder der Plattform wurden auf der Veranstaltung Chirurgie, Gesundheitswesen, Bildung, Mitarbeiterschulung und immersiver Film genannt.Zu den auffälligsten Neuheiten gehörte ein professionelles Ambisonic-Mikrofon von Blackmagic. Es verfügt über 108 Mikrofone und einen integrierten Prozessor, der das Signal selbst in ein Format umwandelt, das sich direkt für räumliche Inhalte von Apple eignet. Produzenten von immersivem Audio müssen damit keine separate Konvertierung mehr vornehmen.Bereitgestellt von BlackmagicAuf der Hardwareseite war die jüngste Headset-Veröffentlichung das Update der Vision Pro mit M5-Chip im Oktober 2025. Das Headset wurde schneller, das Bild schärfer, die Bildwiederholrate höher und der Tragekomfort besser, dennoch handelte es sich um eine schrittweise Verbesserung und nicht um eine neue Generation. Stattdessen hat sich Apple im vergangenen Jahr darauf konzentriert, wie sich visionOS im Alltag anfühlt, sowohl für private als auch für Unternehmensnutzer, hat immersive Dokumentarfilme und Übertragungen von MLB-Spielen veröffentlicht und Unterstützung für getrackte Controller und Zubehör von Drittanbietern hinzugefügt.Dabei bedeutet ein Bekenntnis zu visionOS nicht zwangsläufig ein Bekenntnis speziell zur Vision Pro. Apple entwickelt neben Mixed-Reality-Headsets auch smarte Brillen und AR-Geräte, und visionOS könnte in der einen oder anderen Form auf all diesen Geräten laufen, ähnlich wie AndroidXR heute auf verschiedenen Geräten läuft. Der Analyst Ming-Chi Kuo berichtete diesen Sommer (von Apple nicht bestätigt), dass sich die Vision Pro 2 auf frühestens Ende 2028 oder sogar 2029 verschoben hat, da Apple vorrangig smarte Brillen für Ende 2027 vorbereitet, um mit Meta und Google/Samsung zu konkurrieren.Smarte Brillen mit AndroidXR | Bereitgestellt von Google, Samsung