Die NVIDIA Minerva AIOps-Plattform verknüpft die Telemetrie von KI-Fabriken, um die GPU-Effizienz zu maximieren
 Public
- 26 Oct, 2026
KI-Fabriken gehören zu den komplexesten Betriebsumgebungen, die je gebaut wurden. Hier arbeiten Hunderttausende von GPUs, NVIDIA Spectrum-X Ethernet-Fabrics, NVLink Scale-up-Netzwerke und verteilte Scheduler in kontinuierlicher Synchronisation. Beim synchronen verteilten Training schreitet der gesamte Job mit dem Tempo des langsamsten Ranks voran. Das bedeutet, dass ein einzelner degradierter GPU, ein Interface oder ein Switch-Pfad nützliche Zeit auf vielen gesunden Ressourcen verschwenden kann. Die Ausfälle, die den Ertrag mindern, sind oft subtil, wie eine GPU, die etwas heißer läuft als ihre Peers, ein NVMe-Gerät, das unter Dauerlast an Leistung verliert, oder ein Switch, der Pause-Frame-Stürme erzeugt. Diese Signale überschreiten einzeln selten statische Schwellenwerte, erzeugen aber gemeinsam Verzögerungen, verlängerte Schrittzeiten und verspätete Checkpoints, was zu erheblichen Produktionsverlusten führt.
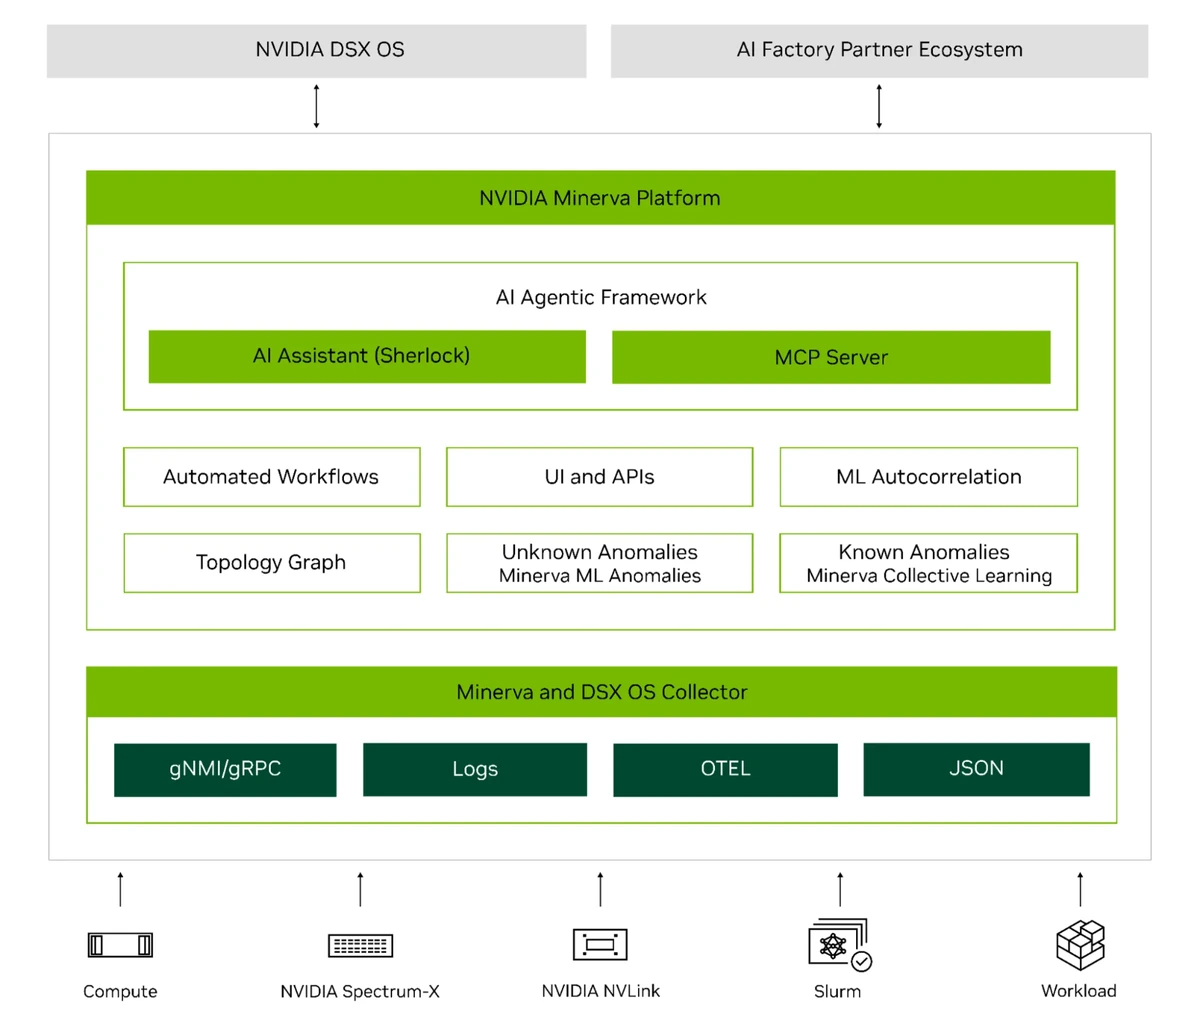
Die Diagnose wird dadurch weiter erschwert, dass die Beweise auf verschiedene Teams verteilt sind: Netzwerkoperatoren sehen Interface-Zähler, Compute-Operatoren sehen den Zustand der Knoten und ML-Teams sehen sich ändernde Step-Zeiten. Diese Fragmentierung verwandelt die Triage in eine Kette von Dashboard-Suchen und Übergaben zwischen Teams, wodurch ein eingedämter Fehler potenziell zu Tagen verlorenen Produktionszeit werden kann. NVIDIA Minerva schließt diese Lücken, indem es Telemetrie über den gesamten Stack sammelt und die Infrastruktur in einem dynamischen Wissensgraphen den aktiven Jobs zuordnet. Es wendet speziell entwickeltes Machine Learning an, um abhängige Symptome in hochpräzise Incidents zu korrelieren. Ein KI-Agent-gestützter Assistent und ein MCP-Server, der mit externen agentischen Tools verbunden ist, bieten einen konversationellen Weg durch diese Live-Daten, mit dem Hauptziel, effektive GPU-Stunden zu erhalten und das Modelltraining reibungslos laufen zu lassen.
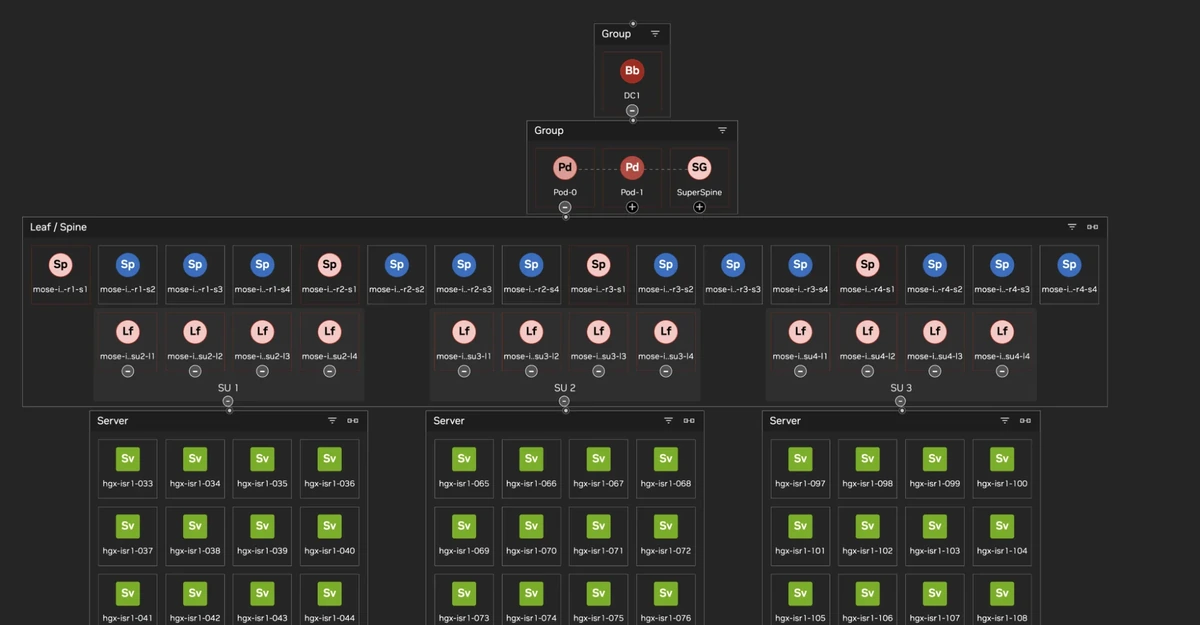
Regelbasiertes Monitoring hat Schwierigkeiten mit „Gray Failures“, bei denen Komponenten verfügbar bleiben, aber Probleme nur unter Last oder im Vergleich zu Peers zeigen. Absolute Schwellenwerte übersehen diese Verschiebungen oft, während aggressive Schwellenwerte bei normalen Laständerungen Rauschen erzeugen. Der Maßstab verstärkt dieses Problem, da ein einzelner physischer Fehler Interface-Fehler, Stauungsindikatoren und Änderungen der GPU-Auslastung erzeugen kann, die auf separaten Dashboards als unzusammenhängende Ereignisse erscheinen. Minerva nimmt Metriken, Logs und Topologie von GPUs, Spectrum-X- und NVLink-Switches, SuperNICs, DPUs, Storage, NCCL und Scheduling-Systemen auf. Die Auto-Discovery liefert Beziehungen, die der rohen Telemetrie fehlen, und erstellt einen Wissensgraphen, der Infrastruktur-, Scheduler- und Workload-Elemente abbildet. Dieser Graph wird dynamisch aktualisiert, während Jobs starten, stoppen oder Knoten ersetzt werden, und unterstützt die Navigation von einer fabrikweiten Ansicht bis hin zu einem einzelnen Interface.
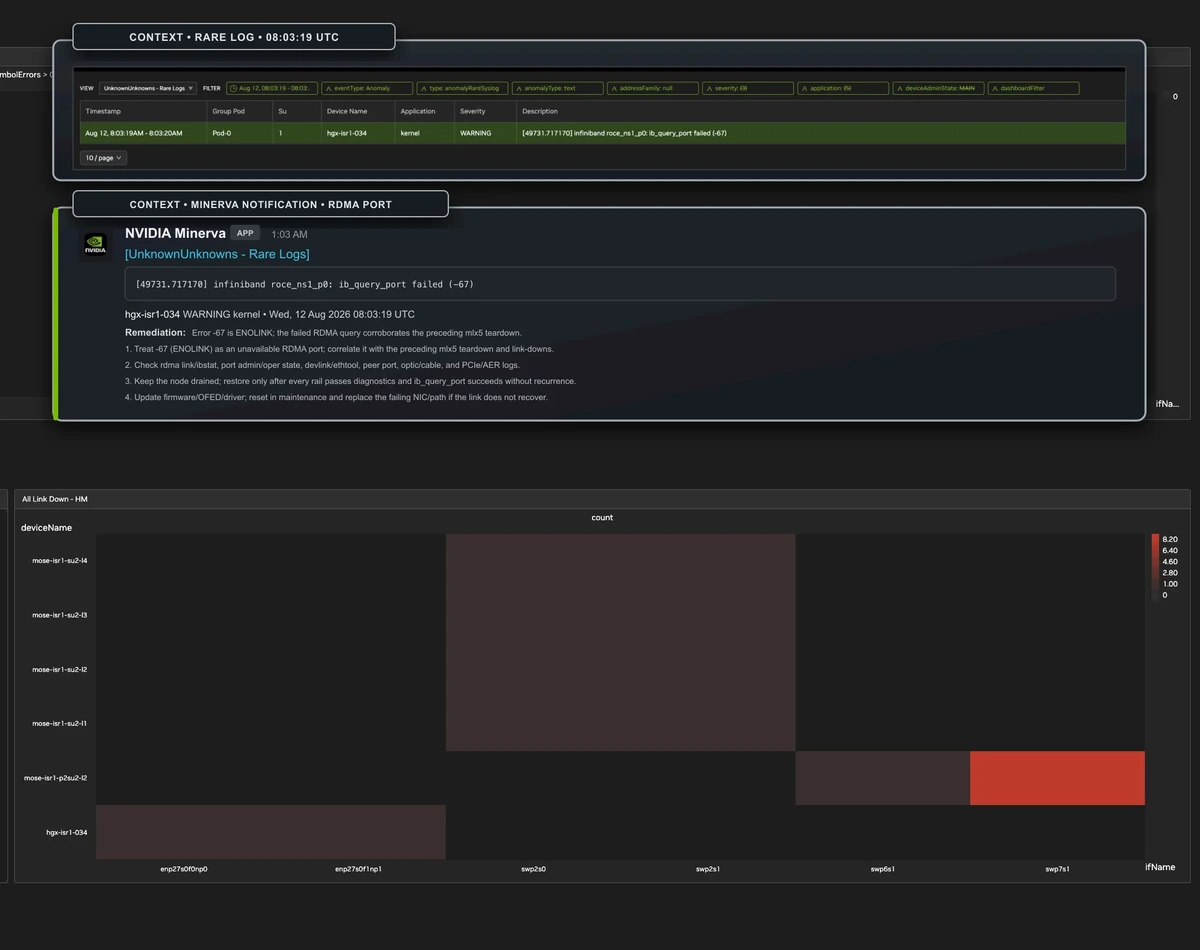
Der Topologiegraph transformiert den Untersuchungspfad, indem er es den Betreibern ermöglicht, Anomalien von einem Interface über dessen Knoten und den Fabric-Pfad bis zur aktuellen Job-Platzierung zu verfolgen. Umgekehrt können ML-Ingenieure eine Job-ID anhand von Beweisen auf GPU-, Host-, NIC- und Switch-Ebene nachverfolgen. Minerva verarbeitet Milliarden von Metrik- und Log-Datenpunkten pro Stunde unter Verwendung von überwachten und unüberwachten Modellen. Die überwachte Erkennung identifiziert bekannte kritische Fehlermuster und verknüpft sie mit Empfehlungen zur Behebung, während unüberwachte Modelle normale Muster für Hardware- oder logische Komponenten erlernen und diese mit relevanten Peers vergleichen. Der Peer-Vergleich ist entscheidend, da eine Messung isoliert betrachtet akzeptabel erscheinen kann, im Kontext jedoch anomalous ist, beispielsweise eine GPU-Temperatur innerhalb der Spezifikation, die jedoch unter gleicher Last deutlich höher ist als die der benachbarten GPUs. Multivariate Modelle kombinieren Temperatur, Leistung, Taktraten und Auslastung, um Degradation vor einem vollständigen Ausfall zu erkennen.
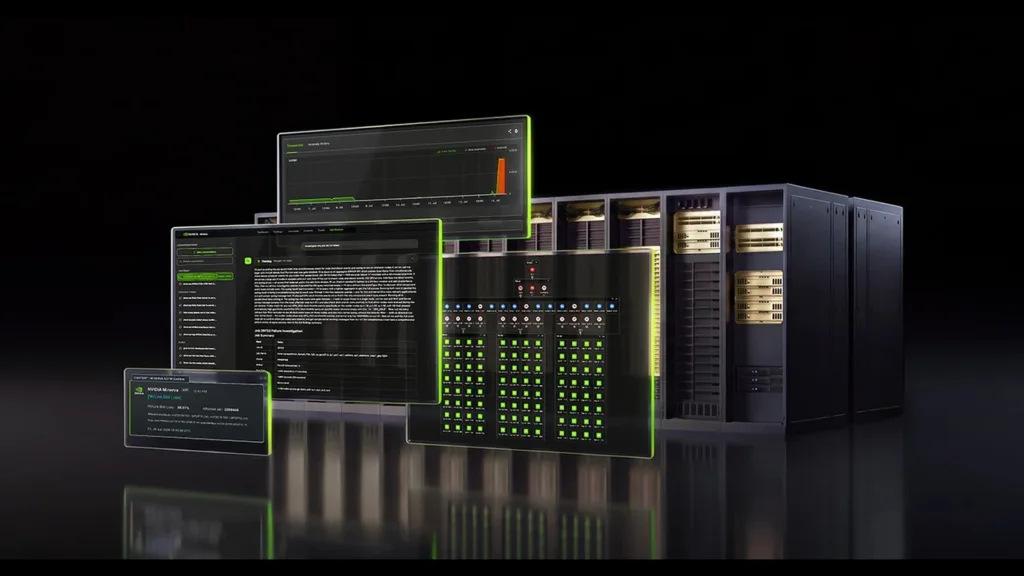
Logs erhalten eine ähnliche Behandlung: Die NLP-basierte Anomalieerkennung bringt zuvor unbekannte Muster ans Licht, während das überwachte Matching bekannte kritische Fehler identifiziert. Erkennungen können in Scheduler-Workflows eingespeist werden, um betroffene Knoten vor dem Einplanen neuer Jobs oder in sicheren Checkpoint-Intervallen aus dem Verkehr zu ziehen. Die topologiebasierte Korrelation verknüpft Erkennungen mit Betreiberaktionen, indem sie den Wissensgraphen nutzt, um zu bestimmen, welche Ereignisse einen gemeinsamen Abhängigkeitspfad teilen. Abhängige Symptome werden zu einem einzigen Vorfall zusammengefasst, anstatt um Aufmerksamkeit zu konkurrieren, wobei redundante Ereignisse und zugehörige Metrikserien zu einem einzigen Signal zusammengefasst werden, an das die betroffene Topologie und Workloads angehängt sind. NVIDIA-Tests zeigen eine deutliche Reduzierung der gemeldeten Ereignisse und Tickets für unterstützte Szenarien, was es den Betreibern ermöglicht, mit einem viel kleineren Suchraum für die Ursachenanalyse zu beginnen.
NVIDIA Minerva enthält einen nativen KI-Agenten namens Sherlock, der auf Live-Telemetrie und dem Wissensgraphen basiert und es Betreibern ermöglicht, das System in natürlicher Sprache nach der Ursachenanalyse zu befragen. Sherlock kann unterstützende Beweise präsentieren und Behebungsmaßnahmen empfehlen, ohne dass die Betreiber spezifische Metriken oder Abfragesprachen kennen müssen, und bietet einen Zugang zu Fachwissen, der traditionell eine Eskalation an Spezialisten erforderte. Darüber hinaus ermöglicht der MCP-Server von Minerva externen agentischen Tools, denselben operativen Kontext abzufragen, sodass Teams Live-Daten der KI-Fabrik in ihre eigenen Workflows integrieren können. Abhilfemaßnahmen können menschlich genehmigt bleiben oder gemäß lokaler Politik und Risikobewertung automatisiert werden. In einem großen KI-Rechenzentrum identifizierte Minerva eine einzelne NVLink-Verbindung unter 400.000 Interfaces, die Bandbreite verlor, was es einem SRE ermöglichte, die betroffenen Knoten aus dem Verkehr zu ziehen und die volle Geschwindigkeit in Minuten statt Stunden wiederherzustellen.