Speicherbegrenzung von GPU-Workloads in Kubernetes mit CUDA 13.4 und dem KAI-Scheduler
 Public
- 28 Oct, 2026
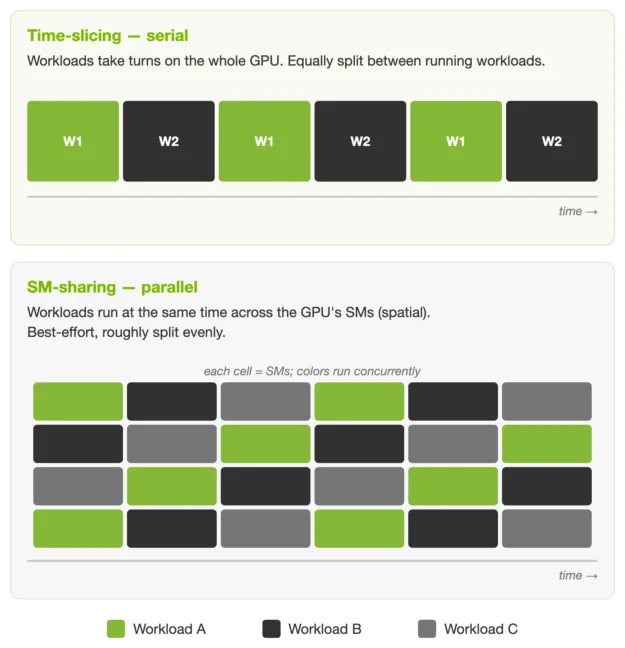
KI-Workloads erfordern oft nur einen Bruchteil einer GPU, doch die Zuweisung ganzer Geräte führt zu ungenutzter Kapazität und ineffizienter Infrastrukturnutzung. NVIDIA-GPUs unterstützen verschiedene Mechanismen zum Teilen, darunter Multi-instance GPU (MIG) für die Hardware-Isolierung, Time-Slicing für die sequenzielle Prozessausführung und Multi-Process Service (MPS) für die parallele Ausführung in separaten Adressräumen. Während MPS das Teilen von Rechenressourcen ermöglicht, fehlten ihm zuvor strenge Speichergrenzen. CUDA 13.4 schließt diese Lücke, indem es einen neuen Time-Sharing-Modus einführt, der Speicherlimits transparent für die Anwendung durchsetzt und sicherstellt, dass jede Workload innerhalb definierter Speicherbeschränkungen arbeitet, ohne dass Codeänderungen erforderlich sind.
Die Implementierung dieser Funktionen in einem Kubernetes-Cluster erfordert eine Knoten-Koordination, die unabhängig vom Scheduler ist. Der Open-Source-Operator gpu-fractioning, der unter der KAI Scheduler-Organisation auf GitHub gehostet wird, läuft neben dem NVIDIA GPU Operator, um diese Konfiguration zu handhaben. Er erfüllt drei wesentliche Funktionen: das Lesen von Pod-Annotationen zur Bestimmung der Speicher- und Berechnungsanforderungen, die Konfiguration der zugewiesenen GPUs zur Durchsetzung dieser Grenzen und das Management des Übergangs zwischen verschiedenen Sharing-Modi. Dieser Operator stellt sicher, dass die Hardware die vom Cluster-Scheduler definierten logischen Grenzen respektiert und die Lücke zwischen hochrangigen Scheduling-Entscheidungen und der niedrigen GPU-Ausführung überbrückt.
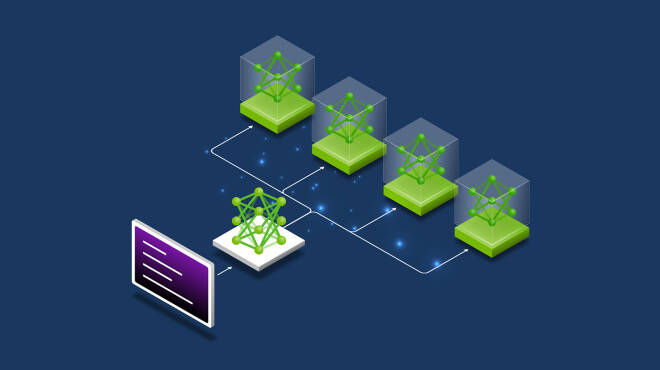
Der Workflow beginnt damit, dass Entwickler Ressourcenanforderungen und Modi über Pod-YAML-Annotationen festlegen. Der Scheduler wählt dann geeignete GPUs aus, protokolliert die Speicherallokation und den Berechnungs-Sharing-Modus in den Pod-Annotationen pro Container und weist die Workload zu. Der gpu-fractioning-Operator liest diese Annotationen und konfiguriert die GPUs entsprechend. Jeder Kubernetes-Scheduler, der in der Lage ist, diese Annotationen zu schreiben, kann GPU-Anteile durchsetzen, vorausgesetzt, er hält sich an zwei Regeln: die Auswahl von GPUs mit ausreichend freiem Speicher und das Vermeiden des Mischens von Berechnungsmodi auf einem einzelnen Gerät. KAI Scheduler ist der erste, der diese Funktion integriert, und führt ab Version v0.18.0 einen GPU-Sharing-Modus namens NvFractions ein.
Der NvFractions-Modus von KAI Scheduler ermöglicht es Administratoren, Bruchteil-Workloads mit vier Schlüssel-Annotationen zu definieren, die Speicheranfragen, Wachstumsgrenzen, Berechnungs-Sharing-Modi und Geräteanzahl adressieren. Speicheranfragen können als absolute Größen mit Standard-Kubernetes-Einheiten oder als Anteile einer GPU mit der gpu-fraction-Annotation angegeben werden. Eine neue Funktion ermöglicht es Workloads, eine garantierte Mindestanfrage und eine maximale Burst-Grenze zu deklarieren, die optional ist und standardmäßig dem Anfrage-Wert entspricht, wenn sie weggelassen wird. Anteilsgrenzen müssen die gpu-fraction überschreiten und unter 1 bleiben. Das Berechnungs-Sharing ist jetzt explizit und pro Container festgelegt, was die Wahl zwischen sm-sharing und time-slicing ermöglicht.
Eine geteilte GPU arbeitet nur in einem Berechnungsmodus zur Zeit, daher verhindert KAI Scheduler das Platzieren von Workloads mit unterschiedlichen Modi auf derselben GPU, obwohl ein einzelner Knoten beide Modi auf verschiedenen Geräten hosten kann. Für Multi-GPU-Setups gibt die gpu-fraction-num-devices-Annotation an, auf wie viele Geräte sich die Workload erstreckt, wobei die Speicheranfrage auf jedes Gerät individuell angewendet wird. Zum Beispiel allokiert eine Anfrage von 40Gi mit vier Geräten 40Gi auf jeder GPU. Dieses Setup ist ideal für Inferenzserver, die garantierten Speicher pro GPU benötigen und bei inaktiven Nachbarn ausbrechen können, indem sie sm-sharing für vertrauenswürdige Workloads nutzen, die parallel in einem einzelnen Fehlerbereich ausgeführt werden.
Im Gegensatz dazu eignet sich Time-Slicing für Entwicklung oder Batch-Jobs wie Notebooks und kleine Fine-Tuning-Läufe, bei denen Isolation bevorzugt wird. In diesem Modus erhält jede Workload ihre eigene Fehlerdomäne, was bedeutet, dass ein Absturz in einem Job die anderen nicht beeinträchtigt. Eine Workload kann die Hälfte von zwei GPUs mit einer Obergrenze für das Wachstum auf 80 % anfordern, wenn Speicher verfügbar ist. Die Ausführung von nvidia-smi innerhalb des Containers zeigt den anteiligen Speicheranteil für jede zugewiesene GPU an. Sowohl KAI Scheduler als auch der gpu-fractioning-Operator sind auf GitHub unter der Organisation KAI Scheduler verfügbar, mit detaillierten Installations- und Konfigurationsanleitungen für alle Sharing-Mechanismen.