Ograničenje memorije GPU po opterećenjima u Kubernetesu s CUDA 13.4 i planerom KAI
 Public
- 28 Oct, 2026
AI opterećenja često zahtijevaju samo dio GPU-a, ali dodjela cijelih uređaja dovodi do neiskorištenih kapaciteta i neučinkovite upotrebe infrastrukture. GPU-jevi NVIDIA podržavaju različite mehanizme dijeljenja, uključujući Multi-instance GPU (MIG) za hardversku izolaciju, time-slicing za sekvencijalno izvršavanje procesa i Multi-Process Service (MPS) za paralelno izvršavanje u odvojenim adresnim prostorima. Iako MPS omogućuje dijeljenje izračunskih resursa, ranije je nedostajala stroga granica memorije. CUDA 13.4 rješava taj nedostatak uvodeći novi režim time-sharing koji transparentno za aplikaciju nameće ograničenja memorije, čime se osigurava da svako opterećenje radi unutar definiranih ograničenja memorije bez potrebe za izmjenama koda.
Implementacija ovih mogućnosti u Kubernetes klasteru zahtijeva koordinaciju na razini čvorova, nezavisnu od planera. Operator gpu-fractioning s otvorenim izvorom, smješten u organizaciji KAI Scheduler na GitHubu, radi uz NVIDIA GPU Operator kako bi obradio tu konfiguraciju. Obavlja tri ključne funkcije: čitanje anotacija podova radi određivanja zahtjeva za memorijom i izračunima, konfiguriranje dodijeljenih GPU-ova za nametanje tih ograničenja i upravljanje prijelazom između različitih režima dijeljenja. Ovaj operator osigurava da hardver poštuje logičke granice definirane planerom klastera, povezujući visokorazinske odluke o planiranju s niskorazinskim izvršavanjem na GPU-ovima.
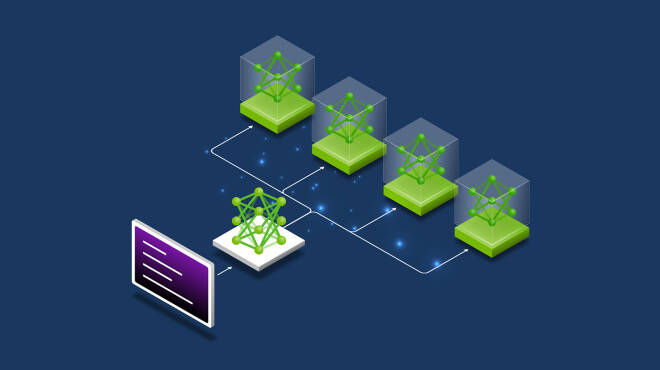
Tijek rada počinje s time što razvijatelji specificiraju zahtjeve za resursima i režime putem anotacija YAML podova. Planer zatim odabire odgovarajuće GPU-ove, bilježi alokaciju memorije i režim dijeljenja izračuna u anotacijama podova po kontejneru i dodjeljuje opterećenje. Operator gpu-fractioning čita te anotacije i konfigurira GPU-ove sukladno tome. Bilo koji planer Kubernetesa sposoban zapisivati te anotacije može nametnute udjele GPU-ova, pod uvjetom da poštuje dva pravila: odabir GPU-ova s dovoljno slobodne memorije i izbjegavanje miješanja režima izračuna na jednom uređaju. KAI Scheduler prvi je integrirao tu značajku, uvodeći režim dijeljenja GPU-a nazvan NvFractions počevši od verzije v0.18.0.
Režim NvFractions u planeru KAI omogućuje administratorima definiranje frakcijskih opterećenja pomoću četiri ključne anotacije koje obrađuju zahtjeve za memorijom, ograničenja rasta, režime dijeljenja izračuna i broj uređaja. Zahtjevi za memorijom mogu se specificirati kao apsolutne veličine koristeći standardne jedinice Kubernetesa ili kao udjeli GPU-a koristeći anotaciju gpu-fraction. Nova mogućnost omogućuje opterećenjima da deklariraju zajamčeni minimalni zahtjev i maksimalno ograničenje za skok, što je opcionalno i zadano je na vrijednost zahtjeva ako se izostavi. Ograničenja udjela moraju biti veća od gpu-fraction i manja od 1. Dijeljenje izračuna sada je eksplicitno i postavlja se po kontejneru, omogućujući izbor između sm-sharinga i time-slicinga.
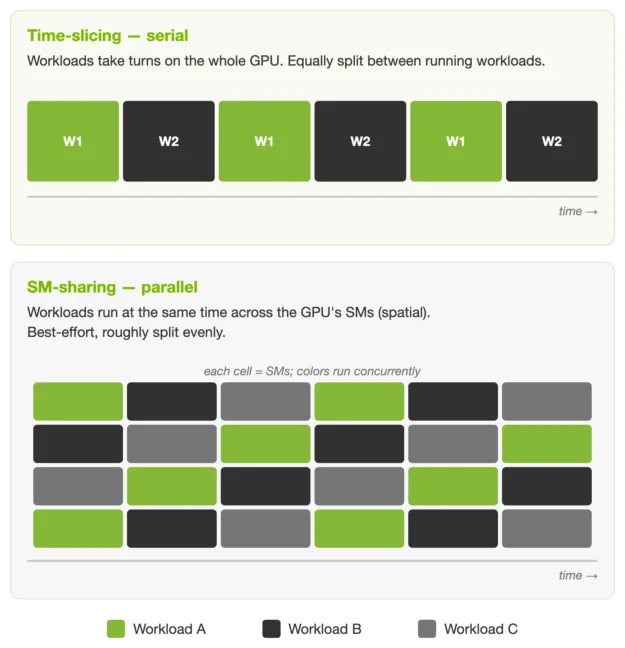
Podijeljeni GPU radi u samo jednom režimu izračuna odjednom, pa planer KAI sprječava smještaj opterećenja s različitim režimima na isti GPU, iako jedan čvor može hostirati oba režima na različitim uređajima. Za postavke s više GPU-ova, anotacija gpu-fraction-num-devices specificira na koliko uređaja se opterećenje proteže, pri čemu se zahtjev za memorijom primjenjuje na svaki uređaj pojedinačno. Na primjer, zahtjev od 40Gi s četiri uređaja alokira 40Gi na svakom GPU-u. Ova postavka idealna je za servere za inferenciju kojima je potrebna zajamčena memorija po GPU-u i mogućnost skoka kada su susjedi neaktivni, koristeći sm-sharing za pouzdana opterećenja koja se paralelno izvršavaju u jednoj domeni grešaka.
S druge strane, time-slicing je prikladan za razvoj ili batch poslove, poput notebookova i malih sesija fine-tuninga, gdje je izolacija poželjna. U ovom režimu, svaki workload dobiva vlastitu error domain, što znači da kvar jednog posla ne utječe na druge. Workload može zatražiti polovicu dva GPU-a s ograničenjem rasta do 80% kada je memorija dostupna. Pokretanje nvidia-smi unutar kontejnera prikazat će frakcijski udio memorije za svaki dodijeljeni GPU. Oba alata, KAI Scheduler i gpu-fractioning operator, dostupna su na GitHubu u organizaciji KAI Scheduler, uz detaljne vodiče za instalaciju i konfiguraciju za sve mehanizme dijeljenja.