Rendu et animation de centaines de milliers de blocs avec RenderMeshPrimitives
 Public
- 24 Sep, 2026
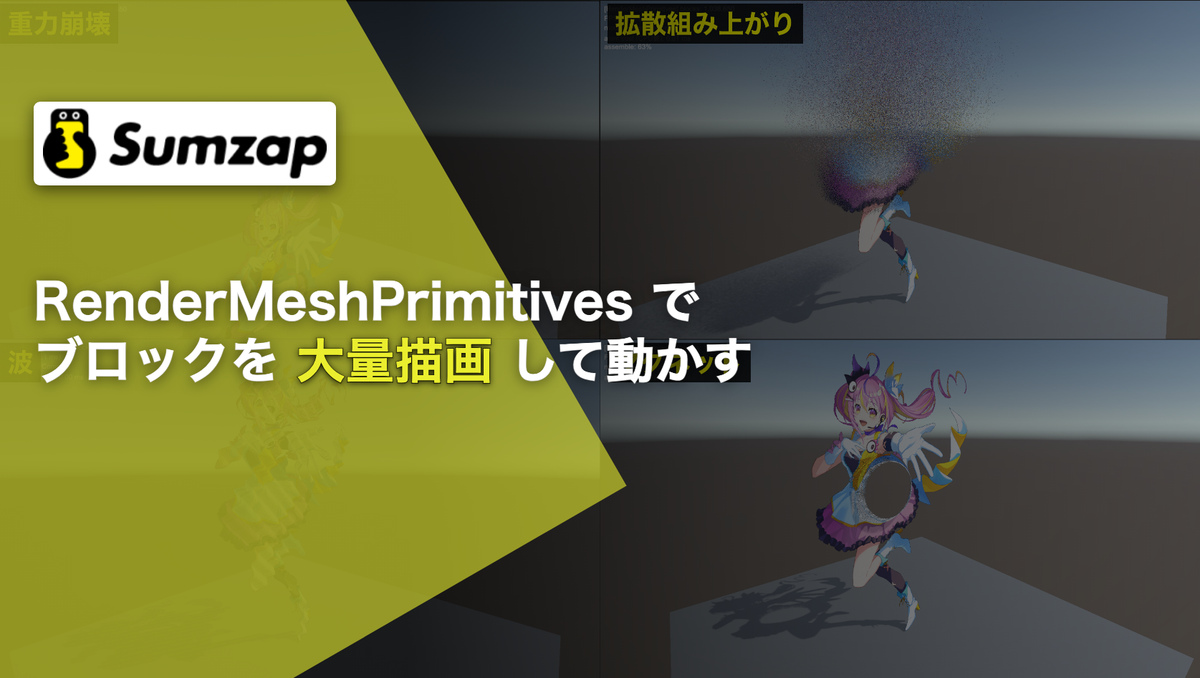
Une image peut être découpée en un immense tableau de blocs colorés via Graphics.RenderMeshPrimitives, puis animée en vagues, assemblage, répulsion et effondrement à une fréquence d'images jouable. L'approche commence par transformer la texture source en une liste de données de position et de couleur pour chaque bloc. On définit un nombre horizontal de blocs gridWidth, et le nombre vertical se déduit du rapport d'aspect de l'image, si bien que les pixels d'origine sont sous-échantillonnés à intervalles réguliers, tandis que les pixels entièrement transparents et quasi noirs sont ignorés comme arrière-plan.
Chaque bloc est stocké dans une structure PixelBlock avec les champs float3 position et float4 color, qui reproduit exactement la disposition HLSL. Dans Awake méthode texture.GetPixels32 lit l'image source, tandis qu'une boucle for sur les coordonnées de la grille fait correspondre à chaque cellule de la grille un pixel source, en décalant les positions pour que le centre de la grille se retrouve à l'origine. Les octets de couleur sont divisés par 255, devenant des valeurs 0–1. Une première passe naïve crée un GameObject par bloc avec un maillage partagé, un matériau et un MaterialPropertyBlock, mais à environ 100 000 blocs, tout s'effondre à 6 FPS, car chaque objet ajoute des commandes de rendu et des frais généraux de composants.
La solution devient Graphics.RenderMeshPrimitives — une API spécialement conçue pour dessiner plusieurs fois le même maillage. Les données d'instance sont chargées une seule fois dans un GraphicsBuffer (GraphicsBuffer.Target.Structured, sizeof(float) * 7 par élément), puis SetData(blocks) transfère tout le tableau du CPU vers le GPU en un seul appel. L'argument stride doit correspondre à la taille de la structure HLSL, et il doit être mis à jour quand les champs changent. Un seul appel Graphics.RenderMeshPrimitives(renderParams, cubeMesh, 0, blocks.Length) rend tout, tandis que le shader récupère la position et la couleur via SV_InstanceID. worldBounds doit être assez grand pour contenir tous les blocs : trop petit, il masque des blocs, et trop grand, il rend le culling inutile ; le buffer doit être libéré dans OnDisable, pour éviter les fuites.
Sur environ 100 000 blocs, la version avec GameObject est montée à 54 525 appels de rendu et environ 6 FPS, tandis que la version RenderMeshPrimitives restait à 42 appels de rendu pour toute la scène et atteignait 700–865 FPS. En augmentant d'environ dix fois — jusqu'à 1,04 million de blocs — les appels de rendu sont restés à 42, et la fréquence d'images se maintenait autour de 435 FPS ; les chiffres proviennent de la fenêtre Statistics d'Unity. Comme le déplacement est lu depuis le tampon du côté GPU et que le CPU n'émet qu'une seule commande de rendu, le coût reste faible même lorsque le nombre de blocs augmente.
L'animation suit deux chemins selon que l'état du cadre précédent est nécessaire. Le mouvement défini uniquement par le temps s'exécute entièrement dans le vertex shader : une vague ajoute sin le long de Z, en utilisant _WaveAmplitude, _WaveFrequency et _WaveSpeed, tandis qu'un effet d'assemblage interpole la position dispersée vers la position d'origine, pilotée par une valeur _Progress. Les directions de dispersion proviennent de GenerateHashedRandomFloat avec une clé basée sur l'ID d'instance, ils sont donc déterministes et ne nécessitent aucun état sauvegardé, et les seuils de départ décalés selon la hauteur font monter l'image depuis le bas.
Pour les mouvements qui transportent une vitesse ou une position entre les images, un compute shader est utilisé. L'effet d'aimant stocke les positions actuelles dans un buffer en lecture-écriture et repousse les blocs proches du curseur, puis interpole (lerp) les positions vers leurs cibles à chaque image avant de dessiner la mise à jour. L'effondrement gravitationnel intègre la vitesse à chaque image dans un buffer BlockState, en rebondissant à l'atterrissage avec _Restitution et en s'endormant lorsque la vitesse chute sous _SleepThreshold; _DeltaTime tout en étant limité à 1/30 de seconde pour éviter un emballement de l'intégration, tandis que les positions de repos sont précalculées à partir de la densité par colonnes.