NVIDIA Snapshot réduit le démarrage des charges GPU à quelques secondes
 Public
- 11 Nov, 2026
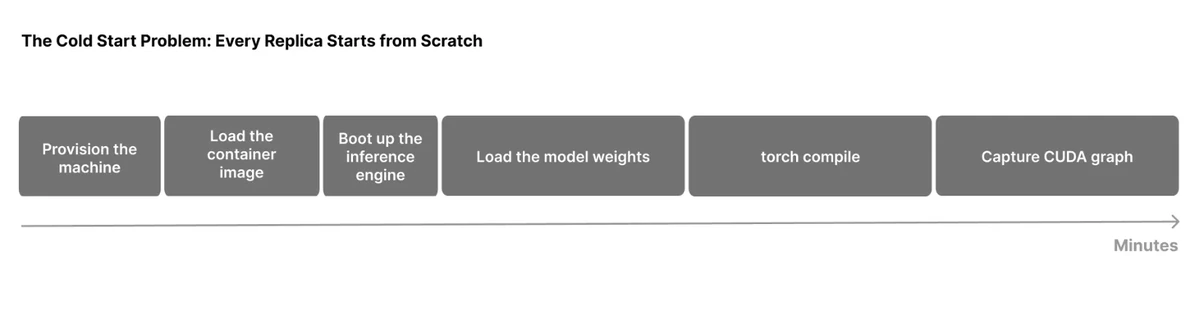
NVIDIA a présenté Snapshot, un composant open source de la plateforme NVIDIA DSX AI Factory Platform qui permet de réutiliser des charges GPU initialisées entre différentes répliques d'inférence. Le problème est familier à tous ceux qui exploitent des LLM : lorsque la demande explose ou qu'une réplique tombe en panne, les GPU disponibles ne deviennent pas immédiatement de la capacité de service, car l'initialisation d'une charge LLM, le démarrage à froid, peut prendre plusieurs minutes. Snapshot est un système de points de contrôle et de restauration pour les charges GPU sur Kubernetes. Il capture une charge entièrement initialisée, y compris la mémoire CPU et GPU, et restaure cet état sur une infrastructure compatible, en mettant la capacité d'inférence en ligne en quelques secondes plutôt qu'en plusieurs minutes. Le provisionnement de l'infrastructure et le chargement de l'image de conteneur ne font pas partie du chemin de restauration mesuré.
L'outil expose deux opérations pour les Pods GPU, toutes deux pilotées par des ressources personnalisées Kubernetes. Pour sauvegarder le point de contrôle d'un Pod en cours d'exécution, vous créez un PodSnapshot qui le nomme ; pour démarrer un Pod à partir d'un modèle et en sauvegarder le point de contrôle dès qu'il est prêt, vous créez plutôt un SnapshotJob. Restaurer signifie ajouter l'annotation nvidia.com/restore-from à un nouveau Pod et indiquer le PodSnapshot à partir duquel restaurer. La charge elle-même n'a besoin que d'une petite poignée de main pour se mettre en pause avant la création du point de contrôle et reprendre après la restauration, et le dépôt fournit des exemples prêts à l'emploi pour vLLM, SGLang et NVIDIA TensorRT LLM. Snapshot peut sauvegarder et restaurer des charges compatibles réparties sur plusieurs GPU d'un même nœud sous forme d'un artefact unique pour tous les rangs, ce qui permet un démarrage rapide des grands modèles mixture-of-experts utilisant le parallélisme tensoriel, le parallélisme de données et d'experts, ainsi que le parallélisme de contexte de décodage, à condition que la charge respecte les exigences de compatibilité des points de contrôle, de la restauration et de l'environnement d'exécution.
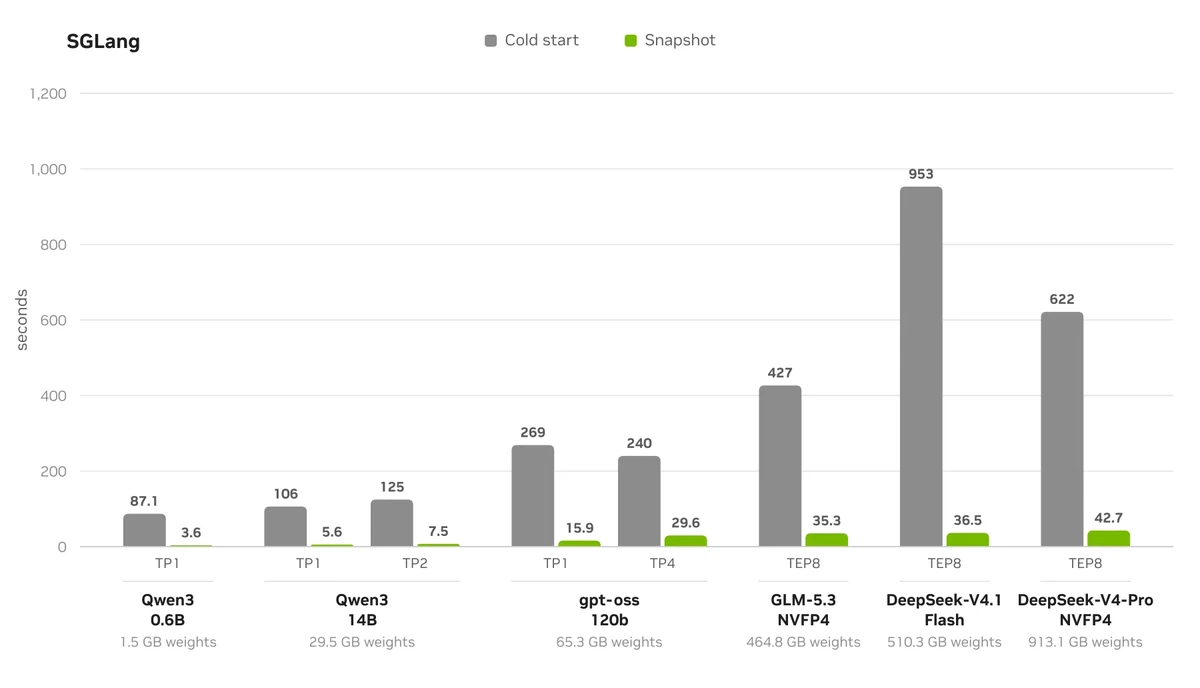
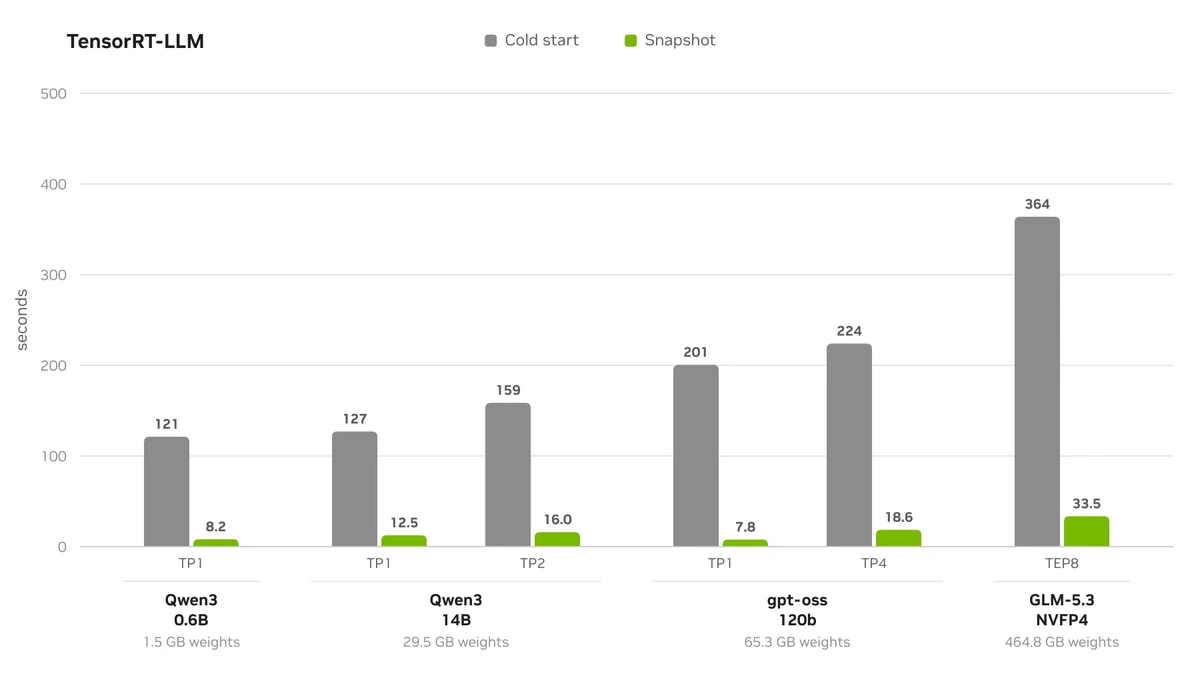
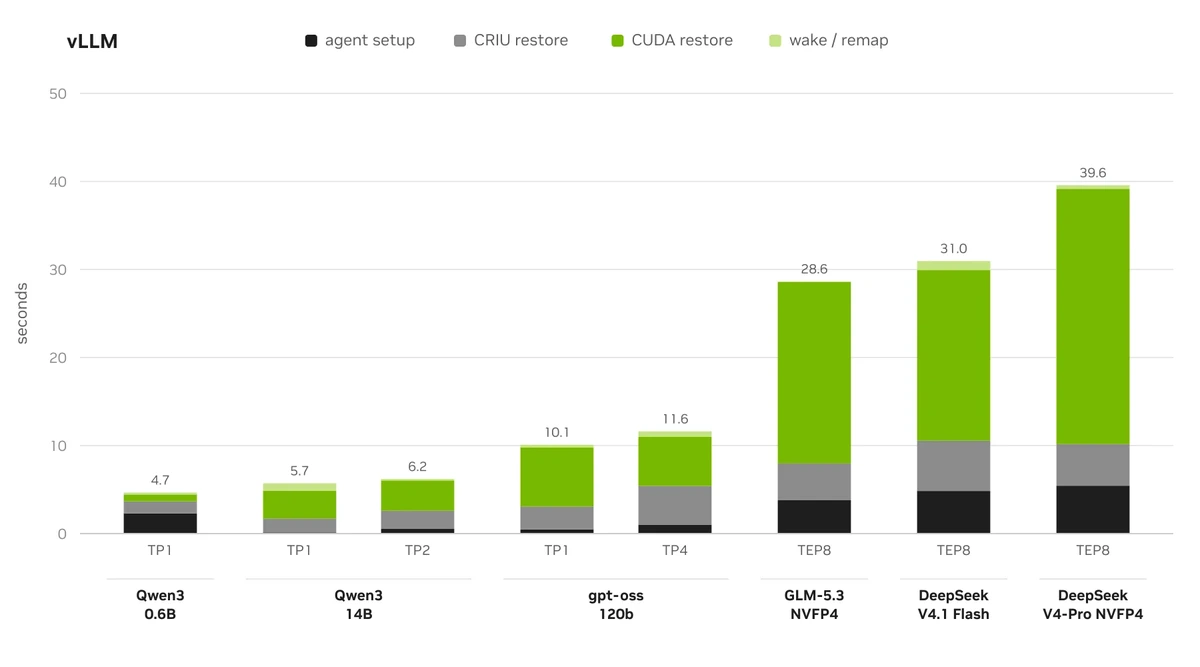
Les benchmarks couvrent des modèles de 600 millions de paramètres jusqu'à des modèles MoE avec des points de contrôle de 1 To sur 8 GPU ; les tests ont été menés sur le même matériel et la même pile logicielle selon deux stratégies : démarrage à froid contre restauration depuis Snapshot. Dans toutes les configurations testées, Snapshot remet une réplique en service en moins de 45 secondes, soit 8 à 36 fois plus vite qu'un démarrage à froid. Par moteur, les plages de restauration sont les suivantes : vLLM - de 4,7 à 39,6 secondes, SGLang - de 3,6 à 42,7 secondes, TensorRT LLM - de 7,79 à 33,55 secondes. Les deux mesures n'incluent pas le téléchargement de l'image du conteneur ni la configuration de l'environnement d'exécution du conteneur, et la libération du cache KV est déclenchée avant chaque point de contrôle, donc elle ne fait pas partie de l'artefact. Le temps de création du point de contrôle et la taille de l'artefact sont indiqués comme un coût unique par modèle et par configuration.
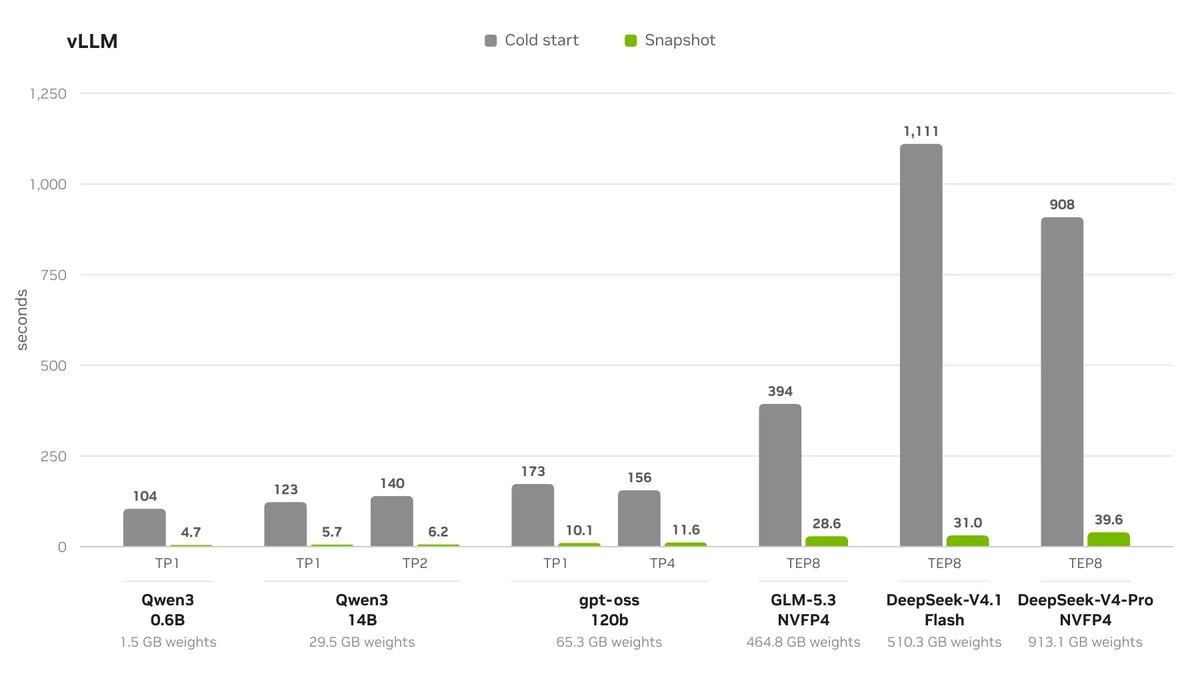
Le chemin de restauration lui-même se décompose en configuration de l'agent, restauration CRIU, restauration CUDA et réveil avec remappage, et la décomposition du démarrage à froid montre quelles phases d'initialisation la restauration évite. Snapshot a été initialement développé pour les workers d'inférence NVIDIA Dynamo, mais il est conçu pour être intégré par d'autres moteurs d'inférence, planificateurs, contrôleurs et plateformes. Les outils de benchmarking et les instructions de reproduction se trouvent dans le dépôt, aux côtés du guide d'installation et d'utilisation, et un guide utilisateur Dynamo décrit la restauration des workers. Des partenaires de conception ont également évalué Snapshot sur leurs propres charges de travail.