NVIDIA Green Contexts : partitionnement explicite des ressources GPU pour les tâches simultanées
 Public
- 07 Oct, 2026
Les applications GPU modernes exécutent souvent plusieurs composants indépendants au sein d'un même processus. Par exemple, des opérateurs sensibles à la latence fonctionnent aux côtés de noyaux d'arrière-plan orientés vers le débit. Ces composants partagent généralement un GPU unique, ce qui entraîne une interférence imprévisible et une concurrence pour les ressources. Les contextes CUDA traditionnels ont été conçus pour une époque où les GPU traitaient une seule charge de travail dominante. Ils sont donc devenus lourds et mal adaptés au partitionnement fin des ressources. Ils engendrent un coût matériel important lors du changement de contexte et manquent de mécanismes pour définir explicitement la répartition des ressources d'exécution entre les tâches simultanées.
Les Green Contexts résolvent ce problème en permettant aux applications de sélectionner explicitement un sous-ensemble des ressources d'exécution du GPU et de cibler directement le travail sur ces ressources. Disponibles dans l'API Driver depuis CUDA 12.4, ils sont désormais accessibles via l'API Runtime à partir de CUDA 13.1. Cette fonctionnalité permet aux développeurs de définir où le travail s'exécute et comment les ressources sont réparties au sein d'un processus. Le cas d'usage principal est le partitionnement des SM, où des Streaming Multiprocessors spécifiques sont attribués à un Green Context. Cela permet à plusieurs charges de travail de s'exécuter simultanément sans se disputer les mêmes unités de calcul.
En plus de l'allocation des SM, les green contexts peuvent provisionner des ressources de workqueue. Dans le modèle traditionnel, des charges de travail indépendantes ordonnées par flux pouvaient être mappées sur les mêmes workqueues sous-jacentes, provoquant une sérialisation non intentionnelle, même lorsque des ressources d'exécution suffisantes étaient disponibles. En provisionnant explicitement les workqueues, les green contexts permettent aux applications d'exprimer la concurrence attendue et d'éliminer les dépendances fausses. Ces contextes sont légers à créer et à détruire, et leur cycle de vie ne synchronise pas implicitement les travaux GPU non liés, offrant un modèle de programmation plus explicite que de s'appuyer sur l'état implicite de l'appareil.
Le modèle de programmation passe d'un ciblage implicite à un ciblage explicite. Historiquement, les applications utilisaient cudaSetDevice() et créaient des flux dont la cible d'exécution était déduite de l'état d'appareil local au thread courant. Avec les green contexts, représentés par le type cudaExecutionContext_t, les développeurs créent un contexte pour un ensemble de ressources choisi, puis créent des flux à partir de celui-ci à l'aide de cudaExecutionCtxStreamCreate(). Cela garantit que le travail soumis à ces flux est strictement associé aux ressources du green context. Pour les applications ciblant l'appareil complet, le modèle traditionnel reste disponible via cudaDeviceGetExecutionCtx(), assurant la rétrocompatibilité et une adoption progressive.
Un cas d'utilisation canonique est le chevauchement de la communication avec les noyaux GEMM dans l'entraînement distribué ou le traitement d'opérateurs sensibles à la latence sur les plateformes de capteurs IA. La priorité des flux seule est insuffisante lorsque les noyaux volumineux occupent tous les SM, car le planificateur ne peut pas préempter les blocs en cours d'exécution. Les green contexts consacrent des SM spécifiques aux travaux critiques, contournant l'attente du vidage des blocs volumineux. Sur un GPU NVIDIA Blackwell doté de 148 SM, les tests ont montré que, si la priorité des flux offre une amélioration de 27 fois par rapport aux flux de priorité égale, les green contexts assurent une réduction supplémentaire de la latence de 20 fois en garantissant des ressources dédiées au noyau critique.
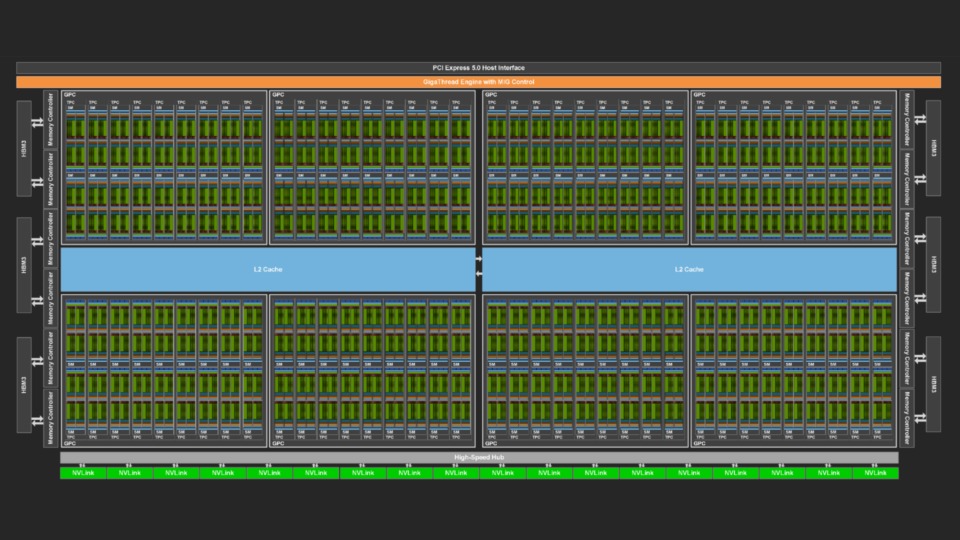
L'implémentation implique de requêter les ressources de l'appareil, de diviser les SM en groupes critiques et restants, et d'empaqueter chacun avec des configurations de workqueue spécifiques. Les développeurs utilisent cudaDevSmResourceSplit pour découper les ressources et cudaDevResourceGenerateDesc pour créer des descripteurs. Les green contexts sont opt-in et additifs, permettant aux applications existantes de continuer à utiliser l'appareil complet tout en adoptant un contrôle plus fin là où c'est nécessaire. Cette approche est particulièrement utile pour atteindre les objectifs de concurrence ou de latence souhaités dans des flux de travail complexes, offrant un mécanisme robuste pour gérer le partage des ressources GPU dans les applications modernes à plusieurs composants.