NVIDIA cuPhoton accélère l'analyse d'images astronomiques grâce à un pipeline natif GPU
 Public
- 07 Oct, 2026
Les instruments scientifiques à haut débit, tels que les observatoires, les télescopes et les sources de rayons X, génèrent des données d'images à des débits dépassant les capacités des pipelines dépendant du CPU. Le goulot d'étranglement de calcul est rarement un seul noyau lent, mais plutôt l'ensemble du chemin allant des données brutes du capteur à la décision scientifique, ce qui inclut la lecture des données, l'ajustement des fonctions de diffusion ponctuelle, la soustraction du fond, l'ajustement des modèles et la classification des objets. Les installations modernes accumulent des pétaoctets de données multidimensionnelles par campagne, et les implémentations privilégiant le CPU peuvent prendre des heures à des mois pour produire des résultats utiles à partir de données générées en quelques secondes. Ce délai entrave l'obtention d'insights scientifiques opportuns. NVIDIA cuPhoton résout ce problème en offrant un chemin natif GPU couvrant chaque étape, de la lecture du capteur à la classification, réduisant le temps d'attente à quelques secondes et permettant aux chercheurs de fonctionner dans des boucles interactives serrées.
NVIDIA cuPhoton est un kit open source NVIDIA CUDA-X composé de blocs de construction accélérés par GPU pour l'astronomie spectrale et optique, ainsi que pour l'analyse des lasers et des rayons X dans le domaine temporel. En maintenant les données d'image sur le GPU, de la lecture initiale du capteur jusqu'à la classification finale, le kit réduit considérablement la latence. Par exemple, l'observatoire Vera C. Rubin (NSF-DOE) enregistre une nouvelle exposition de 3,2 gigapixels toutes les 39 secondes après le coucher du soleil. Son pipeline de traitement rapide doit classifier environ 10 000 détections comme des transitoires astrophysiques ou des artefacts en 60 à 120 secondes. Sur une seule nuit, cela représente jusqu'à 20 téraoctets d'images et 10 millions d'objets candidats. cuPhoton s'étend aux systèmes multi-GPU et multi-nœuds NVIDIA Grace Blackwell et Vera Rubin, accélérant le chargement des images jusqu'à 14 900 fois et le traitement du signal jusqu'à 14 550 fois sur des charges de travail représentatives impliquant des centaines de téraoctets.
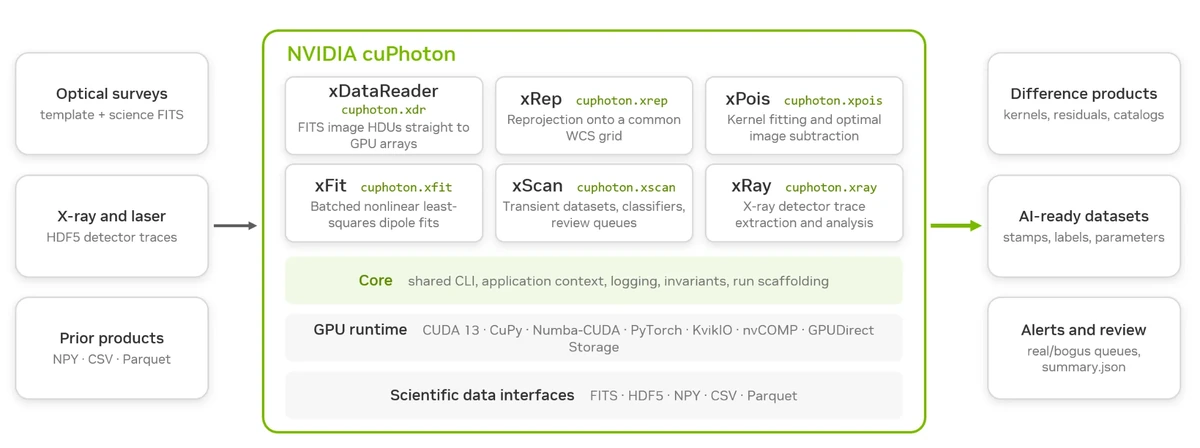
Le kit comprend cinq composants principaux pour le flux de travail d'imagerie : xDataReader, xRep, xPois, xFit et xScan, ainsi que xRay pour l'analyse des détecteurs de rayons X dans le domaine temporel. La configuration nécessite de cloner le dépôt et de provisionner un environnement Linux verrouillé à l'aide de la commande uv sync --locked --extra dev --extra gpu --extra viz. Cet environnement prend en charge l'écosystème NVIDIA CUDA 13, y compris CuPy, PyTorch, Numba-CUDA, KvikIO et NVIDIA nvCOMP, ainsi que des bibliothèques de visualisation comme Bokeh et Pillow. La version 0.1.3 de cuPhoton prend en charge Python 3.12 à 3.14 sur Linux. La compilation du composant xDataReader à partir du code source nécessite un compilateur C++17, les en-têtes de développement CUDA et cuFile, ainsi qu'une installation réentrante de CFITSIO. Le script de flux de travail complet est disponible dans le dépôt pour des exécutions automatisées ou une utilisation interactive dans des notebooks Jupyter.
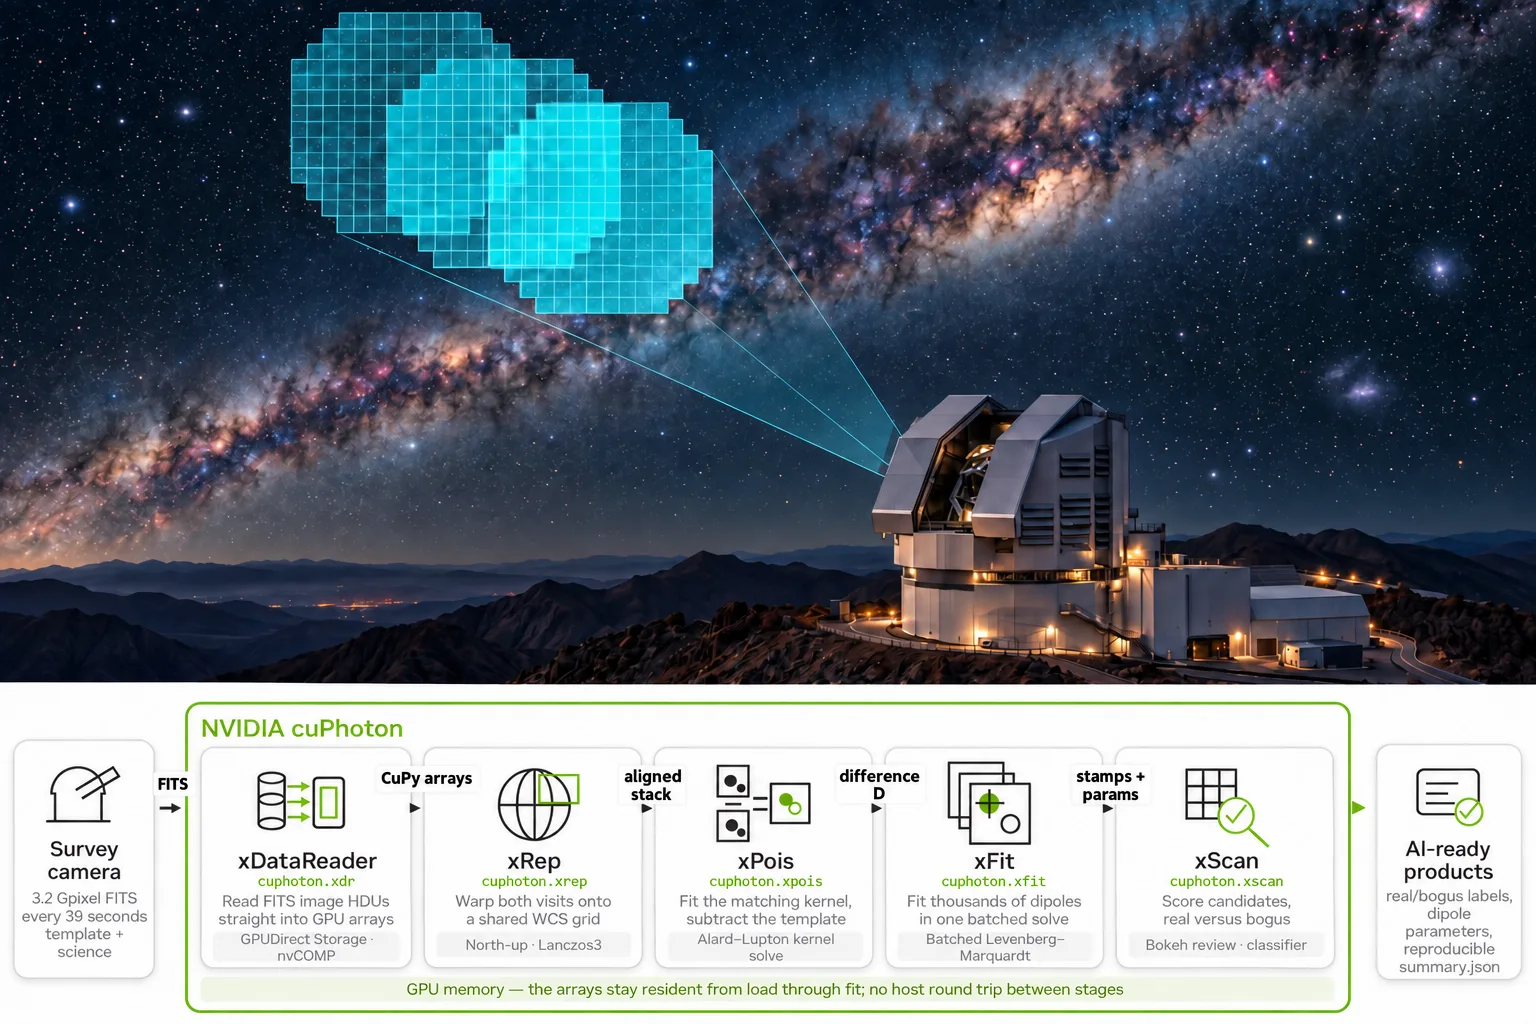
Le module xDataReader accélère le chargement des fichiers au format Flexible Image Transport System (FITS) directement sur la GPU, en évitant les surcoûts traditionnels liés à l'analyse par le CPU et au transfert via PCIe. Il répartit la charge de travail : CFITSIO planifie les plages d'octets sur le CPU, KvikIO les lit via GPUDirect Storage (lorsqu'il est disponible) et nvCOMP décompresse les tuiles GZIP sur la GPU. La fonction publique de l'API batch_to_device renvoie des piles de tableaux CuPy, prenant en charge les HDU d'images non compressés à 2-16 axes et les images bidimensionnelles avec une compression par tuiles GZIP_1 ou GZIP_2. La compression Rice et la quantification flottante avec tramage ne sont pas prises en charge. Pour les images situées dans le HDU principal, les utilisateurs doivent transmettre hdu_indices=(0,), tandis que l'index HDU par défaut est 1. Les fichiers regroupés dans un seul appel doivent correspondre en forme et en type de données pour chaque HDU sélectionné.
Le module xRep rééchantillonne les images bidimensionnelles sur une grille céleste commune orientée « nord en haut » afin d'aligner les visites qui ne partagent pas une grille de pixels commune en raison du tramage, de la rotation ou des différences d'échelle de plaque. La fonction build_stack_spec_from_fits lit les solutions du système de coordonnées mondiales depuis les en-têtes FITS pour construire l'empreinte de destination, tandis que reproject_stack déforme chaque élément sur cette grille. Le paramètre backend est défini par défaut sur "auto", préférant CuPy, puis CUDA PyTorch et enfin le CPU si aucune GPU n'est disponible. L'interpolation utilise par défaut Lanczos-3. Cet alignement garantit que les étoiles statiques dans les images de référence et les images scientifiques occupent les mêmes coordonnées, permettant d'isoler la source mobile comme seule position modifiée dans le ciel avant la soustraction.