NVIDIA cuPhoton.xBeam transfère sur GPU la corrélation des données d'interférométrie des trous noirs
 Public
- 14 Nov, 2026
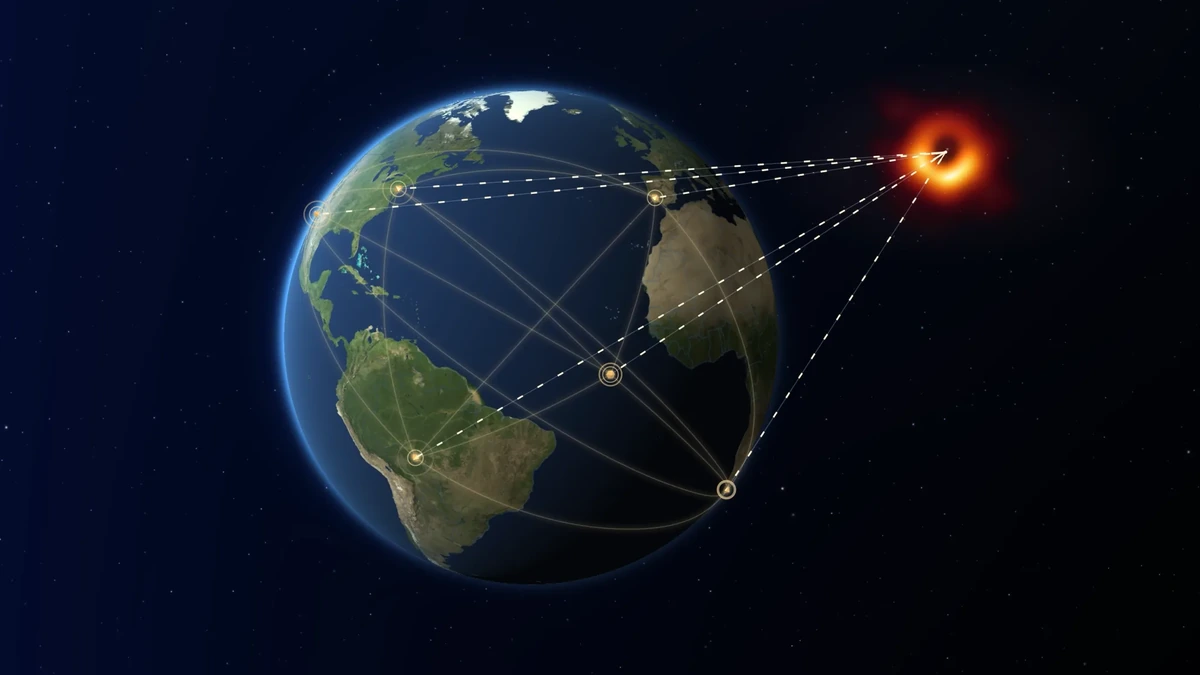
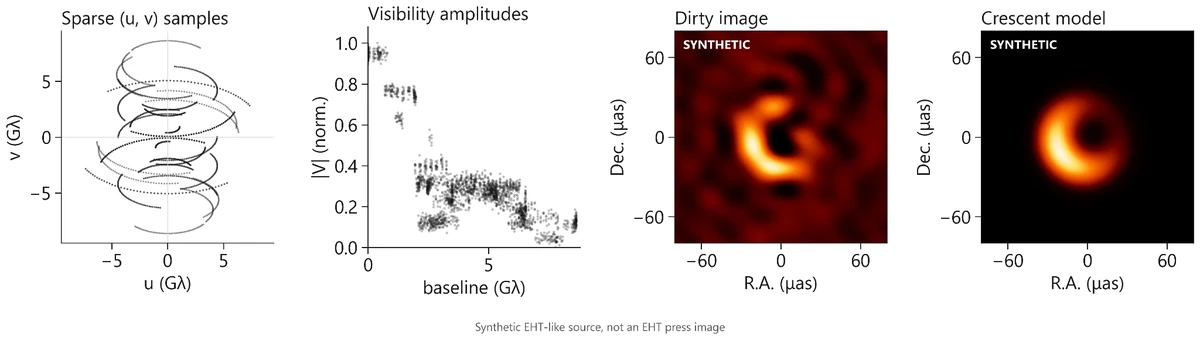
Pour photographier un trou noir, il faut distinguer un objet minuscule: l'anneau observé de M87* ne mesure que 42 microsecondes d'arc. L'Event Horizon Telescope (EHT) relie 13 stations radio, notamment à Hawaï, au Chili, en Espagne, au Mexique et au pôle Sud, grâce à l'interférométrie à très longue base (VLBI). Chaque station enregistre deux polarisations à un débit pouvant atteindre 64 Gbit/s, ce qui produit au total des pétaoctets de données de tension. La corrélation des paires de télescopes fournit des visibilités. Il s'agit d'échantillons de Fourier épars de la luminosité du ciel le long de traces dessinées par la rotation de la Terre. À partir de ces échantillons, les algorithmes de reconstruction résolvent un problème inverse. Avec des sources variables comme Sgr A*, qui évoluent pendant la session d'observation elle-même, la tâche devient encore plus difficile. L'EHT de nouvelle génération (ngEHT) prévoit d'ajouter de nouvelles stations afin d'améliorer la qualité des images et de suivre les changements au fil du temps.
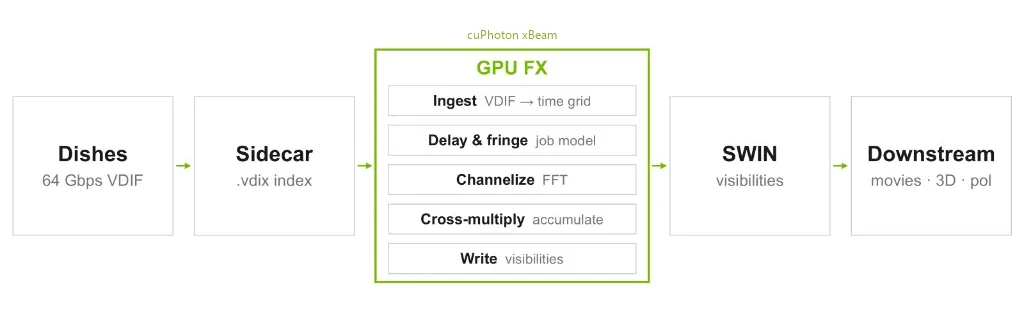
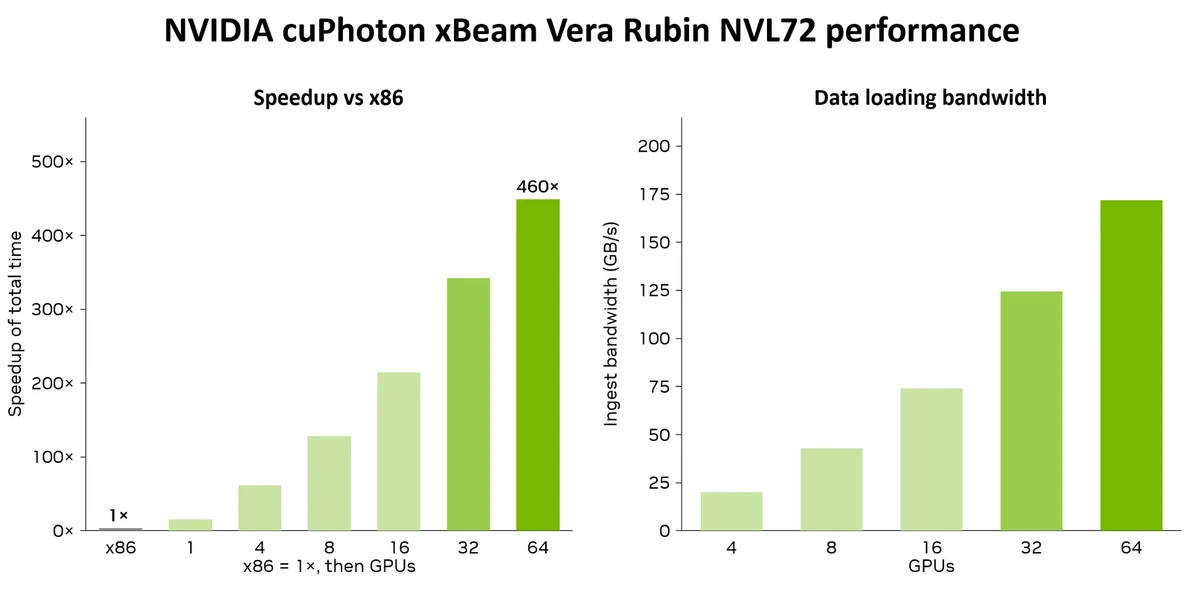
NVIDIA cuPhoton.xBeam est un corrélateur FX sur GPU. À partir des enregistrements bruts, il produit une visibilité complexe pour chaque paire de stations, chaque canal de fréquence et chaque court intervalle de temps. Le corrélateur a été développé avec le Harvard-Smithsonian Center for Astrophysics et l'observatoire MIT Haystack. Sur un système NVIDIA Vera Rubin NVL72, il a traité un jeu de données de 10 To en 70 secondes. Il a fallu pour cela 64 GPU et GPUDirect Storage en mode de compatibilité. C'est environ 460 fois plus rapide que sur un processeur x86, qui a mis 31 992 secondes, soit 8,89 heures. L'étalonnage et l'imagerie en aval, par exemple les modèles 3D de gaz fondés sur le Gaussian splatting, ne font pas partie de cuPhoton. xBeam ne calcule pas les retards à partir des positions des stations et ne trace pas les trajets de la lumière. Les résultats sont validés par rapport à DiFX, le corrélateur CPU open source, et les données de sortie sont destinées à des outils tels que HOPS, rPICARD et eht-imaging.
Le pipeline comporte cinq étapes. Lors de l'ingestion, chaque trame VDIF est placée à sa position temporelle correcte. Un fichier annexe .vdix est créé à côté : il indexe les trames par horodatage, par thread et par emplacement physique, sans copier les données elles-mêmes. Les données manquantes ou invalides sont alors signalées explicitement. Lors de la correction du retard et de la phase de frange, les données sont alignées à l'échantillon entier près avant la FFT, puis une rotation de frange leur est appliquée. Le retard fractionnaire restant est compensé par une correction de phase dépendant de la fréquence.
Le retard provient du fichier de tâche. Il se compose d'un polynôme géométrique autour de t0, du décalage et de la dérive d'horloge propres à chaque station, ainsi que d'un décalage d'horloge pour chaque bande. Au sein d'une même FFT, le retard peut être constant, linéaire ou parabolique : c'est le paramètre fringe_approximation_order (0, 1 ou 2) qui le détermine. Lors de la canalisation, une FFT est exécutée pour chaque station. Lors de la multiplication croisée avec accumulation, le spectre d'une station est multiplié par le conjugué complexe du spectre de l'autre. Les données d'entrée invalides sont masquées, et le résultat est normalisé à l'aide des poids d'exposition. La sortie est au format DiFX SWIN ou xbeam-v1.
La version 0.1.3 accepte une tâche normalisée au format JSON (version de schéma 1) ou un fichier DiFX .input pris en charge. Celui-ci répertorie les stations, les horloges, les fréquences, les flux de données VDIF, les lignes de base et les scans. Le répertoire de sortie doit être nouveau. La commande cuphoton xbeam inspect-vdif RECORDING.vdif --json lit uniquement les en-têtes. La commande build-vdif-sidecar avec les paramètres --index-dir, --backend cufile (ou posix, si GPUDirect Storage n'est pas disponible) et --devices crée des index réutilisables, sans modifier les fichiers sources. La commande cuphoton xbeam correlate JOB.json avec --backend cupy lance la corrélation sur le GPU. Par défaut, les données sont lues via POSIX dans la mémoire hôte épinglée, tandis qu'avec --vdif-io cufile via GPUDirect Storage. Parmi les options figurent --scan, --first-integration et --integration-count. Depuis Python, on peut appeler load_job et correlate avec CorrelationWindow et obtenir les enregistrements un par un, mais l'écriture au format SWIN n'est disponible que via la CLI.
Pour les enregistrements comportant des lacunes, il existe le profil --profile interop-real-usb-buffered-window-replay-v1. Avec ce profil, les échantillons situés dans le tampon conservé continuent d'être lus avec la référence temporelle existante, jusqu'à l'apparition d'un nouveau point d'ancrage. Le profil détermine également quels blocs FFT sont pris en compte et comment les poids sont rapportés. Il ne récupère pas les échantillons perdus, et un poids complet ne garantit pas que les données sont complètes. Sans ce profil, les trames sont alignées selon les horodatages des en-têtes et les emplacements manquants sont marqués comme invalides, de sorte que les visibilités et les poids peuvent différer. Pour la mise à l'échelle, un scan est découpé dans le temps. Sur un seul nœud, --devices 0,1,2,3 lance un processus par GPU, écrit les résultats dans RUN/shards/ et les fusionne. Sur plusieurs nœuds, chaque processus reçoit --shard-count et --shard-index, par exemple 64 avec les indices 0-63, en utilisant des paramètres de scans et d'intégrations identiques. Ensuite, merge-shards assemble les résultats SWIN partiels.