NVIDIA setzt KI-Agenten zur Automatisierung des Betriebs von KI-Fabriken und zur Entlastung der SRE ein
 Public
- 05 Nov, 2026
Mit der Skalierung von GPU-Clustern stehen Site-Reliability-Engineers (SRE) vor der Herausforderung, Leistungseinbrüche auf den Ebenen von Compute, Netzwerk und Hardware zu korrelieren. NVIDIA hat den AI Factory Operations Agent entwickelt, um den internen Betrieb von DGX SuperPODs zu optimieren und manuellen Aufwand zu reduzieren. Das System nutzt spezialisierte Agenten, die Fehler erkennen, Ursachen korrelieren und Empfehlungen über ein Chat-Interface bereitstellen. Ingenieure können mit diesen Agenten in natürlicher Sprache interagieren, zwischen Untersuchungen wechseln und Aktionen zur Nachvollziehbarkeit verfolgen, wodurch die manuelle Prüfung mehrerer Dashboards entfällt.
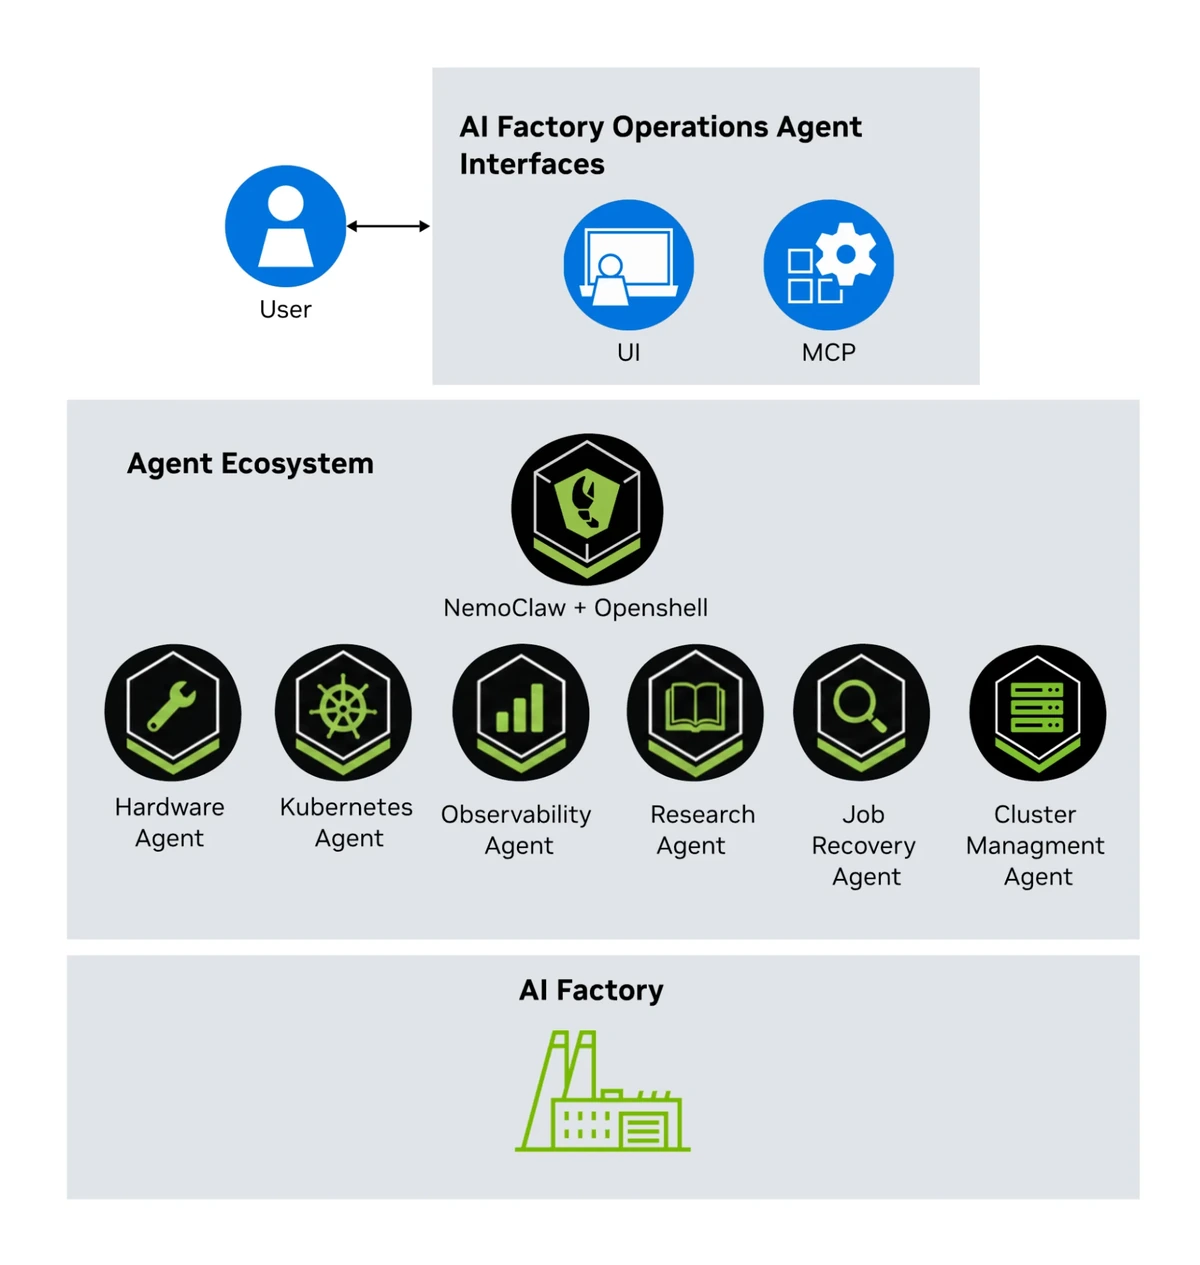
Das Entwicklerbeispiel basiert auf dem NVIDIA NemoClaw-Blueprint und umfasst eine nutzerseitige Agent-Runtime, die Anfragen an domänenspezifische Agenten weiterleitet. Die Verbindung wird über OpenClaw-Plugins und Model Context Protocol-Server hergestellt, die fokussierte operative Tools bereitstellen. Das Framework nutzt NVIDIA OpenShell und unterstützt eine vollständig lokale Bereitstellung, um die Datenhoheit sicherzustellen. Die Inferenz stützt sich auf lokal bereitgestellte offene NVIDIA Nemotron-Modelle, die in Produktionsclustern DGX H100, B200 und GB300 laufen. Dieses modulare Design ermöglicht das Hinzufügen neuer Agenten und Infrastrukturintegrationen, ohne bestehende Komponenten zu ändern.
Die Bereitstellung erfolgt als Kubernetes-Control-Plane-Anwendung, wobei Helm die UI, das OpenClaw-Gateway, die MCP-Server und die Inferenz-Endpunkte verwaltet. Für die Shell-Ausführung erstellt OpenShell pro Sitzung Kubernetes-Sandboxes, um Befehle vom Haupt-Gateway-Pod zu isolieren und sicherzustellen, dass die Runtime keine Produktionsworkloads verändert. Die Sicherheit wird durch mehrstufige Zugriffskontrollen durchgesetzt. Das serverseitige run_kubectl-Tool verwendet gepinnte Binärdateien und schreibgeschützte Zugangsdaten, während Kubernetes RBAC die einsehbaren Ressourcen definiert. Diese Konfiguration ermöglicht es den Agenten, Berechtigungen zu überprüfen, wie etwa die Bestätigung, dass sie Pods abrufen, aber keine Secrets lesen oder neue Pods erstellen können.
Die interne Bereitstellung nutzt eine Suite domänenspezifischer Agenten. Der Job Recovery Agent analysiert Trainingsfehler auf der Ebene des Schedulers und der Hardware. Der Hardware Agent triagt Gerätefehler wie PCIe-Fehler und thermische Anomalien. Der Observability Agent fragt Prometheus und Grafana Loki ab, um dynamische Dashboards zu generieren. Der Research Agent durchsucht vorbeladene Dokumentation, während der Kubernetes Agent schreibgeschütztes Wissen über den Clusterzustand bereitstellt. Der Cluster Management Agent interagiert mit den Base Command Manager-APIs. Querschnitts-Tools umfassen Websuche und Codeausführung, und das Framework unterstützt benutzerdefinierte MCP-Server für spezifische operative Bedürfnisse.
NVIDIA empfiehlt eine dedizierte, GPU-beschleunigte Control-Plane, die vom Produktionscluster isoliert ist, um die Agenten-Orchestrierung zu verarbeiten, ohne Trainingsressourcen zu verbrauchen. In Multi-Tenant-Umgebungen erzwingt OpenShell Grenzen, indem es Agenten in isolierten Sandboxes mit Kernel-Ebene-Einschränkungen ausführt und sicherstellt, dass Tenant-SREs nur auf ihre spezifischen Namespaces und Knoten zugreifen. Das Framework ist als experimentelle Open-Source-Software auf GitHub verfügbar, wobei sich APIs und Konfigurationen zwischen Releases ändern können. NVIDIA-Kunden können ihre Account Manager kontaktieren, um Zugang zu den proprietären Cluster-Operations-Agenten zu beantragen, die für den internen Gebrauch entwickelt wurden.