NVIDIA cuPhoton.xBeam verlagert die Korrelation von Interferometriedaten Schwarzer Löcher auf die GPU
 Public
- 14 Nov, 2026
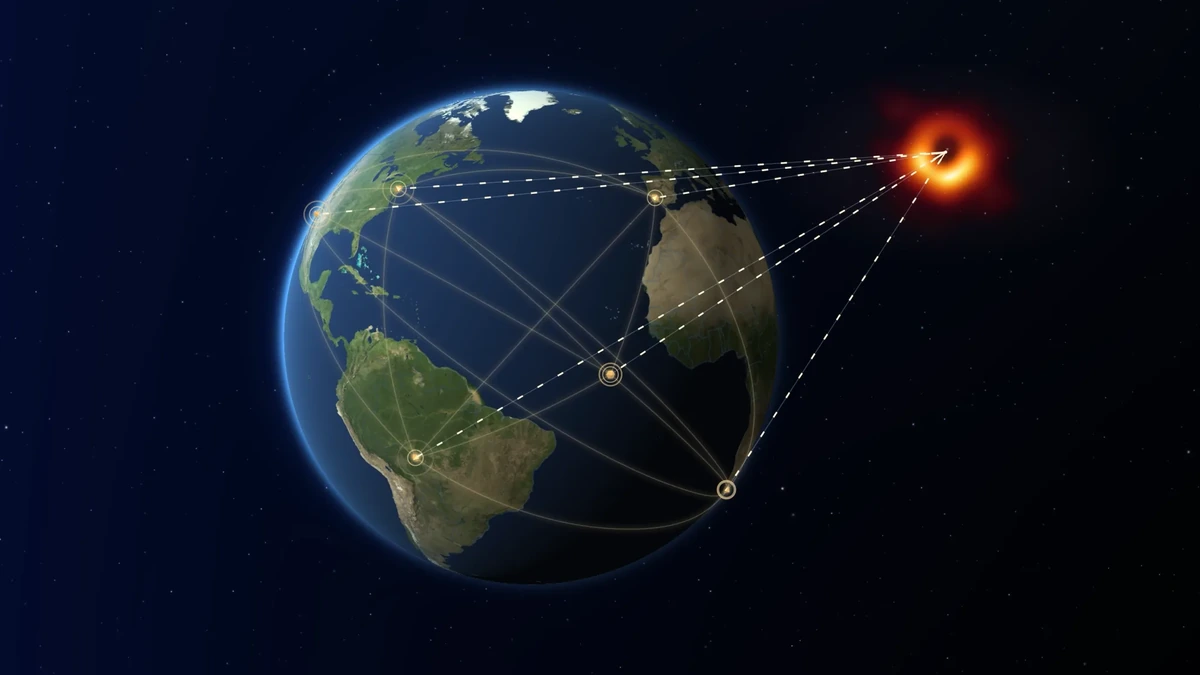
Um ein Schwarzes Loch abzubilden, muss man ein winziges Objekt auflösen: Der beobachtete Ring von M87* umfasst nur 42 Mikrobogensekunden. Das Event Horizon Telescope (EHT) verbindet 13 Radiostationen, unter anderem auf Hawaii, in Chile, Spanien, Mexiko und am Südpol, mittels Very-Long-Baseline-Interferometrie (VLBI). Jede Station zeichnet zwei Polarisationen mit bis zu 64 Gbit/s auf, sodass Petabytes an Spannungsdaten entstehen. Die Korrelation von Teleskoppaaren liefert Visibilities. Das sind spärliche Fourier-Stichproben der Himmelshelligkeit entlang von Spuren, die durch die Erdrotation gezogen werden. Aus diesen Stichproben lösen Rekonstruktionsalgorithmen ein inverses Problem. Variable Quellen wie Sgr A*, die sich noch während einer Beobachtungssitzung verändern, erschweren die Aufgabe zusätzlich. Für das EHT der nächsten Generation (ngEHT) ist geplant, weitere Stationen hinzuzufügen, um die Bildqualität zu verbessern und Veränderungen im Zeitverlauf zu verfolgen.
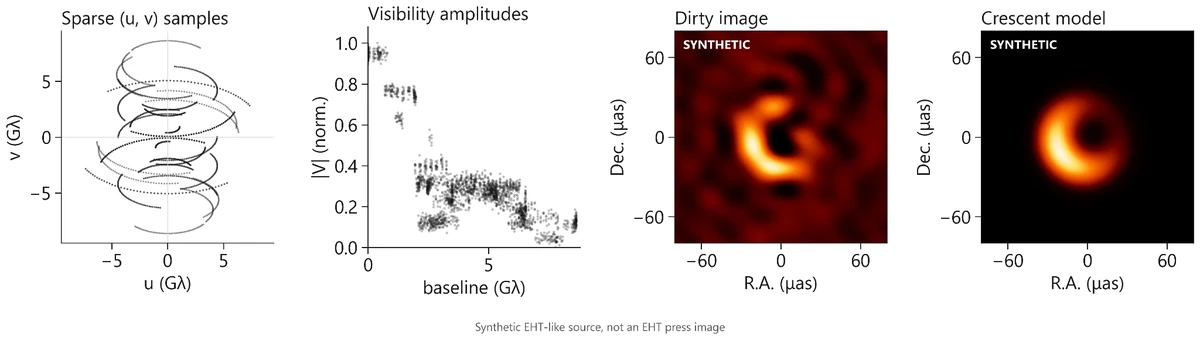
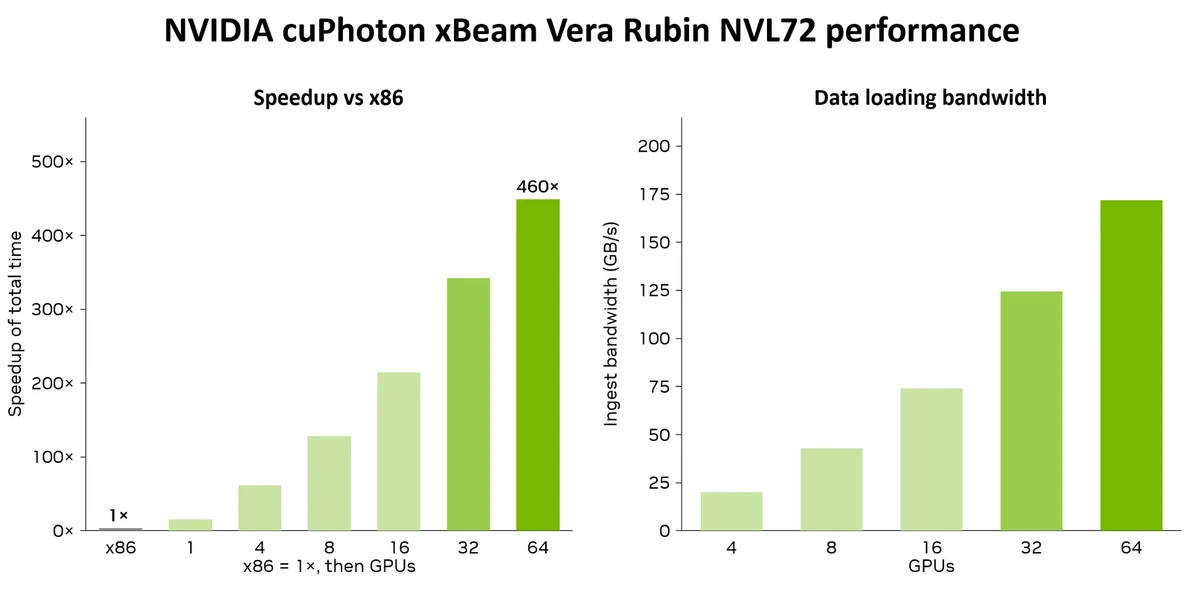
NVIDIA cuPhoton.xBeam ist ein GPU-basierter FX-Korrelator. Aus Rohaufzeichnungen erzeugt er jeweils eine komplexe Visibility pro Stationspaar, Frequenzkanal und kurzem Zeitintervall. Der Korrelator wurde gemeinsam mit dem Harvard-Smithsonian Center for Astrophysics und dem MIT Haystack Observatory entwickelt. Auf einem NVIDIA Vera Rubin NVL72-System verarbeitete er einen 10 TB großen Datensatz in 70 Sekunden. Dafür kamen 64 GPUs und GPUDirect Storage im Kompatibilitätsmodus zum Einsatz. Das ist etwa 460-mal schneller als auf einer x86-CPU: Dort dauerte es 31.992 Sekunden, also 8,89 Stunden. Die nachgelagerte Kalibrierung und Bildgebung, etwa 3D-Gasmodelle auf Basis von Gaussian Splatting, gehören nicht zu cuPhoton. xBeam berechnet keine Verzögerungen aus Stationskoordinaten und verfolgt keine Lichtwege. Die Ergebnisse werden mit dem Open-Source-CPU-Korrelator DiFX abgeglichen, und die Ausgabedaten sind für Werkzeuge wie HOPS, rPICARD und eht-imaging ausgelegt.
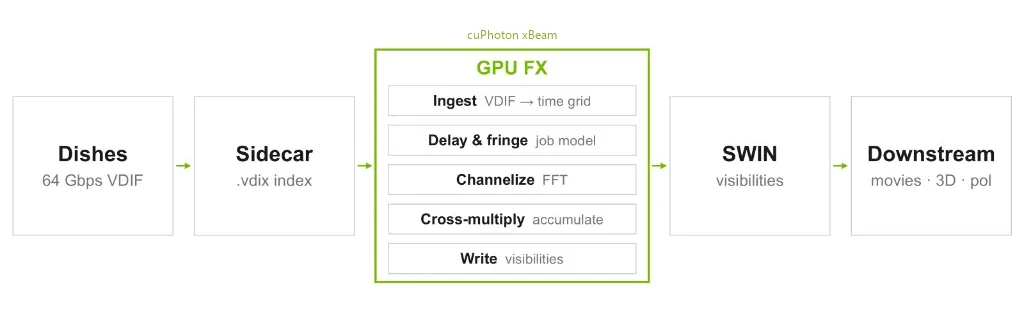
Die Pipeline besteht aus fünf Stufen. In der Aufnahmestufe wird jeder VDIF-Frame an seine korrekte zeitliche Position gesetzt. Daneben wird eine .vdix-Datei angelegt, die die Frames nach Zeitstempel, Thread und physischem Speicherort indiziert, ohne die Daten selbst zu kopieren. Fehlende und ungültige Daten werden dabei explizit gekennzeichnet. In der Stufe der Verzögerungs- und Fringe-Korrektur werden die Daten vor der FFT auf ganze Samples genau ausgerichtet, und es wird eine Fringe-Rotation angewendet. Die verbleibende gebrochene Verzögerung kompensiert eine frequenzabhängige Phasenkorrektur.
Die Verzögerung stammt aus der Job-Datei. Sie setzt sich zusammen aus einem geometrischen Polynom um t0, Uhrenversatz und -drift jeder Station sowie einem Uhrenversatz pro Band. Innerhalb einer FFT kann die Verzögerung konstant, linear oder parabolisch sein: Das legt der Parameter fringe_approximation_order fest (0, 1 oder 2). In der Kanalisierungsstufe wird für jede Station eine FFT ausgeführt. In der Stufe der Kreuzmultiplikation mit Akkumulation wird das Spektrum einer Station mit dem komplex konjugierten Spektrum der anderen multipliziert. Ungültige Eingabedaten werden maskiert, und das Ergebnis wird mit Belichtungsgewichten normiert. Die Ausgabe erfolgt im Format DiFX SWIN oder xbeam-v1.
Version 0.1.3 akzeptiert einen normalisierten Job im JSON-Format (Schemaversion 1) oder eine unterstützte DiFX-.input-Datei. Darin sind Stationen, Uhren, Frequenzen, VDIF-Datenströme, Basislinien und Scans aufgeführt. Das Ausgabeverzeichnis muss neu sein. Der Befehl cuphoton xbeam inspect-vdif RECORDING.vdif --json liest nur die Header. Der Befehl build-vdif-sidecar mit den Parametern --index-dir, --backend cufile (oder posix, falls GPUDirect Storage nicht verfügbar ist) und --devices erstellt wiederverwendbare Indizes, während die Quelldateien unverändert bleiben. Der Befehl cuphoton xbeam correlate JOB.json mit --backend cupy führt die Korrelation auf der GPU aus. Standardmäßig werden die Daten über POSIX in den gepinnten Hostspeicher gelesen, mit --vdif-io cufile - über GPUDirect Storage. Zu den Parametern gehören --scan, --first-integration und --integration-count. Aus Python lassen sich load_job und correlate mit CorrelationWindow und Datensätze einzeln abrufen, das Schreiben im SWIN-Format ist jedoch nur über die CLI möglich.
Für Aufzeichnungen mit Lücken gibt es das Profil --profile interop-real-usb-buffered-window-replay-v1. Damit werden Samples innerhalb des vorgehaltenen Puffers mit der bisherigen Zeitreferenz weiter eingelesen, bis ein neuer Ankerpunkt auftritt. Das Profil legt außerdem fest, welche FFT-Blöcke berücksichtigt werden und wie die Gewichte ausgewiesen werden. Verlorene Samples stellt es nicht wieder her, und ein volles Gewicht garantiert keine vollständigen Daten. Ohne das Profil werden die Frames anhand der Zeitstempel in den Headern ausgerichtet, fehlende Slots werden als ungültig markiert, daher können Visibilities und Gewichte abweichen. Bei der Skalierung wird ein Scan zeitlich aufgeteilt. Auf einem einzelnen Knoten --devices 0,1,2,3 startet einen Prozess pro GPU, schreibt die Ergebnisse in RUN/shards/ und führt sie zusammen. Über mehrere Knoten hinweg erhält jeder Prozess --shard-count und --shard-index, zum Beispiel 64 mit den Indizes 0-63, mit identischen Scan- und Integrationseinstellungen. Anschließend merge-shards führt die partiellen SWIN-Ergebnisse zusammen.