Платформа NVIDIA Minerva AIOps связывает телеметрию ИИ-фабрик для максимизации эффективности GPU
 Public
- 26 Oct, 2026
ИИ-фабрики представляют собой одни из самых сложных операционных сред, когда-либо созданных, где сотни тысяч GPU, сети NVIDIA Spectrum-X Ethernet, масштабируемые сети NVLink и распределенные планировщики работают в непрерывном синхронном режиме. При синхронном распределенном обучении вся задача продвигается с темпом самого медленного ранга, что означает: один деградировавший GPU, интерфейс или путь коммутатора могут привести к потере полезного времени на многих здоровых ресурсах. Сбои, снижающие эффективность, часто бывают незначительными: например, GPU работает немного горячее соседей, устройство NVMe теряет производительность под постоянной нагрузкой или коммутатор генерирует потоки кадров паузы. По отдельности эти сигналы редко превышают статические пороги, но в совокупности создают отставание, увеличивают время шагов и задерживают контрольные точки, что приводит к значительным производственным потерям.
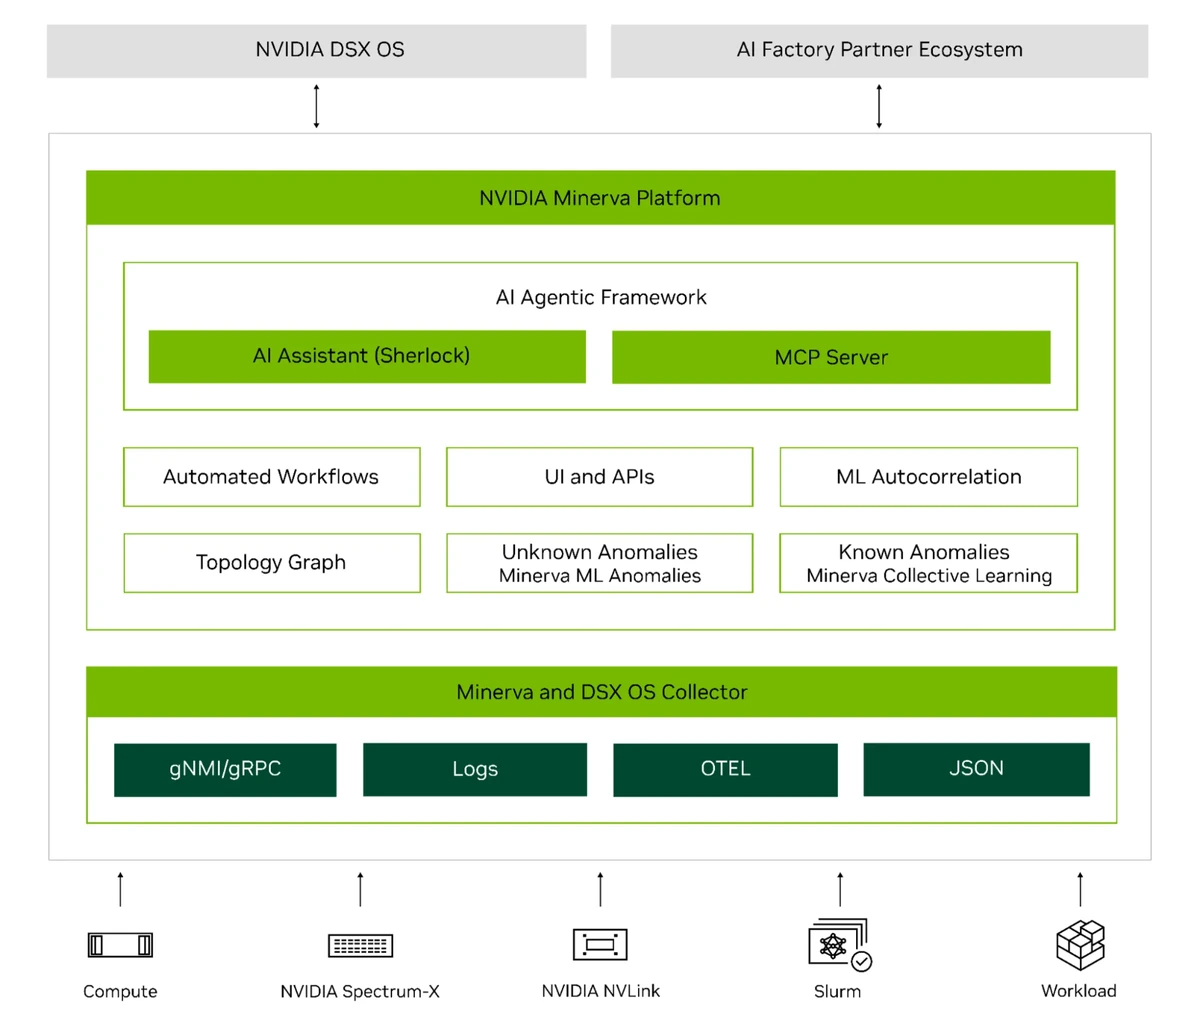
Диагностика усложняется тем, что доказательства разбросаны по разным командам: операторы сети видят счетчики интерфейсов, операторы вычислений - состояние узлов, а команды ML - изменение времени шагов. Эта фрагментация превращает первичную диагностику в цепочку поиска по дашбордам и передачи задач между командами, потенциально превращая локализованный сбой в дни потерянного производственного времени. NVIDIA Minerva закрывает эти пробелы, собирая телеметрию по всему стеку и отображая инфраструктуру в активных задачах в динамическом графе знаний. Она применяет специально разработанное машинное обучение для корреляции зависимых симптомов в инциденты высокой точности. Ассистент на базе ИИ-агента и MCP-сервер, подключенный к внешним агентным инструментам, обеспечивают диалоговый путь через эти живые данные, с основной целью сохранения эффективных часов работы GPU и обеспечения плавного хода обучения моделей.
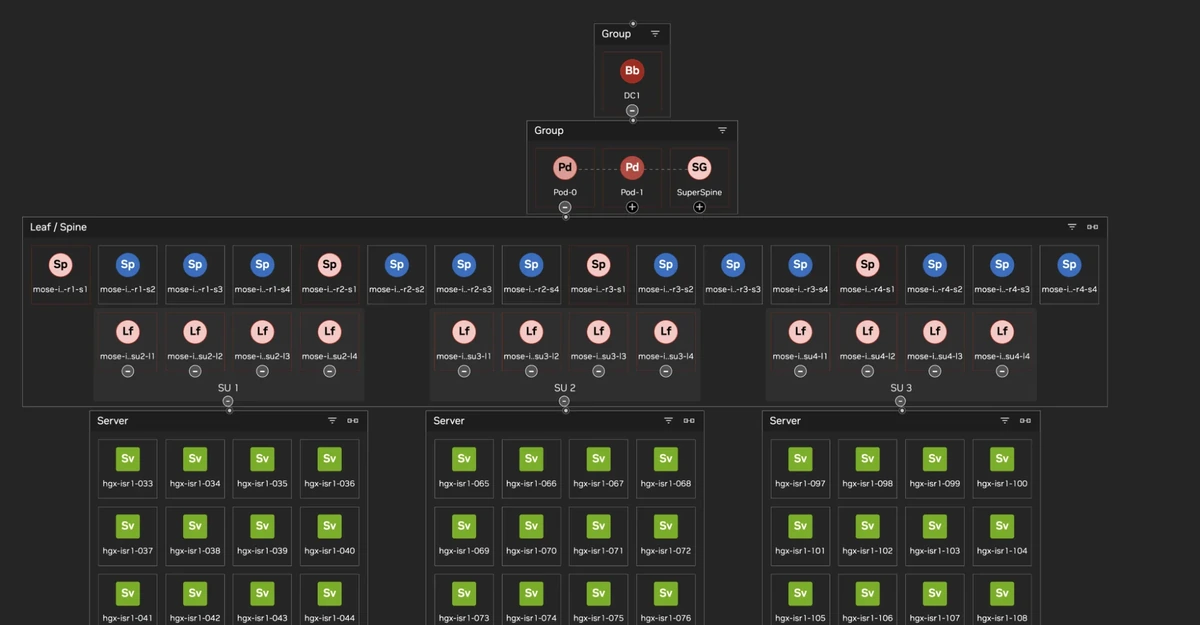
Мониторинг на основе правил плохо справляется с «серыми сбоями», когда компоненты остаются доступными, но проявляют проблемы только под нагрузкой или в сравнении с соседями. Абсолютные пороги часто пропускают эти изменения, а агрессивные пороги создают шум при обычных изменениях нагрузки. Масштаб усиливает эту проблему, поскольку одна физическая неисправность может порождать ошибки интерфейсов, индикаторы перегрузки и изменения использования GPU, которые выглядят как несвязанные события на разных дашбордах. Minerva принимает метрики, журналы и топологию с GPU, коммутаторов Spectrum-X и NVLink, SuperNIC, DPU, хранилищ, NCCL и планировщиков. Автообнаружение предоставляет связи, которых нет в сырой телеметрии, создавая граф знаний, отображающий элементы инфраструктуры, планировщика и рабочих нагрузок. Этот граф динамически обновляется по мере запуска, остановки задач или замены узлов, поддерживая навигацию от обзора всей фабрики до отдельного интерфейса.
Граф топологии трансформирует путь расследования, позволяя операторам отслеживать аномалии от интерфейса к его узлу, пути в сети и текущему размещению задачи. Напротив, ML-инженеры могут проследить ID задачи через доказательства на GPU, хосте, NIC и коммутаторе. Minerva обрабатывает миллиарды точек данных метрик и журналов в час, используя надзорные и ненадзорные модели. Надзорное обнаружение идентифицирует известные критические паттерны ошибок и связывает их с рекомендациями по устранению, а ненадзорные модели изучают нормальные паттерны для аппаратных или логических компонентов и сравнивают их с релевантными соседями. Сравнение с соседями критически важно, поскольку измерение может выглядеть приемлемым в изоляции, но аномальным в контексте, например, температура GPU в пределах спецификации, но значительно выше, чем у соседних GPU под той же нагрузкой. Мультивариантные модели объединяют температуру, мощность, частоты и использование для обнаружения деградации до полного отказа.
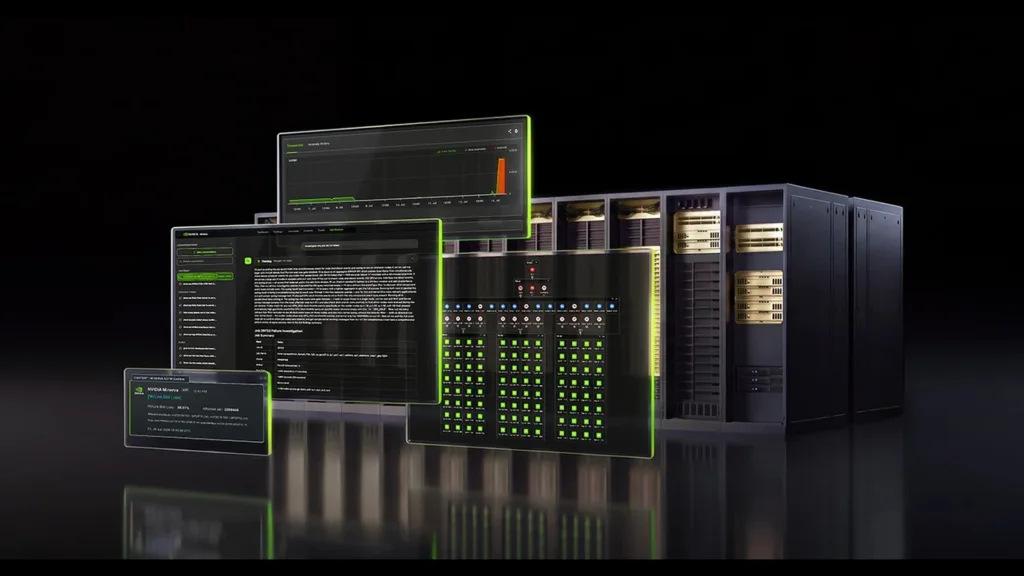
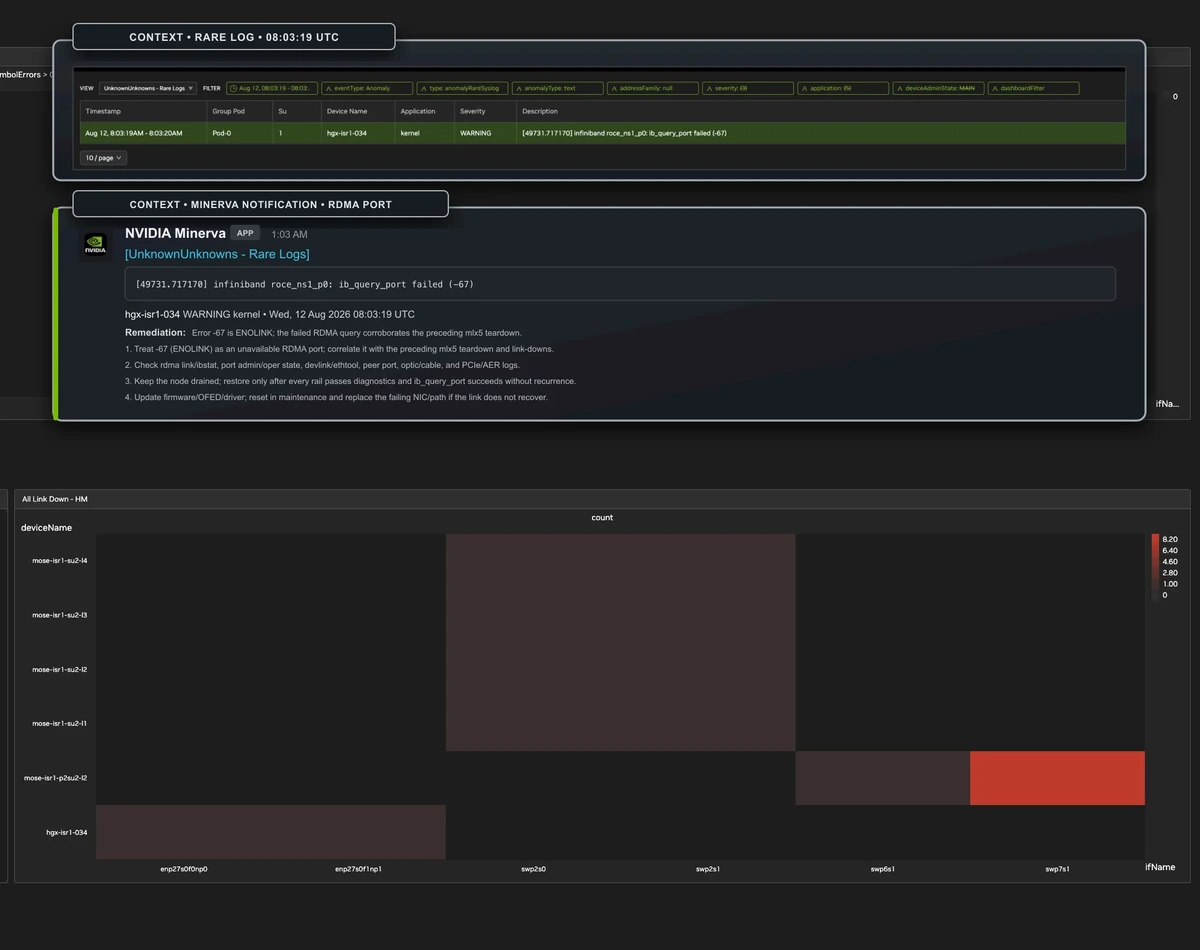
Журналы получают аналогичную обработку: обнаружение аномалий на основе NLP выявляет ранее невиданные паттерны, а надзорное сопоставление идентифицирует известные критические ошибки. Обнаружения могут передаваться в рабочие процессы планировщика для вывода затронутых узлов из эксплуатации до того, как на них попадут новые задачи, или в безопасные интервалы контрольных точек. Корреляция с учетом топологии связывает обнаружение с действиями оператора, используя граф знаний для определения, какие события разделяют путь зависимости. Вспомогательные симптомы группируются в единый инцидент, а не конкурируют за внимание, сводя избыточные события и связанные серии метрик в один сигнал с приложенной затронутой топологией и рабочими нагрузками. Тестирование NVIDIA показывает значительное сокращение числа уведомляемых событий и тикетов для поддерживаемых сценариев, позволяя операторам начинать с гораздо меньшего пространства поиска для анализа первопричин.
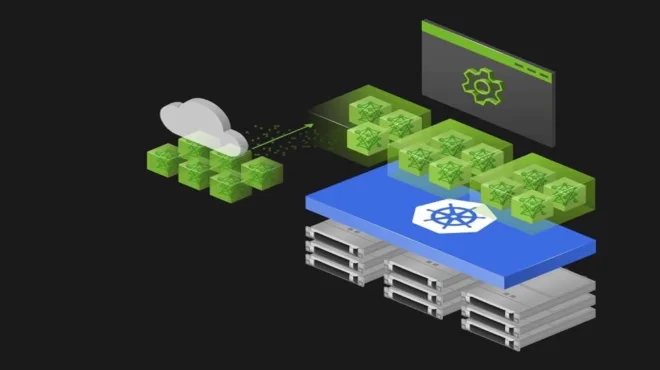
NVIDIA Minerva включает нативного ИИ-агента по имени Sherlock, основанного на живой телеметрии и графе знаний, который позволяет операторам запрашивать систему для анализа первопричин на естественном языке. Sherlock может представлять подтверждающие доказательства и рекомендовать меры по устранению, не требуя от операторов знания конкретных метрик или языков запросов, предоставляя путь к отраслевым знаниям, которые традиционно требовали эскалации к специалистам. Кроме того, MCP-сервер Minerva позволяет внешним агентным инструментам запрашивать тот же операционный контекст, позволяя командам включать живые данные ИИ-фабрики в собственные рабочие процессы. Меры по смягчению могут оставаться одобренными человеком или автоматизироваться в соответствии с локальной политикой и оценкой рисков. В крупном ИИ-дата-центре Minerva выявила одно соединение NVLink из 400 000 интерфейсов, теряющее пропускную способность, что позволило SRE вывести затронутые узлы из эксплуатации и восстановить полную скорость за минуты, а не часы.