NVIDIA cuPhoton ускоряет анализ астрономических изображений с помощью GPU-нативного конвейера
 Public
- 07 Oct, 2026
Научные приборы с высокой пропускной способностью, такие как обсерватории, телескопы и источники рентгеновского излучения, генерируют данные изображений со скоростью, превышающей возможности конвейеров, завязанных на CPU. Вычислительное узкое место редко заключается в одном медленном ядре; скорее, это весь путь от сырых данных датчика до научного решения, включающий считывание данных, сопоставление функций рассеяния точки, вычитание фона, подгонку моделей и классификацию объектов. Современные установки накапливают петабайты многомерных данных за одну кампанию, а реализации с приоритетом CPU могут занимать от часов до месяцев, чтобы дать полезные результаты из данных, созданных за секунды. Эта задержка мешает получению своевременных научных инсайтов. NVIDIA cuPhoton решает эту проблему, предоставляя GPU-нативный путь, охватывающий каждый этап от считывания с датчика до классификации, сокращая время ожидания до секунд и позволяя исследователям работать в тесных интерактивных циклах.
NVIDIA cuPhoton — это открытый инструментарий NVIDIA CUDA-X, состоящий из блоков с ускорением на GPU для спектральной и оптической астрономии, а также анализа лазеров и рентгеновских лучей во временной области. Удерживая данные изображений на GPU от начального считывания с датчика до финальной классификации, инструментарий значительно снижает задержку. Например, обсерватория Vera C. Rubin (NSF-DOE) записывает новое 3,2-гигапиксельное изображение каждые 39 секунд после наступления темноты. Её конвейер Prompt Processing должен классифицировать около 10 000 детекций как астрофизические транзиенты или артефакты в течение 60–120 секунд. За одну ночь это составляет до 20 терабайт изображений и 10 миллионов кандидатов объектов. cuPhoton масштабируется на много-GPU и многоузловые системы NVIDIA Grace Blackwell и Vera Rubin, ускоряя загрузку изображений до 14 900 раз и обработку сигналов до 14 550 раз на репрезентативных нагрузках, включающих сотни терабайт.
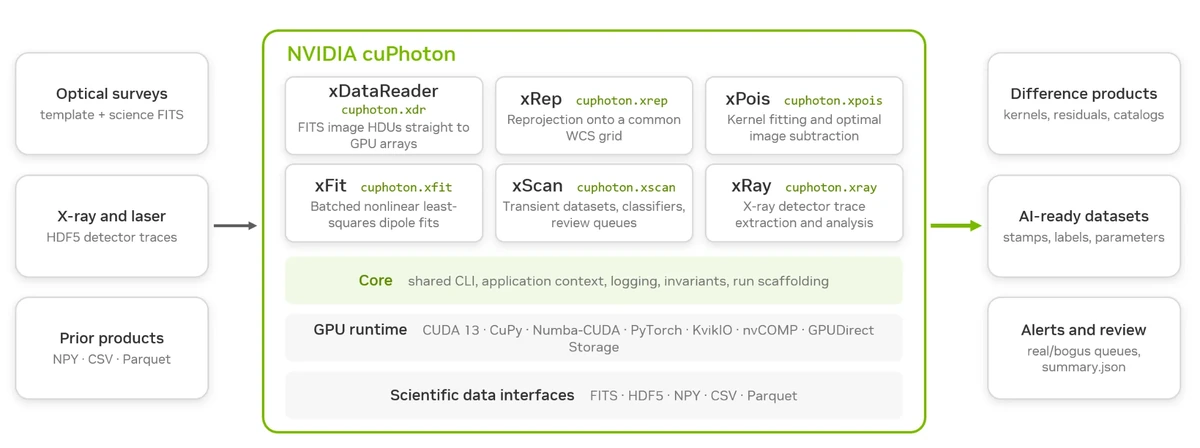
Инструментарий включает пять основных компонентов для рабочего процесса с изображениями: xDataReader, xRep, xPois, xFit и xScan, а также xRay для анализа детекторов рентгеновского излучения во временной области. Для настройки необходимо клонировать репозиторий и развернуть фиксированное окружение Linux с помощью команды uv sync --locked --extra dev --extra gpu --extra viz. Это окружение поддерживает экосистему NVIDIA CUDA 13, включая CuPy, PyTorch, Numba-CUDA, KvikIO и NVIDIA nvCOMP, а также библиотеки визуализации, такие как Bokeh и Pillow. Версия cuPhoton 0.1.3 поддерживает Python 3.12–3.14 на Linux. Сборка компонента xDataReader из исходного кода требует компилятора C++17, заголовков для разработки CUDA и cuFile, а также реентерабельной установки CFITSIO. Полный скрипт рабочего процесса доступен в репозитории для автоматического запуска или интерактивного использования в Jupyter-ноутбуках.
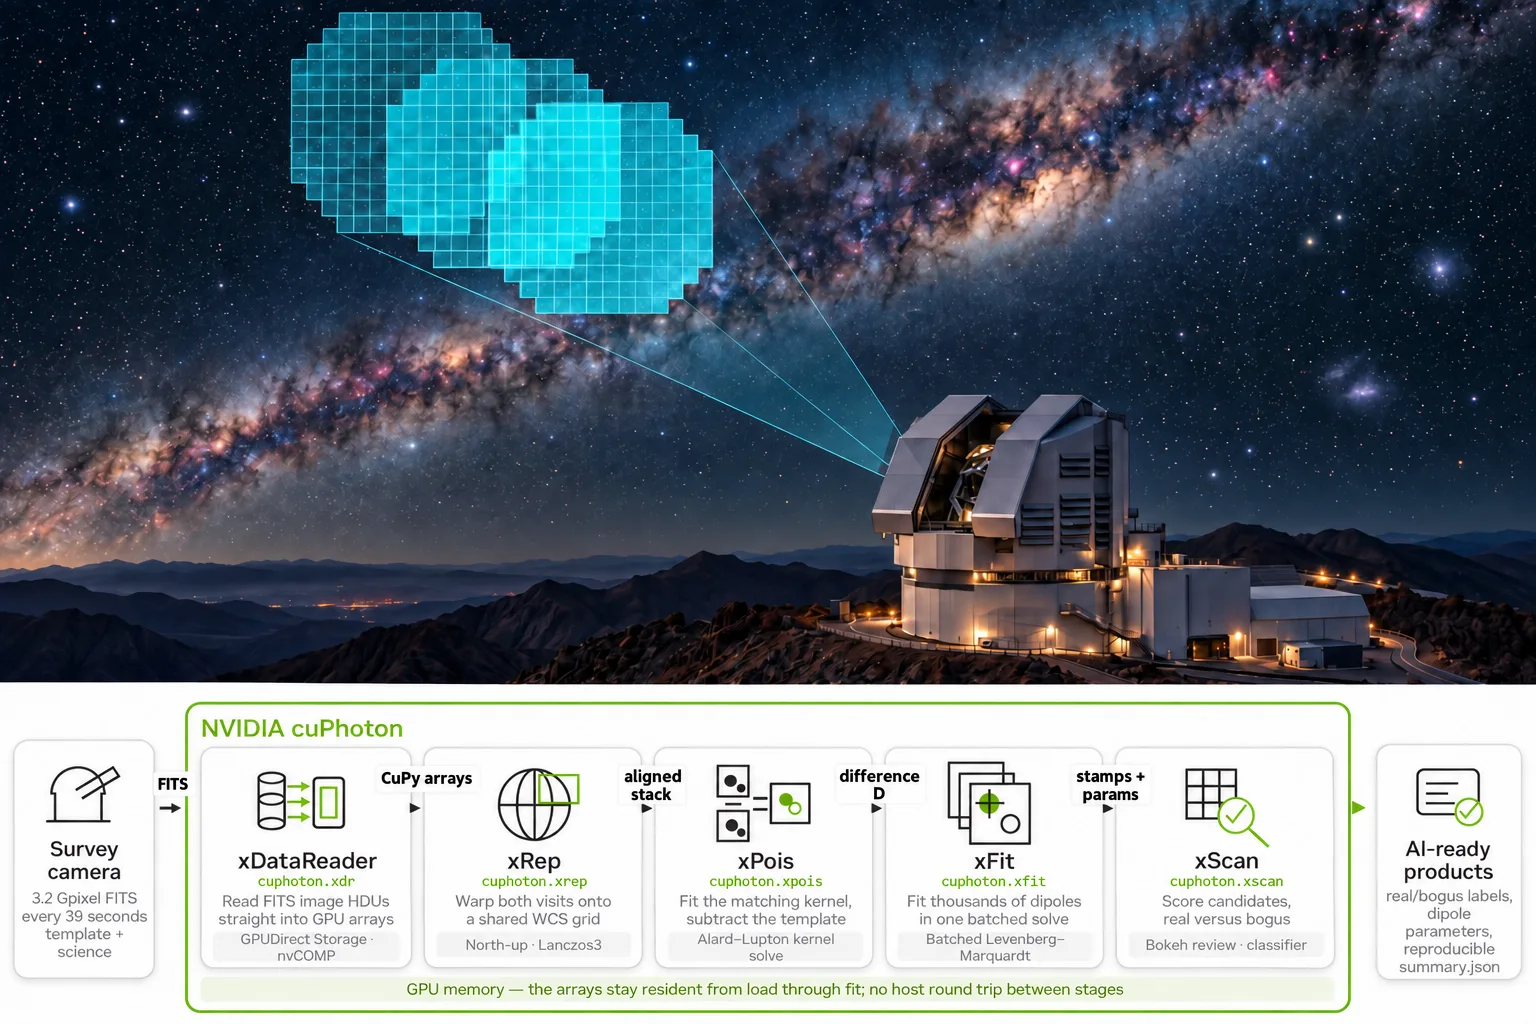
Модуль xDataReader ускоряет загрузку файлов в формате Flexible Image Transport System (FITS) непосредственно на GPU, минуя традиционные накладные расходы на парсинг CPU и передачу по PCIe. Он разделяет нагрузку: CFITSIO планирует байтовые диапазоны на CPU, KvikIO читает их через GPUDirect Storage (когда доступно), а nvCOMP распаковывает GZIP-плитки на GPU. Публичная функция API batch_to_device возвращает стопки массивов CuPy, поддерживая несжатые HDU изображений с 2–16 осями и двумерные изображения с плиточной компрессией GZIP_1 или GZIP_2. Компрессия Rice и дитеризованное квантование с плавающей точкой не поддерживаются. Для изображений в основном HDU пользователи должны передавать hdu_indices=(0,), тогда как по умолчанию используется индекс HDU 1. Файлы, сгруппированные в один вызов, должны совпадать по форме и типу данных в каждом выбранном HDU.
Модуль xRep пересэмплирует двумерные изображения на общую небесную сетку с ориентацией «севером вверх», чтобы выровнять визиты, не имеющие общей пиксельной сетки из-за дитеринга, вращения или различий в масштабе пластины. Функция build_stack_spec_from_fits читает решения системы мировых координат из заголовков FITS для построения целевого следа, а reproject_stack искажает каждый элемент на эту сетку. Параметр backend по умолчанию установлен в "auto", предпочитая CuPy, затем CUDA PyTorch и, наконец, CPU, если GPU недоступен. Интерполяция по умолчанию использует Lanczos-3. Это выравнивание обеспечивает, что статические звезды в шаблоне и научных кадрах занимают одни и те же координаты, позволяя изолировать движущийся источник как единственное изменившееся положение на небе перед вычитанием.