NVIDIA Green Contexts: Явное разделение ресурсов GPU для одновременных задач
 Public
- 07 Oct, 2026
Современные GPU-приложения часто запускают несколько независимых компонентов в рамках одного процесса. Например, операторы с высокой чувствительностью к задержкам работают рядом с фоновыми ядрами, ориентированными на пропускную способность. Эти компоненты обычно делят один GPU, что приводит к непредсказуемому взаимному влиянию и конкуренции за ресурсы. Традиционные контексты CUDA были созданы для эпохи, когда GPU обрабатывали один доминирующий тип нагрузки. Из-за этого они стали громоздкими и плохо подходят для тонкого разделения ресурсов. Они создают значительную нагрузку на оборудование при переключении контекстов и не имеют механизмов для явного определения того, как вычислительные ресурсы распределяются между одновременными задачами.
Green contexts решают эту проблему, позволяя приложениям явно выбирать подмножество ресурсов выполнения GPU и направлять работу непосредственно на эти ресурсы. Доступные в Driver API с версии CUDA 12.4, они теперь доступны через Runtime API начиная с CUDA 13.1. Эта функция позволяет разработчикам определять, где выполняется работа и как ресурсы распределяются внутри процесса. Основным сценарием использования является разделение SM, при котором определенные Streaming Multiprocessors назначаются green context. Это позволяет нескольким нагрузкам работать одновременно, не конкурируя за одни и те же вычислительные блоки.
Помимо выделения SM, green contexts могут выделять ресурсы очередей задач. В традиционной модели независимые потоки с упорядоченной работой могли отображаться на одни и те же базовые очереди задач, вызывая нежелательную последовательную обработку, даже если ресурсов выполнения было достаточно. Явно выделяя очереди задач, green contexts позволяют приложениям задавать ожидаемую степень параллелизма и устранять ложные зависимости. Создание и удаление этих контекстов требует малых затрат, а их жизненный цикл не вызывает неявной синхронизации несвязанных GPU-операций. Это обеспечивает более явную модель программирования, чем полагаться на неявное состояние устройства.
Модель программирования смещается от неявного к явному целеуказанию. Исторически приложения использовали cudaSetDevice и создавали потоки, для которых цель выполнения выводилась из текущего состояния устройства, привязанного к потоку. С green contexts, представленными типом cudaExecutionContext_t, разработчики создают контекст для выбранного набора ресурсов, а затем создают из него потоки с помощью cudaExecutionCtxStreamCreate. Это гарантирует, что работа, отправляемая в эти потоки, строго связана с ресурсами green context. Для приложений, нацеленных на все устройство, традиционная модель остается доступной через cudaDeviceGetExecutionCtx, что обеспечивает обратную совместимость и постепенное внедрение.
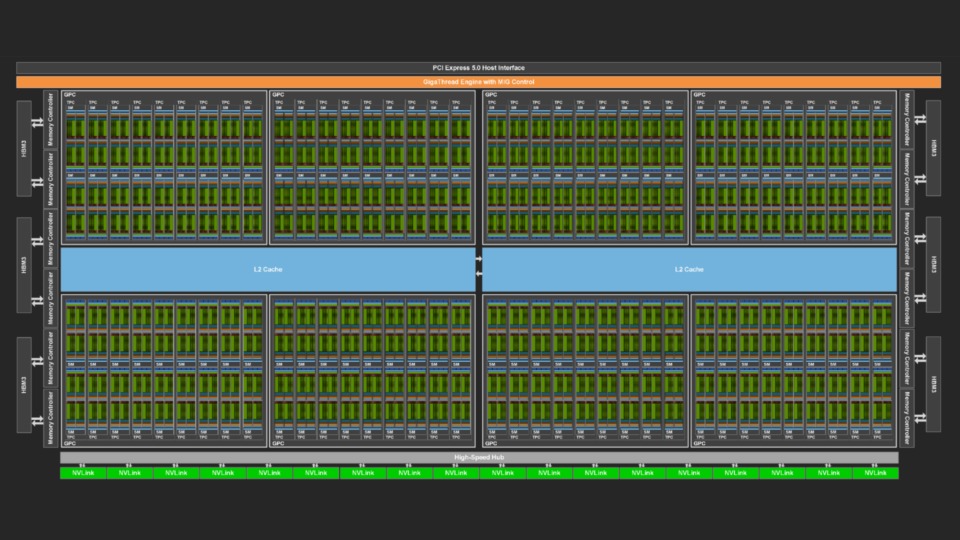
Классическим примером использования является перекрытие операций связи с ядрами GEMM в распределенном обучении или обработка операторов с высокой чувствительностью к задержкам на AI-сенсорных платформах. Одного приоритета потоков недостаточно, когда объемные ядра занимают все SM, поскольку планировщик не может прервать выполняющиеся блоки. Green contexts выделяют определенные SM для критически важной работы, минуя ожидание завершения объемных блоков. Тестирование на GPU NVIDIA Blackwell с 148 SM показало, что если приоритет потоков обеспечивает улучшение в 27 раз по сравнению с потоками равного приоритета, то green contexts обеспечивают дополнительное снижение задержки в 20 раз, гарантируя выделенные ресурсы для критического ядра.
Реализация включает запрос ресурсов устройства, разделение SM на группы критических и оставшихся, а также упаковку каждой группы с конкретными конфигурациями очередей задач. Разработчики используют cudaDevSmResourceSplit для выделения ресурсов и cudaDevResourceGenerateDesc для создания дескрипторов. Green contexts включаются по желанию и являются дополнением, позволяя существующим приложениям продолжать использовать все устройство, одновременно внедряя более тонкий контроль там, где это необходимо. Этот подход особенно полезен для достижения целевых показателей параллелизма или задержки в сложных рабочих процессах, предлагая надежный механизм управления разделением ресурсов GPU в современных многокомпонентных приложениях.