Ограничение памяти GPU по нагрузкам в Kubernetes с CUDA 13.4 и планировщиком KAI
 Public
- 28 Oct, 2026
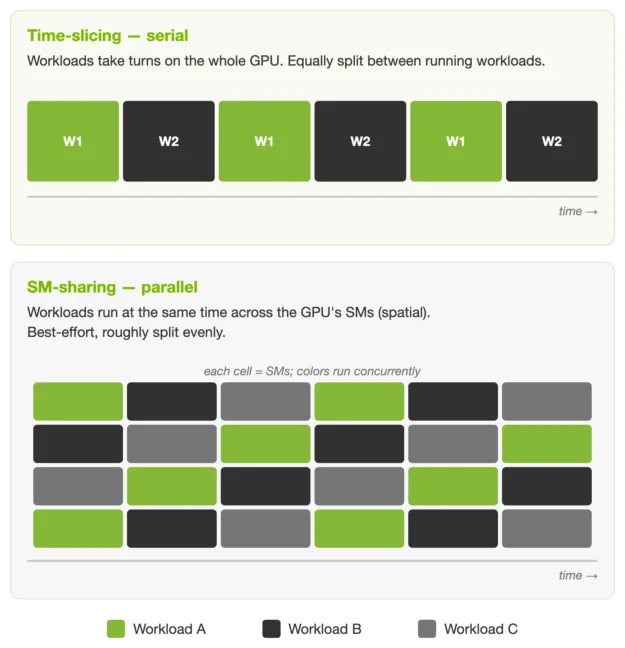
AI-нагрузки часто требуют лишь части GPU, но выделение целых устройств приводит к простаивающим мощностям и неэффективному использованию инфраструктуры. GPU NVIDIA поддерживают различные механизмы разделения: Multi-instance GPU (MIG) для аппаратной изоляции, time-slicing для последовательного выполнения процессов и Multi-Process Service (MPS) для параллельного выполнения в отдельных пространствах адресов. Хотя MPS позволяет делить вычислительные ресурсы, ранее в нем отсутствовали строгие границы памяти. CUDA 13.4 закрывает этот пробел, вводя новый режим time-sharing, который прозрачно для приложения ограничивает память, гарантируя, что каждая нагрузка работает в заданных пределах без изменения кода.
Реализация этих возможностей в кластере Kubernetes требует координации на уровне узлов, независимой от планировщика. Оператор gpu-fractioning с открытым исходным кодом, размещенный в организации KAI Scheduler на GitHub, работает вместе с NVIDIA GPU Operator для настройки этих параметров. Он выполняет три ключевые функции: читает аннотации подов для определения требований к памяти и вычислениям, настраивает выделенные GPU для принудительного соблюдения этих лимитов и управляет переключением между режимами разделения. Этот оператор обеспечивает соблюдение аппаратом логических границ, заданных планировщиком кластера, связывая высокоуровневые решения о планировании с низкоуровневым выполнением на GPU.
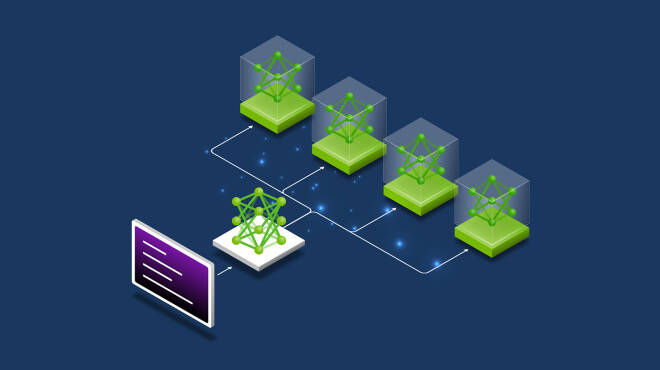
Процесс начинается с того, что разработчики указывают требования к ресурсам и режимы через аннотации YAML подов. Затем планировщик выбирает подходящие GPU, записывает выделение памяти и режим разделения вычислений в аннотации подов для каждого контейнера и назначает нагрузку. Оператор gpu-fractioning читает эти аннотации и настраивает GPU соответственно. Любой планировщик Kubernetes, способный записывать эти аннотации, может ограничивать доли GPU, если он соблюдает два правила: выбирать GPU с достаточной свободной памятью и не смешивать режимы вычислений на одном устройстве. Планировщик KAI первым интегрировал эту функцию, представив режим разделения GPU под названием NvFractions начиная с версии v0.18.0.
Режим NvFractions в планировщике KAI позволяет администраторам определять дробные нагрузки с помощью четырех ключевых аннотаций, которые регулируют запросы памяти, лимиты роста, режимы разделения вычислений и количество устройств. Запросы памяти можно указывать как абсолютные размеры с использованием стандартных единиц Kubernetes или как доли GPU с помощью аннотации gpu-fraction. Новая возможность позволяет нагрузкам объявлять гарантированный минимальный запрос и максимальный лимит всплеска, который является необязательным и по умолчанию равен значению запроса, если не указан. Лимиты долей должны превышать gpu-fraction и оставаться ниже 1. Разделение вычислений теперь явно задается для каждого контейнера, позволяя выбирать между sm-sharing и time-slicing.
Общий GPU работает только в одном режиме вычислений за раз, поэтому планировщик KAI предотвращает размещение нагрузок с разными режимами на одном GPU, хотя один узел может содержать оба режима на разных устройствах. Для конфигураций с несколькими GPU аннотация gpu-fraction-num-devices указывает, на сколько устройств распространяется нагрузка, при этом запрос памяти применяется к каждому устройству индивидуально. Например, запрос 40Gi с четырьмя устройствами выделяет 40Gi на каждом GPU. Такая настройка идеальна для серверов инференса, которым нужна гарантированная память на каждый GPU и возможность всплеска, когда соседи простаивают, используя sm-sharing для доверенных нагрузок, выполняемых параллельно в одной области ошибок.
Напротив, time-slicing подходит для разработки или пакетных задач, таких как ноутбуки и небольшие прогоны дообучения, где предпочтительна изоляция. В этом режиме каждая нагрузка получает собственную область ошибок, что означает, что сбой в одной задаче не влияет на другие. Нагрузка может запросить половину двух GPU с лимитом роста до 80%, когда память доступна. Запуск nvidia-smi внутри контейнера отобразит дробную долю памяти для каждого выделенного GPU. Оба инструмента, KAI Scheduler и оператор gpu-fractioning, доступны на GitHub в организации KAI Scheduler, с подробными руководствами по установке и конфигурации для всех механизмов разделения.