Оптимізація AI-інференсу через спільне проєктування пам'яті на всіх рівнях стеку
 Public
- 06 Nov, 2026
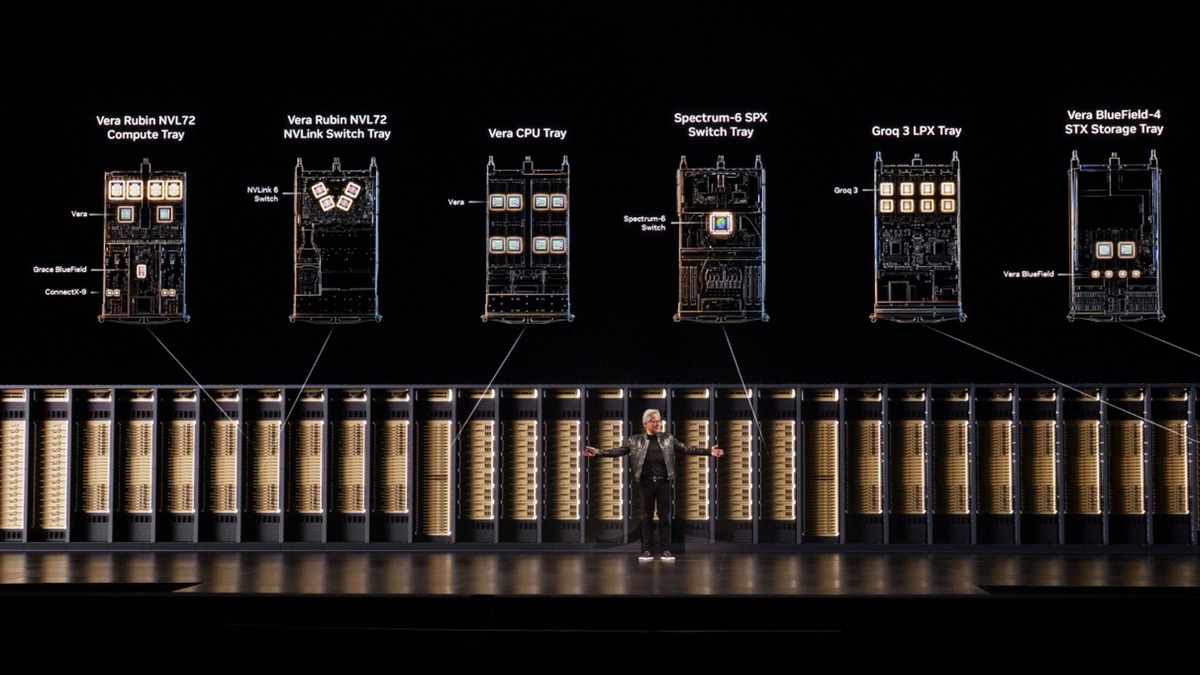
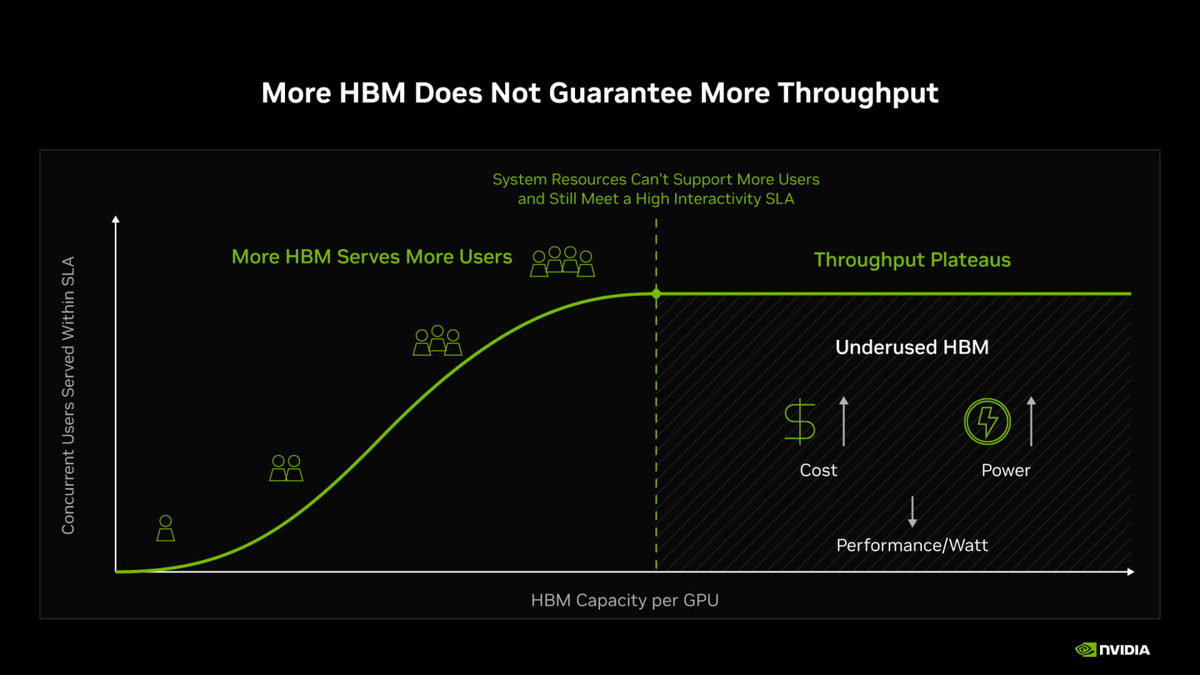
Стрімке розширення великих мовних моделей, збільшення контекстних вікон та зростання агентних застосувань створюють дедалі сильніший тиск на ресурси пам'яті GPU. На тлі посилення умов постачання та зростання цін галузь стикається з критичним викликом: як обробляти більше даних, не вдаючись до простого нарощування дорогого обладнання. NVIDIA вирішує цю проблему, відмовляючись від традиційного підходу, заснованого на встановленні більшого обсягу пам'яті High Bandwidth Memory (HBM) на чипи. Замість цього компанія застосовує стратегію повного спільного проєктування (full-stack codesign), де GPU, CPU, мережеве обладнання, системи зберігання та програмне забезпечення розробляються синхронно. Ця цілісна мета - видобути максимум корисної роботи з кожного байта пам'яті в усій інфраструктурі AI-фабрики, а не покладатися виключно на збільшення сирової ємності.
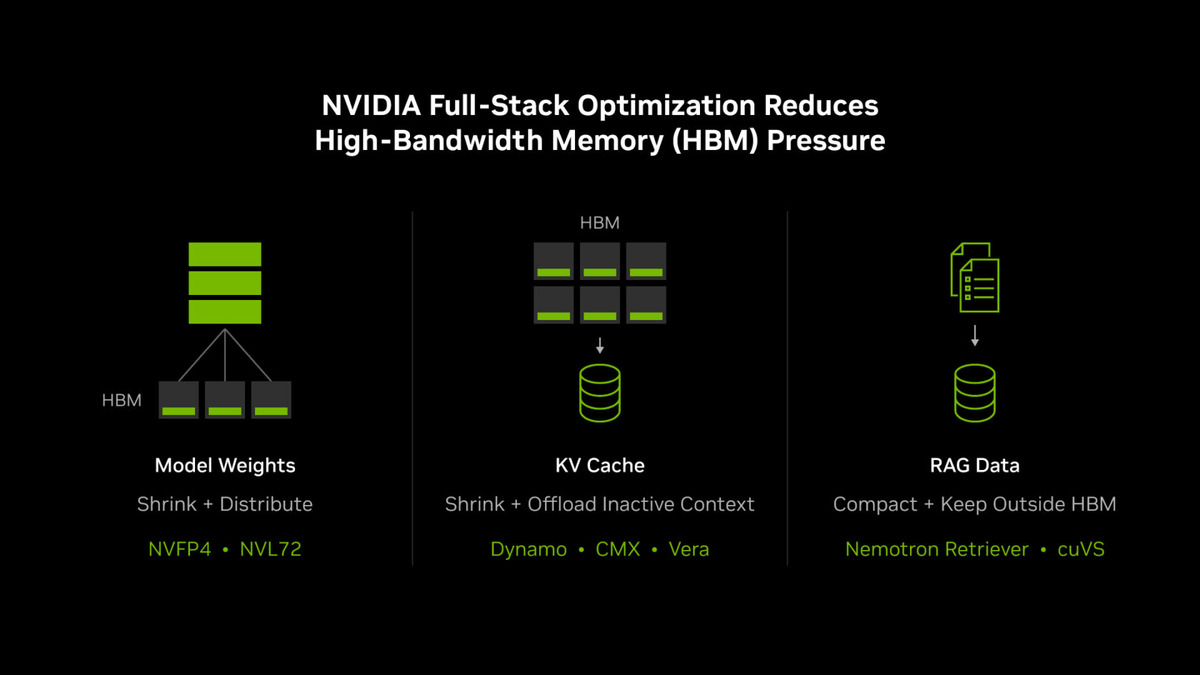
Суть цієї стратегії полягає в ефективному управлінні ієрархією пам'яті та зберігання. В AI-фабриці HBM виступає найшвидшим, але найдорожчим і найпопулярнішим рівнем, що зберігає критично важливі дані, такі як ваги моделей та кеш Key-Value (KV). Нижче цього рівня розташовані пам'ять CPU, локальні SSD та спільне сховище, які пропонують більший обсяг за менші гроші, але з меншою швидкістю. Ефективність системи залежить від того, наскільки грамотно дані розміщуються та переміщуються між цими рівнями. Зменшуючи розмір ваг моделей, вивантажуючи неактивні контексти KV-кешу в дешевше сховище та ущільнюючи ембединги для генерації з доповненням з пошуку (RAG), NVIDIA забезпечує, щоб обмежений простір HBM залишався доступним для активних операцій високого пріоритету. Це запобігає ефекту «стіни пам'яті», коли обчислювальні блоки простоюють у очікуванні даних через насичення пропускної здатності, підтримуючи низьку затримку для одночасних користувачів.
Вплив такого підходу до спільного проєктування наочно видно в останніх метриках продуктивності платформ. Від покоління Blackwell Ultra до майбутньої платформи Vera Rubin обсяг HBM на один GPU зріс лише на 3%. Однак приріст ефективності виявився значним. У бенчмарку SemiAnalysis AgentX пропускна здатність агентних задач на долар зросла до 30 разів. Зокрема, NVIDIA GB300 NVL72 забезпечує пропускну здатність на долар до 10 разів вищу, ніж платформа H200, при швидкості 100 токенів на секунду на користувача, попри подвоєння обсягу HBM. Очікується, що Vera Rubin NVL72 забезпечить пропускну здатність на долар до 30 разів вищу, ніж GB300 NVL72, при швидкості 125 токенів на секунду на користувача, при цьому обсяг HBM збільшиться лише на 3%. Це демонструє, що оптимізація потоку даних та розміщення в сховищі приносить значно більшу віддачу, ніж просте розширення обсягу пам'яті.
Для операторів AI-фабрик ключовим показником є кількість корисних токенів, доставлених у межах конкретного енергетичного бюджету з дотриманням суворих вимог до часу відповіді. Збільшення кількості токенів на секунду на ват безпосередньо веде до зростання доходу від тієї ж енергетичної інфраструктури та зниження вартості за токен. Знімаючи навантаження з HBM за рахунок ваг моделей, простоючого контексту та даних RAG, повне спільне проєктування гарантує, що ресурси пам'яті використовуються для активного інференсу, а не пасивного зберігання. Цей метод дозволяє системам обробляти трильйони параметрів і складні агентні траєкторії, які можуть включати обробку до 3 мільйонів токенів, без вузьких місць, спричинених пропускною здатністю пам'яті. Результатом стає більш масштабована та економічно ефективна інфраструктура, здатна підтримувати наступне покоління AI-додатків.