NVIDIA TensorRT 11.1: глобальний тюнер продуктивності для автоматичної оптимізації рушіїв з урахуванням точності
 Public
- 24 Oct, 2026
Розгортання нейронних мереж - це по суті задача компіляції, де не існує єдиної оптимальної стратегії для всіх моделей. Коли NVIDIA TensorRT збирає рушій інференсу, він приймає взаємозалежні рішення щодо трансформацій графа, злиття ядер, розміщення пам'яті та квантування. Цей процес, відомий як планування (scheduling), суттєво впливає на кінцеву продуктивність інференсу. Різні варіанти планування можуть зберігати семантику моделі, але давати зовсім різні результати за швидкістю. Оскільки ці ефекти пов'язані між собою та залежать від конкретної моделі, вони часто проявляються лише після повної збірки та вимірювання рушія. Це робить передбачення найкращої стратегії дедалі складнішим міру різноманітності моделей і середовищ розгортання.
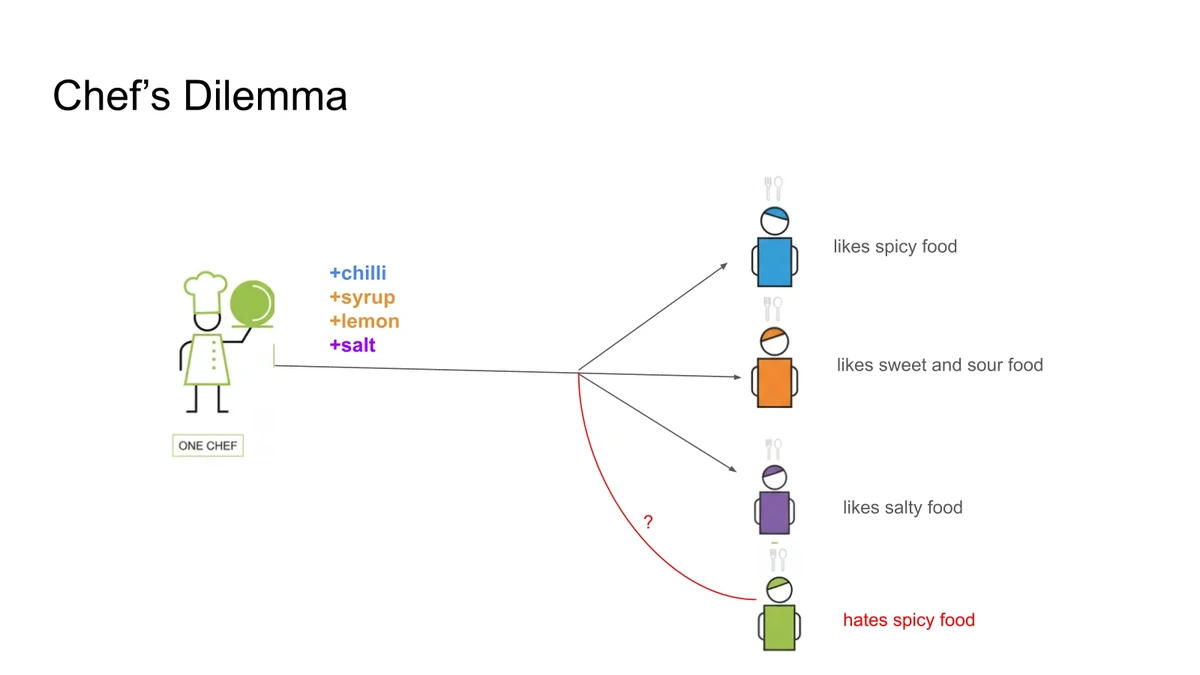
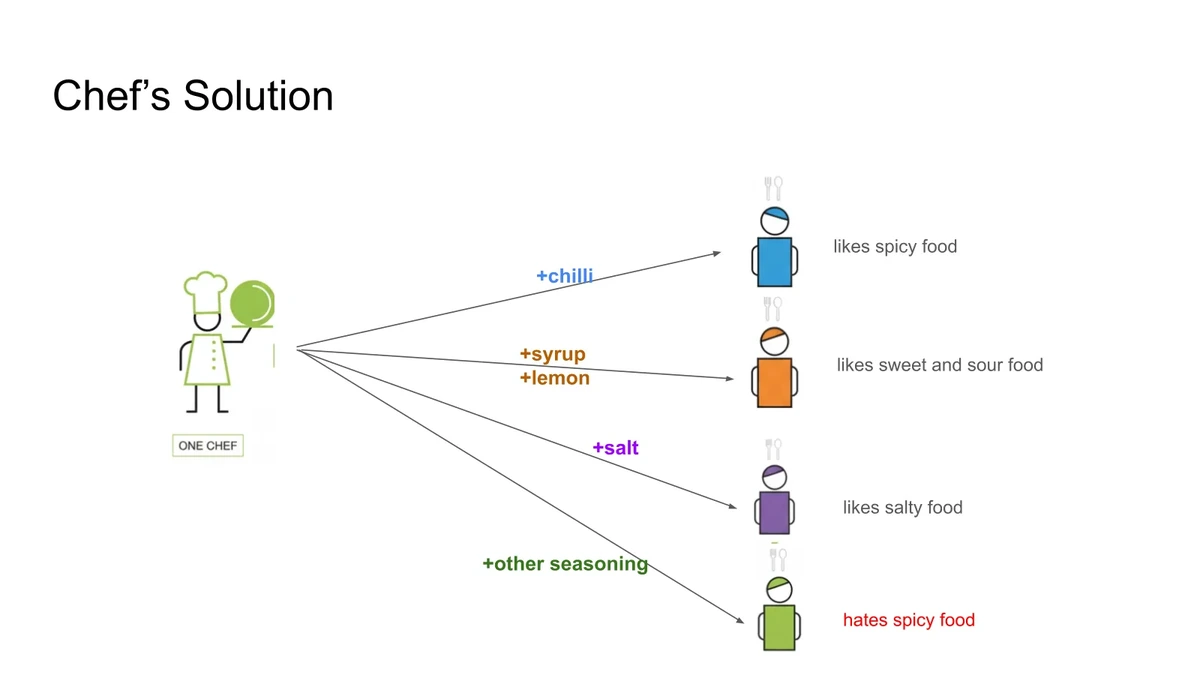
Історично TensorRT спиралися на внутрішні моделі ключових показників ефективності (KPI) для виявлення оптимізованих патернів, які потім кодувалися як евристики у стандартній стратегії планування. Хоча це дозволяло користувачам автоматично користуватися експертними знаннями, виникла проблема масштабованості. Евристика, розроблена для одного типу моделей, могла спричиняти погіршення продуктивності в іншому, що вимагало додаткових винятків. Це робило логіку планування складною та важкою для розширення. Global Performance Tuner, представлений у TensorRT 11.1, вирішує цю проблему, відмовляючись від єдиного фіксованого рецепта. Натомість він розглядає конвеєр компілятора як базовий рецепт із налаштовуваними «спеціями», що дозволяє системі адаптувати шлях оптимізації під конкретні характеристики вхідної моделі, будь то граф ONNX або мережа, створена через API TensorRT.
Щоб формалізувати цей підхід, система використовує математичну рамку, яка розділяє генерацію кандидатів та їхній вибір. Простір моделей складається з усіх можливих вхідних даних, а простір рішень - з усіх виконуваних виходів, таких як рушії TensorRT або серіалізовані послідовності GPU-ядер. Алгоритм збірки (builder) відображає модель у набір кандидатів, обмежений порогом допустимої похибки. Цей порік гарантує, що пари «вхід-вихід» залишаються в допустимих межах, запобігаючи агресивним оптимізаціям, які порушують вимоги застосунку. Мета алгоритму збірки - згенерувати багатий набір кандидатів, що включає оптимальне рішення, визначене як найшвидше допустиме виконання, яке відповідає критеріям точності. Ця абстракція дозволяє ретельно аналізувати, як різні маршрути збірки впливають на кінцевий час виконання.
Потім алгоритм пошуку працює з цим набором кандидатів, щоб обрати найкраще рішення. Ідеально, цей алгоритм мав би виконати перебір усіх кандидатів, щоб знайти той із мінімальним часом виконання. Однак на практиці бюджети часу збірки часто обмежують глибину такого пошуку. Таким чином, весь компілятор уявляється як кортеж із збирача (builder) та шукача (searcher). Складність полягає у побудові оптимального збирача, який робить глобально оптимальне рішення досяжним. Оскільки єдиного універсального маршруту збірки для всіх моделей не існує, система має підтримувати налаштовувані маршрути. Це означає, що послідовність проходів компілятора, які перетворюють проміжні представлення на кінцеві виконувані файли, може варіюватися. Різні моделі можуть досягати найкращої продуктивності через різні послідовності трансформацій, навіть на одному й тому самому цільовому GPU.
Global Performance Tuner використовує ці налаштовувані маршрути збірки для автоматичного налаштування продуктивності. Для кожної кандидатури, згенерованої різними маршрутами, тюнер перевіряє вихідні дані на відповідність заданому критерію точності. Потім він вимірює загальну продуктивність інференсу для допустимих рішень. Серед усіх кандидатів, що відповідають вимогам до точності, система обирає ту, що має найменший час виконання. Такий підхід гарантує, що зростання продуктивності не досягається за рахунок втрати точності моделі. Розглядаючи процес компіляції як пошук серед багатьох можливих маршрутів збірки, а не як єдиний фіксований шлях, TensorRT 11.1 пропонує масштабований метод оптимізації завдань глибокого навчання для різноманітних моделей та апаратних конфігурацій.
Ця методологія усуває ключове обмеження попередніх підходів, де зміни для однієї моделі могли погіршити продуктивність для іншої. Зберігаючи базовий конвеєр стабільним, але роблячи рішення щодо планування налаштовуваними, система ефективно працює з новими моделями з невідомими перевагами. Вона пропонує різні варіанти оптимізації, відхиляє ті, що не проходять перевірку точності, і зберігає конфігурацію з найкращою продуктивністю. Це аналогічно шефу, який пропонує новому клієнту безкоштовні зразки, щоб знайти бажану комбінацію спецій, а не нав'язує один стандартний рецепт. Результатом стає більш стійкий процес компіляції, який адаптується до конкретних потреб кожної нейронної мережі, забезпечуючи розробникам максимально можливу швидкість інференсу без шкоди для необхідної точності їхніх застосунків.