NVIDIA Green Contexts: Явне розподілення ресурсів GPU для одночасних завдань
 Public
- 07 Oct, 2026
Сучасні GPU-додатки часто запускають кілька незалежних компонентів в межах одного процесу. Наприклад, оператори з високою чутливістю до затримок працюють поруч із фоновими ядрами, орієнтованими на пропускну здатність. Ці компоненти зазвичай ділять один GPU, що призводить до непередбачуваного взаємного впливу та конкуренції за ресурси. Традиційні контексти CUDA були створені для епохи, коли GPU обробляли один домінуючий тип навантаження. Через це вони стали громіздкими і погано підходять для тонкого розподілу ресурсів. Вони створюють значне навантаження на обладнання при перемиканні контекстів і не мають механізмів для явного визначення того, як обчислювальні ресурси розподіляються між одночасними завданнями.
Green contexts вирішують цю проблему, дозволяючи додаткам явно вибирати підмножину ресурсів виконання GPU та спрямовувати роботу безпосередньо на ці ресурси. Доступні в Driver API з версії CUDA 12.4, вони тепер доступні через Runtime API починаючи з CUDA 13.1. Ця функція дозволяє розробникам визначати, де виконується робота і як ресурси розподіляються всередині процесу. Основним сценарієм використання є розподіл SM, коли певні Streaming Multiprocessors призначаються green context. Це дозволяє кільком навантаженням працювати одночасно, не конкуруючи за ті самі обчислювальні блоки.
Окрім виділення SM, green contexts можуть виділяти ресурси черг завдань. У традиційній моделі незалежні потоки з упорядкованою роботою могли відображатися на ті самі базові черги завдань, спричиняючи небажану послідовну обробку, навіть якщо ресурсів виконання було достатньо. Явно виділяючи черги завдань, green contexts дозволяють додаткам задавати очікуваний рівень паралелізму та усувати хибні залежності. Створення та знищення цих контекстів потребує невеликих витрат, а їхній життєвий цикл не викликає неявної синхронізації незалежних GPU-операцій. Це забезпечує більш явну модель програмування, ніж покладатися на неявний стан пристрою.
Модель програмування зміщується від неявного до явного цільового призначення. Історично додатки використовували cudaSetDevice і створювали потоки, для яких ціль виконання виводилася з поточного стану пристрою, прив'язаного до потоку. З green contexts, представленими типом cudaExecutionContext_t, розробники створюють контекст для обраного набору ресурсів, а потім створюють із нього потоки за допомогою cudaExecutionCtxStreamCreate. Це гарантує, що робота, надіслана в ці потоки, сув'язана з ресурсами green context. Для додатків, орієнтованих на весь пристрій, традиційна модель залишається доступною через cudaDeviceGetExecutionCtx, що забезпечує зворотну сумісність та поступове впровадження.
Класичним прикладом використання є перекриття операцій зв'язку з ядрами GEMM у розподіленому навчанні або обробка операторів з високою чутливістю до затримок на AI-сенсорних платформах. Одного пріоритету потоків недостатньо, коли об'ємні ядра займають усі SM, оскільки планувальник не може перервати виконуючі блоки. Green contexts виділяють певні SM для критично важливої роботи, минаючи очікування завершення об'ємних блоків. Тестування на GPU NVIDIA Blackwell з 148 SM показало, що якщо пріоритет потоків забезпечує покращення в 27 разів порівняно з потоками однакового пріоритету, то green contexts забезпечують додаткове зниження затримки в 20 разів, гарантуючи виділені ресурси для критичного ядра.
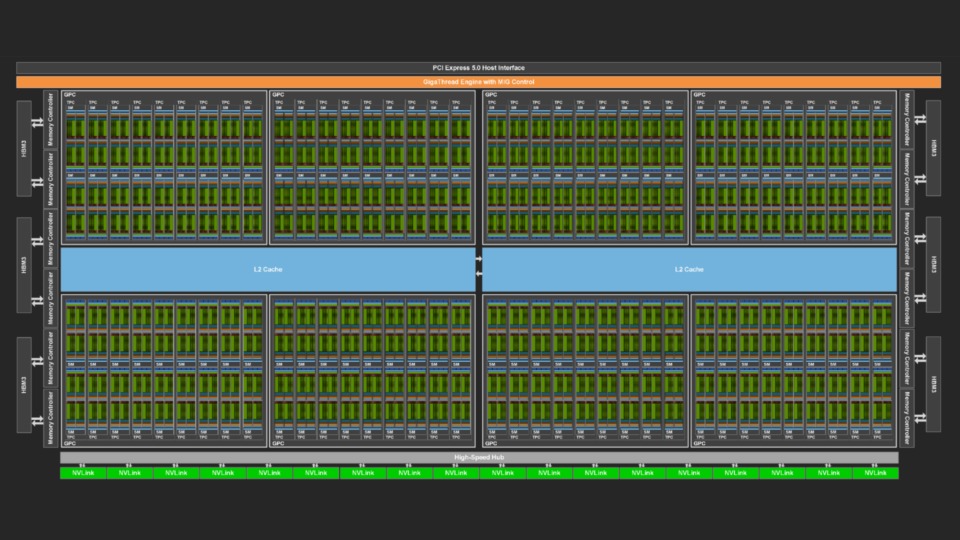
Реалізація включає запит ресурсів пристрою, розділення SM на групи критичних та решти, а також пакування кожної групи з конкретними конфігураціями черг завдань. Розробники використовують cudaDevSmResourceSplit для виділення ресурсів і cudaDevResourceGenerateDesc для створення дескрипторів. Green contexts вмикаються за бажанням і є доповненням, дозволяючи існуючим додаткам продовжувати використовувати весь пристрій, одночасно впроваджуючи більш тонкий контроль там, де це необхідно. Цей підхід особливо корисний для досягнення цільових показників паралелізму або затримки у складних робочих процесах, пропонуючи надійний механізм управління розподілом ресурсів GPU у сучасних багатокомпонентних додатках.