NVIDIA впроваджує ІІ-агентів для автоматизації роботи ІІ-фабрик та зменшення навантаження на SRE
 Public
- 05 Nov, 2026
Зі зростанням масштабів GPU-кластерів інженери з надійності сайтів (SRE) стикаються з труднощами при кореляції падінь продуктивності на рівнях обчислень, мережі та обладнання. NVIDIA розробила AI Factory Operations Agent, щоб оптимізувати внутрішню експлуатацію DGX SuperPOD та скоротити ручну працю. Система використовує спеціалізованих агентів, які виявляють збої, визначають їхні первинні причини та надають рекомендації через чат-інтерфейс. Інженери можуть спілкуватися з цими агентами природною мовою, перемикатися між розслідуваннями та відстежувати дії для аудиту, що позбавляє від необхідності вручну перевіряти численні дашборди.
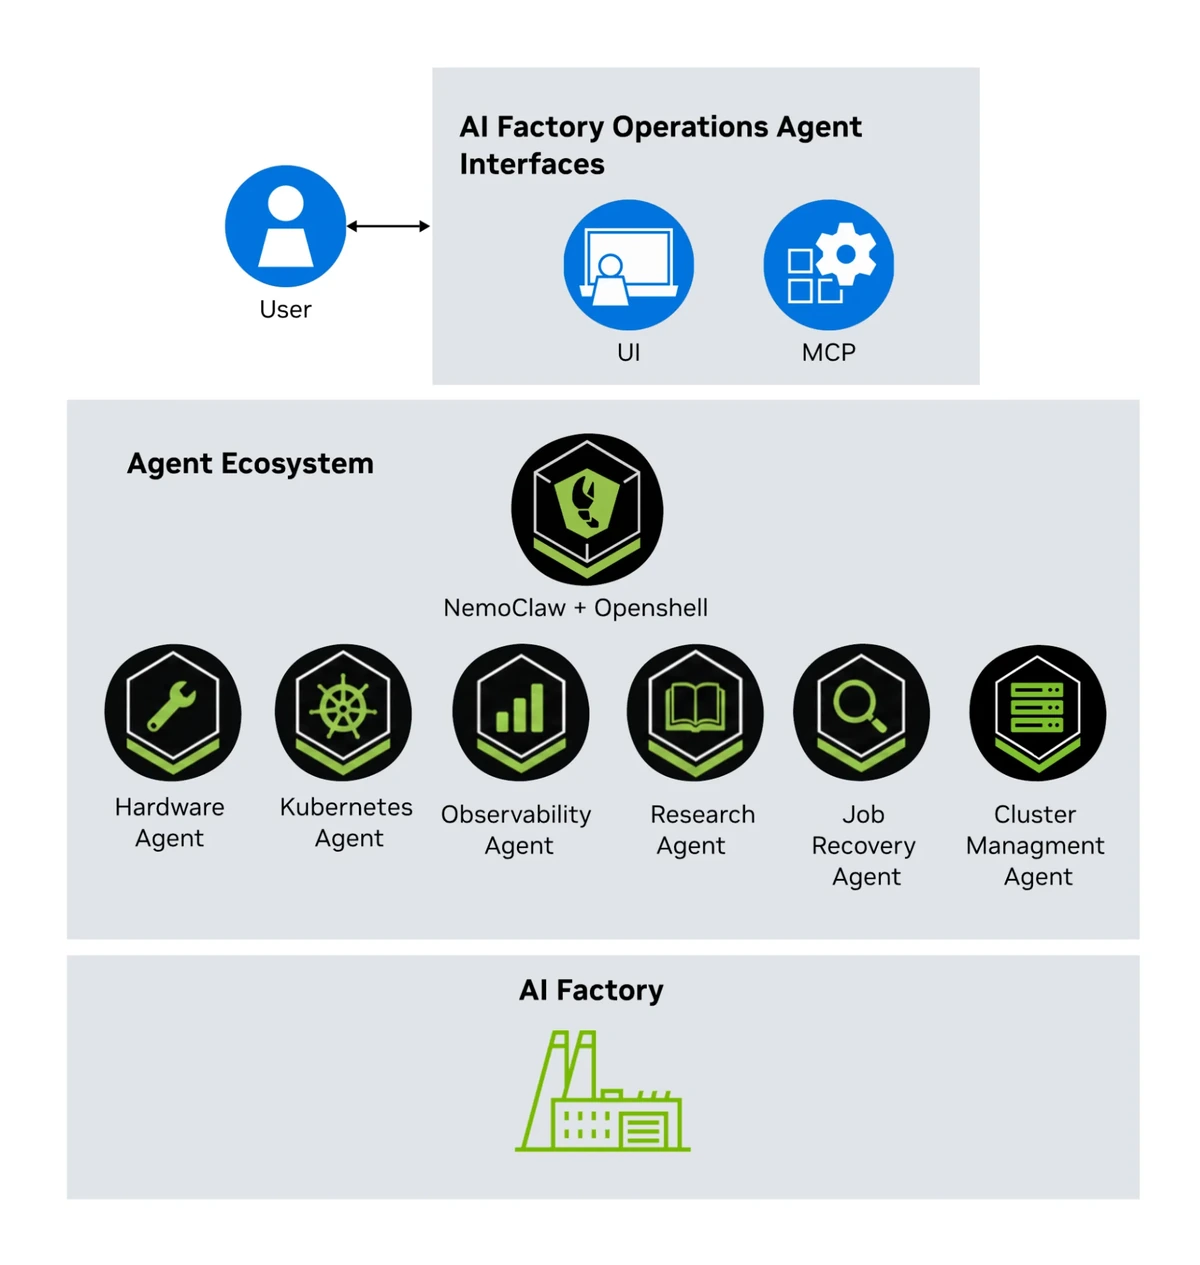
Приклад для розробників побудований на основі шаблону NVIDIA NemoClaw і включає агентський рантайм для користувача, який направляє запити до доменних агентів. З'єднання встановлюється через плагіни OpenClaw і сервери Model Context Protocol, які надають доступ до вузькоспеціалізованих операційних інструментів. Фреймворк використовує NVIDIA OpenShell і підтримує повністю локальне розгортання для забезпечення суверенітету даних. Інференс ґрунтується на локально обслуговуваних відкритих моделях NVIDIA Nemotron, які працюють у виробничих кластерах DGX H100, B200 і GB300. Така модульна архітектура дозволяє додавати нових агентів і інтеграції з інфраструктурою без зміни наявних компонентів.
Розгортання виконується як застосування Kubernetes control-plane, де Helm керує UI, шлюзом OpenClaw, серверами MCP і точками входу для інференсу. Для виконання команд в оболонці OpenShell створює ізольовані пісочниці Kubernetes для кожної сесії, відокремлюючи команди від основного пода шлюза і гарантуючи, що рантайм не змінює виробничі навантаження. Безпека забезпечується багаторівневим контролем доступу. Серверний інструмент run_kubectl використовує зафіксовані бінарні файли і облікові дані лише для читання, а RBAC Kubernetes визначає доступні для перегляду ресурси. Така конфігурація дозволяє агентам перевіряти свої права, наприклад, підтверджуючи можливість отримання списку подів, але не секретів або створення нових подів.
Внутрішнє розгортання використовує набір доменних агентів. Job Recovery Agent аналізує збої навчання на рівнях планувальника та обладнання. Hardware Agent діагностує несправності на рівні пристроїв, такі як помилки PCIe та теплові аномалії. Observability Agent запитує дані з Prometheus і Grafana Loki для генерації динамічних дашбордів. Research Agent шукає інформацію в попередньо завантаженої документації, а Kubernetes Agent надає доступ до стану кластера лише для читання. Cluster Management Agent взаємодіє з API Base Command Manager. Крос-доменні інструменти включають веб-пошук і виконання коду, а фреймворк підтримує кастомні сервери MCP для специфічних операційних задач.
NVIDIA рекомендує виділений GPU-прискорений control-plane, ізольований від виробничого кластера, для обробки оркестрації агентів без споживання ресурсів, необхідних для навчання. У середовищах із багатьма орендарями OpenShell забезпечує межі, запускаючи агентів в ізольованих пісочницях з обмеженнями на рівні ядра, що гарантує доступ SRE орендарів лише до їхніх конкретних просторів імен і вузлів. Фреймворк доступний як експериментальне програмне забезпечення з відкритим вихідним кодом на GitHub, хоча API і конфігурації можуть змінюватися між релізами. Клієнти NVIDIA можуть зв'язатися з менеджерами по роботі з клієнтами, щоб запросити доступ до пропрієтарних агентів управління кластером, розроблених для внутрішнього використання.