Daviator прискорює VASP на GPU NVIDIA: пакетний розрахунок k-точок і змішана точність
 Public
- 18 Nov, 2026
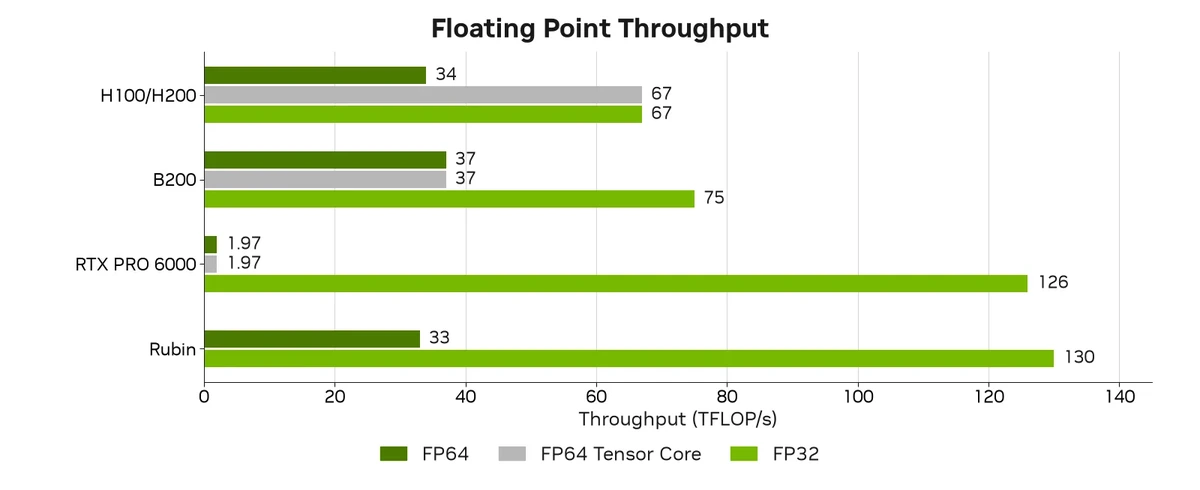
Щоб навчити машинно-навчені міжатомні потенціали (MLIP), потрібні десятки й сотні мільйонів DFT-розрахунків енергій, сил і напружень. Найчастіше їх отримують у VASP - основному коді DFT на плоских хвилях. У таких задачах зазвичай беруть невеликі елементарні комірки та щільні сітки k-точок, і GPU при цьому простоюють. Порт VASP на OpenACC обробляє k-точки по черзі, тому для малих систем на кожному кроці запускаються сотні крихітних ядер, і накладні витрати на запуск з'їдають увесь час. Система з одного атома заліза з 752 k-точками рахувалася на GPU у 8 разів повільніше, ніж на CPU, і дослідникам доводилося вручну розподіляти задачі за розміром. До того ж FP64 тупцює на місці: продуктивність у FP64 у Hopper, Blackwell і Rubin не зростає, а FP32 продовжує додавати. У RTX PRO 6000 співвідношення FP32:FP64 і зовсім 64:1.
Daviator - бібліотека GPU-ядер від NVIDIA, яка замінює цикли за k-точками пакетними операціями. В її основі лежить пакетний розв'язувач Девідсона на пакетних FFT, GEMM і власних ядрах. Запусків стає менше, завантаження SM наближається до насичення, а дані не залишають пам'ять GPU. За VASP залишаються цикл SCF, змішування, симетрія та введення-виведення, а Daviator підключається в чітко визначених точках виклику. Вмикається він через мікросервіс NVIDIA ALCHEMI VASP параметром LDAVIATOR=True в INCAR і перехоплює розв'язувач Девідсона (ALGO = Normal). Змінювати наявні вхідні файли не потрібно. У прикладі взято один атом Fe з ISPIN = 2, NBANDS = 12, PREC = Accurate і сіткою 30x30x30 з центром у Гамма-точці.
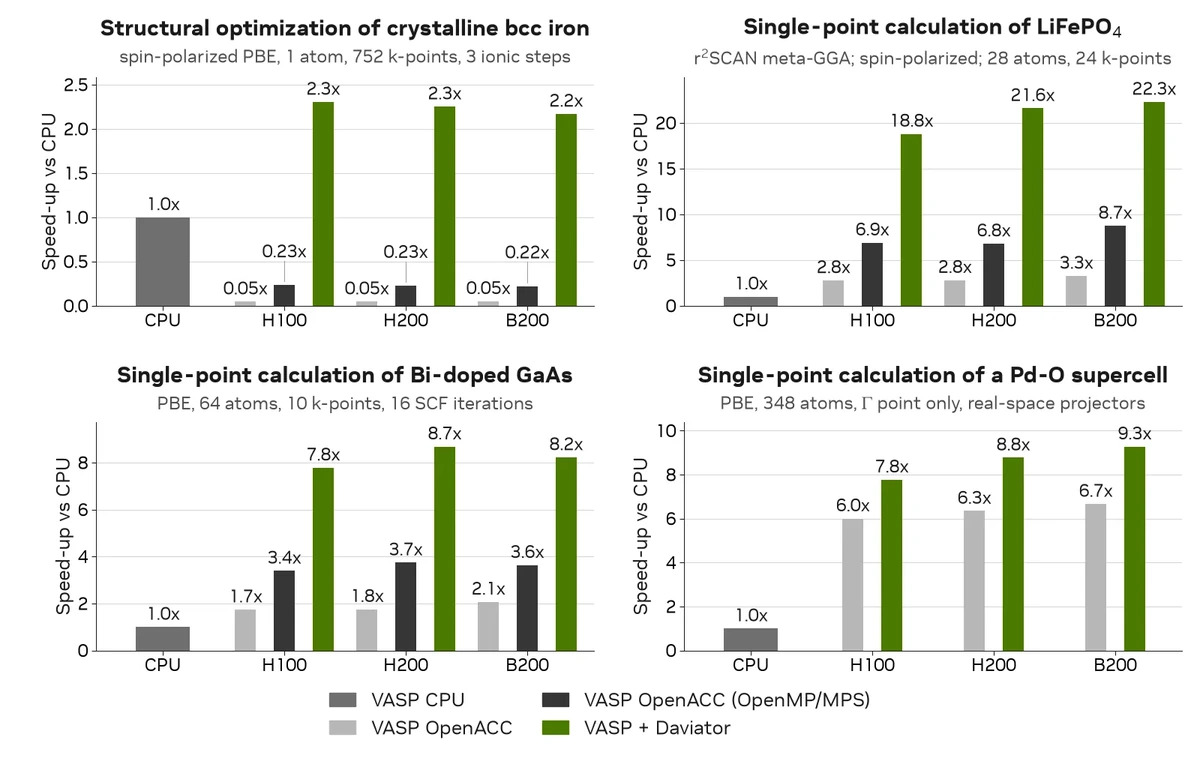
Частина ядер спеціалізована під розмір пакета й може компілюватися під час першого використання. Тому в скриптах завдань варто спрямувати CUDA_CACHE_PATH на швидке сховище, наприклад /tmp/cudacache, а не в $HOME, і встановити CUDA_CACHE_DISABLE=0. Розрахунки запускаються як зазвичай, наприклад mpirun -np 1 vasp_std. Поки що підтримується лише один вузол; багатовузловий режим, vasp_ncl і vasp_gam у планах. Для порівняння взяли VASP 6.6.0 на CPU і з OpenACC на H100/H200 та B200. Один атом заліза розраховується більш ніж у 2 рази швидше, ніж на CPU. LiFePO4 з r2SCAN прискорює розв'язувач Девідсона у 22 рази, а GaAs з домішкою Bi з 64 атомів витрачає на розрахунок понад на 85% менше часу. Навіть система з 348 атомів з однією k-точкою розраховується швидше, тож сортувати завдання за розміром більше не потрібно. За оцінками для наборів даних час до результату скорочується до 22 разів, а вартість - до 75% порівняно з CPU.
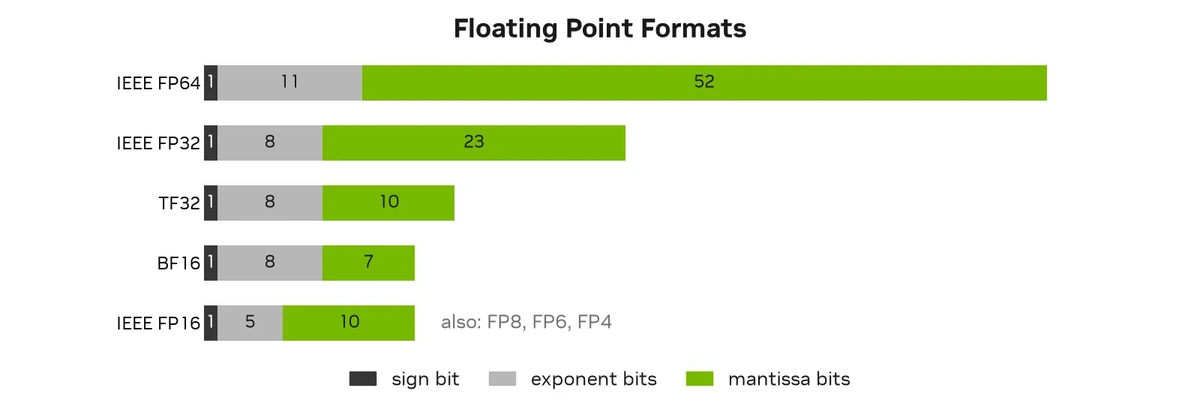
Пакетний Daviator і далі рахує у FP64, а створити розв'язувач Девідсона зі змішаною точністю непросто. Якщо перевести ядра на FP32 і порівняти результат із FP64, дізнаєшся лише «пройшло» чи «не пройшло». Водночас приховані збої - дрейф енергії, збіжність не туди, розбіжні траєкторії МД - можуть виглядати цілком правдоподібно. Тому використовується узагальнений тип із плаваючою комою, у якого налаштовується кількість біт мантиси та порядку. З його допомогою для кожного ядра знаходять мінімально необхідну точність і вирішують: перевести його на FP32, переписати чи залишити «островом» FP64. Результати залежать від вхідних даних і порогу. Інструментувати потрібно, зокрема, залежності та математичні функції, а повільні інструментовані прогони можна розпаралелити на ресурсах HPC. Починають із перетворень FP64↔FP32 навколо гарячого шляху та ядер із налаштовуваним типом, а потім від ітерації до ітерації звужують області FP64.
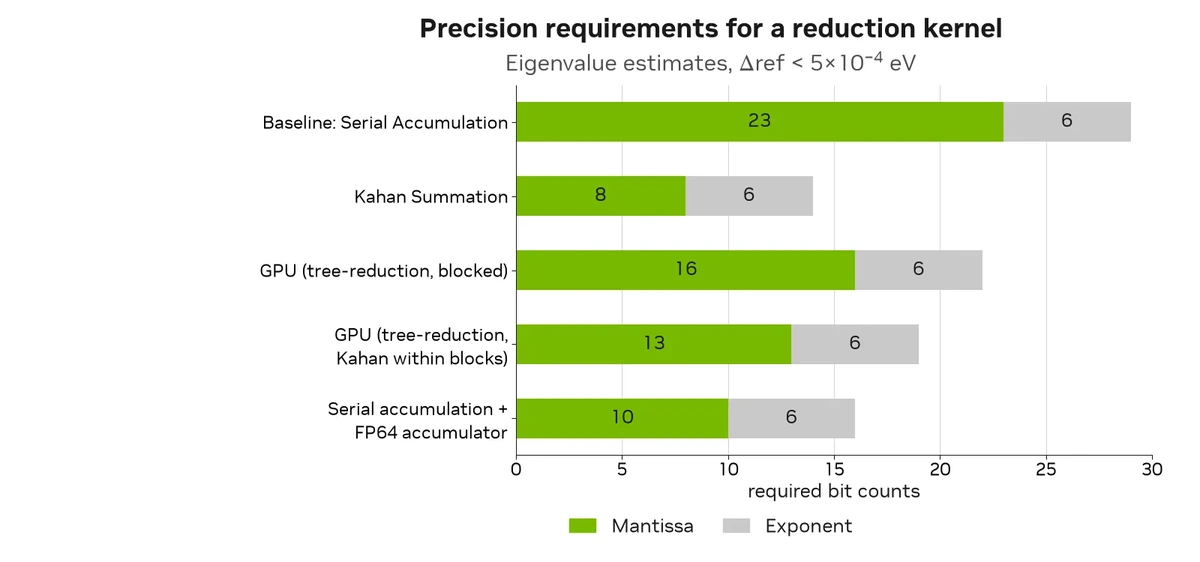
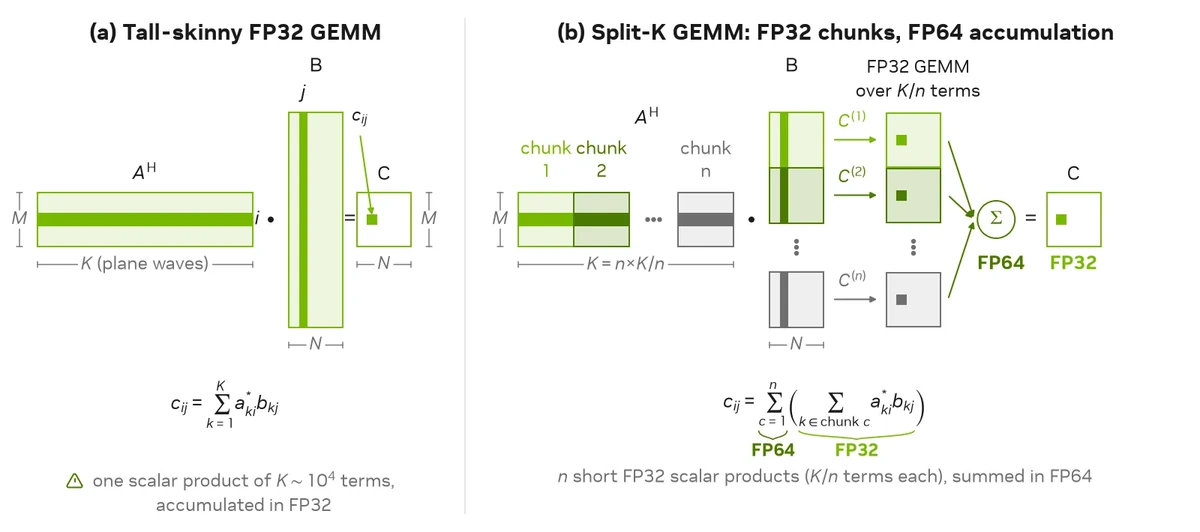
Аналіз на основі Verificarlo показав, що FFT, застосування гамільтоніана та оновлення орбіталей можна перевести в FP32. Задача на власні значення в підпросторі, енергії, критерії збіжності та вузькі високі GEMM, з яких будуються матриці підпростору, залишилися в FP64. Ці GEMM методу Релея - Ріца живлять чутливий розв'язувач власних значень, тому застосовується алгоритм split-k: скалярні добутки обчислюються блоками в FP32, а підсумкове накопичення виконується в FP64. Поріг EDIFF у VASP за замовчуванням дорівнює 10-4 еВ і може знижуватися до 10-6 еВ і нижче, тоді як FP32 дає близько 7 значущих цифр. Змішаний розв'язувач збігається до 10-4-10-6 еВ залежно від вхідних даних, а нижче рівня шуму FP32 розрахунок продовжується в FP64. На GaAsBi-64 FP32 дає прискорення у 2 рази при EDIFF = 10-5 еВ, а зв'язка FP32→FP64 при 10-8 еВ працює в 1,5 раза швидше за чистий FP64.
На H100 і H200, де тензорні ядра FP64 не поступаються FP32 за продуктивністю, виграш невеликий. А на RTX PRO 6000 розв'язувач Девідсона в FP32 працює у 3-7 разів швидше, весь розрахунок - приблизно у 2 рази. Змішана точність вмикається параметром LDAVIATOR_MIXED_PRECISION (0 означає FP64). Кожен іонний крок починається зі зберігання даних у FP32, доки не буде досягнуто DAVIATOR_EDIFF_FP32 або DAVIATOR_SWITCH_TO_FP64_AFTER_STEP; для більшості вхідних даних підходить 10-4-10-5. У прикладі задано EDIFF = 5e-07, LDAVIATOR = True, LDAVIATOR_MIXED_PRECISION = True, DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2 і DAVIATOR_EDIFF_FP32 = 5e-05. Потрібна ліцензія VASP, а Daviator зі змішаною точністю працюватиме на будь-якому GPU NVIDIA через мікросервіс ALCHEMI VASP.