Прискорення завантаження даних у GPU за допомогою NVIDIA KvikIO та GPUDirect Storage
 Public
- 22 Oct, 2026
NVIDIA Magnum IO GPUDirect Storage (GDS) вирішує проблему вузького місця при переміщенні великих наборів даних з накопичувача на прискорювачі, забезпечуючи прямий шлях передачі, який обходить проміжне зберігання в пам'яті CPU. З експоненційним зростанням моделей ШІ та навчальних датасетів ефективне переміщення даних стає критично важливим для забезпечення завантаженості GPU. Хоча основним інтерфейсом GDS є C API cuFile, Python залишається домінуючою мовою в сучасній розробці ШІ. NVIDIA KvikIO закриває цю прогалину, надаючи високоурівневі, ідіоматичні інтерфейси на Python та C++ для високопродуктивного введення-виведення файлів. Бібліотека працює поверх cuFile, пропонуючи додаткові можливості керування виконанням запитів введення-виведення, що дозволяє розробникам керувати шляхом передачі даних без переходу на низькорівневий C-код.
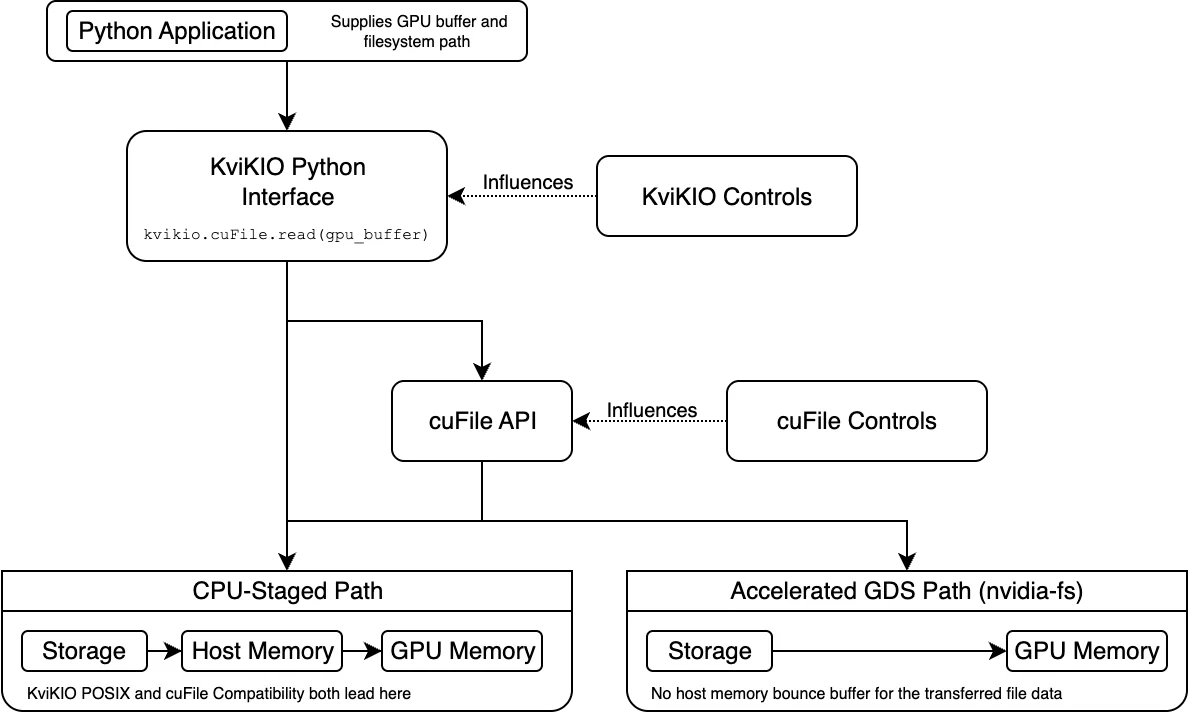
Архітектура передбачає два окреміші етапи прийняття рішень щодо вибору шляху передачі даних. По-перше, KvikIO визначає, надсилати запит через cuFile чи використовувати власний шлях сумісності POSIX, який використовує пам'ять хоста як проміжне ланцюжкове з'єднання. На цей вибір впливає налаштування compat_mode, яке може приймати значення AUTO, ON або OFF. У режимі AUTO KvikIO намагається використовувати cuFile, але переходить на POSIX, якщо він недоступний. По-друге, коли cuFile отримує запит, він вирішує, використовувати прискорений шлях GDS чи власний шлях сумісності з проміжним зберіганням у CPU, виходячи з підтримки системою та конфігурації. Таким чином, звернення до API cuFile підтверджує лише вибір KvikIO, але не гарантує використання прискореного шляху GDS. Розробникам необхідно перевіряти кінцевий шлях, щоб забезпечити оптимальну продуктивність.
Для початку налаштуйте середовище Python та встановіть збірку KvikIO для CUDA 13 за допомогою команди pip install kvikio-cu13, яка включає CuPy як залежність. Перед виконанням операцій введення-виведення перевірте активну конфігурацію за допомогою API за замовчуванням KvikIO. Ключові налаштування включають compat_mode, який повідомляє про активний режим, та gds_threshold - мінімальний розмір запиту, що надсилається в cuFile. На тестовій системі поріг становить 16 КіБ, що означає, що менші читання виконуються напряму через шлях POSIX KvikIO. Ці налаштування можна контролювати за допомогою змінних середовища, таких як KVIKIO_COMPAT_MODE та KVIKIO_GDS_THRESHOLD. Крім того, скрипт gdscheck.py можна використовувати для перевірки встановлених компонентів GDS, підтримуваних файлових систем та активної конфігурації cuFile на платформі.
Щоб прочитати дані в пам'ять GPU, виділіть масив CuPy відповідного розміру та використовуйте контекстний менеджер kvikio.CuFile для виконання читання. Наприклад, для читання файлу розміром 1 ГіБ необхідно створити буфер CuPy розміром 1 ГіБ і передати його в метод read. Щоб перевірити шлях передачі даних, увімкніть статистику виконання cuFile, встановивши змінну середовища CUFILE_STATS_LEVEL=3 і запустивши скрипт в інтерактивному режимі. Потім використовуйте gds_stats для перегляду лічильників. У виведенні для кожного GPU лічильник nvfs відстежує операції, що використовують модуль ядра nvidia-fs (прискорений шлях), а posix - операції, що використовують шлях сумісності. За налаштуваннями за замовчуванням читання 1 ГіБ розбивається на 256 операцій по 4 МіБ кожна, усі з яких показують nvfs=256 та posix=0, що підтверджує використання прискореного шляху.
Додатковий контроль можливий шляхом незалежного зміни налаштувань KvikIO та cuFile. Встановлення KVIKIO_COMPAT_MODE=off змушує KvikIO використовувати cuFile, а CUFILE_FORCE_COMPAT_MODE=true змушує cuFile використовувати його шлях сумісності, що призводить до появи лічильників posix у статистиці. Навпаки, KVIKIO_COMPAT_MODE=on повністю обходить cuFile, використовуючи backend KvikIO з проміжним зберіганням у CPU. Окрім вибору шляху, параметри виконання у файлі cufile.json керують обробкою запитів. KvikIO розбиває великі операції на завдання на основі KVIKIO_TASK_SIZE, які потім надсилаються в cuFile. cuFile може додатково ділити ці запити на основі свого внутрішнього пулу потоків та min_io_threshold_size_kb. Наприклад, запит на 1 ГіБ з розміром завдання 4 МіБ призводить до 256 окремих запитів cuFile, кожен з яких обробляється як єдине ціле.
Якщо KvikIO надсилає в cuFile один великий запит (наприклад, 1 ГіБ), cuFile може розбити його на менші частини для паралельної обробки, обмеженої кількістю робочих потоків та max_request_parallelism. У конфігурації з чотирма робочими потоками запит на 1 ГіБ розбивається на чотири частини по 256 МіБ. Оскільки цільовий буфер не зареєстрований для DMA-передачі з накопичувача, cuFile використовує зареєстрований проміжний буфер GPU, копіюючи дані шарами не більше 16 МіБ. Параметр min_io_threshold_size_kb впливає на планування запитів; наприклад, запит на 16 МіБ може бути розбитий на дві частини по 8 МіБ, щоб відповідати порогу. KvikIO є частиною бібліотек CUDA-X і використовувалася в cuDF, cuCIM та cuPhoton для прискорення завантаження даних у форматах Parquet, ORC та наукових зображень. Розуміння цих рівнів дозволяє розробникам налаштовувати продуктивність введення-виведення під конкретні робочі навантаження.