NVIDIA TensorRT 11.1: globalni tuner performanse za automatsku optimizaciju engineova uz uzimanje u obzir točnosti
 Public
- 24 Oct, 2026
Raspoređivanje neuronskih mreža suštinski je problem kompilacije, gdje ne postoji jedina optimalna strategija za sve modele. Kada NVIDIA TensorRT izgradi engine za inferenciju, donosi međusobno povezane odluke o transformacijama grafa, spajanju jezgri, rasporedu memorije i kvantizaciji. Ovaj proces, poznat kao planiranje, značajno utječe na konačnu performancu inferencije. Različite odluke o planiranju mogu sačuvati semantiku modela, a da pritom daju vrlo različite rezultate po pitanju brzine. Budući da su ti efekti povezani i ovise o modelu, često postaju vidljivi tek nakon što se engine u potpunosti izgradi i izmjeri, što predviđanje najbolje strategije čini sve težim kako se modeli i okruženja za raspoređivanje diversificiraju.
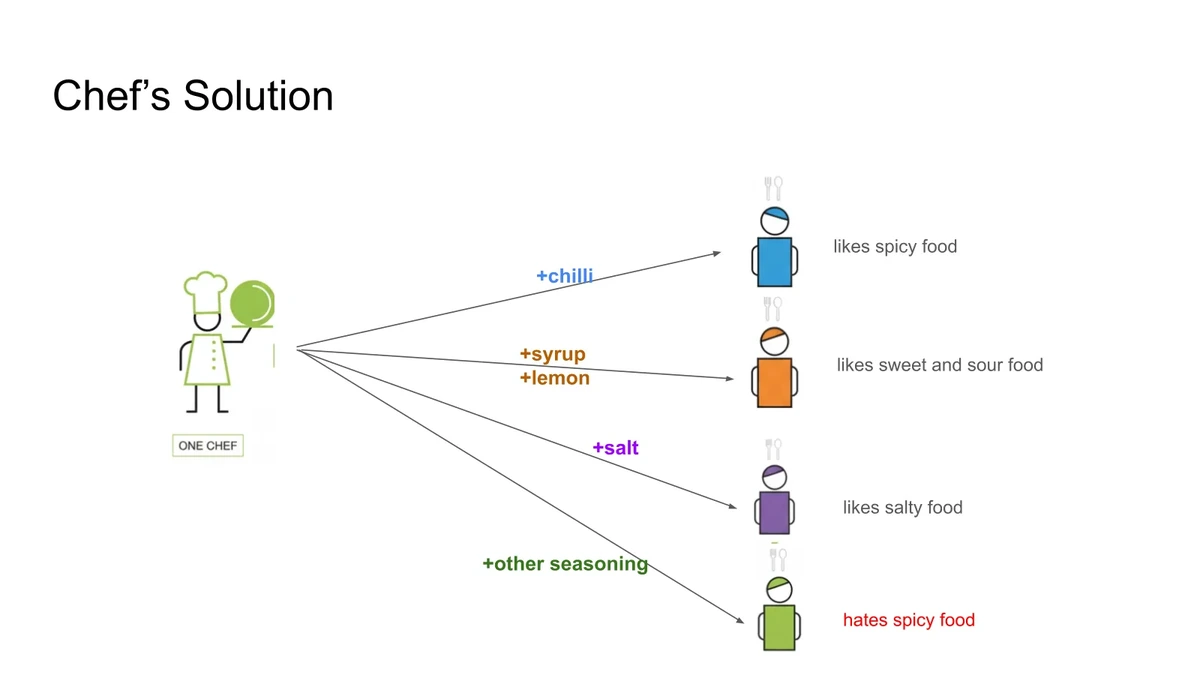
Povijesno, TensorRT je oslanjao na interne modele ključnih pokazatelja uspješnosti (KPI) za prepoznavanje optimizirajućih obrazaca, koji su zatim kodirani kao heuristike u zadanoj strategiji raspoređivanja. Iako je to omogućilo korisnicima da automatski koriste stručno znanje, stvorio je problem skalabilnosti. Heuristika dizajnirana za jedan tip modela mogla je uzrokovati pad performansi na drugom, što je zahtijevalo dodatne iznimke. To je činilo logiku raspoređivanja složenom i teškom za proširenje. Global Performance Tuner, objavljen u TensorRT 11.1, rješava to odustajanjem od jedne fiksne recepture. Umjesto toga, tretira kompilacijski pipeline kao osnovni recept s prilagodljivim začinskim sredstvima, omogućujući sustavu da prilagodi put optimizacije specifičnim karakteristikama ulaznog modela, bilo da je u pitanju ONNX graf ili mreža kreirana putem TensorRT API-ja.
Da bi se formalizirao ovaj pristup, sustav koristi matematički okvir koji razdvaja generiranje kandidateskih rješenja od njihovog odabira. Prostor modela sastoji se od svih mogućih ulaznih podataka, dok prostor rješenja sadrži sva izvršiva izlazna stanja, poput TensorRT engineova ili serializiranih nizova GPU jezgri. Algoritam za izgradnju (builder) preslikava model u skup kandidateskih rješenja, ograničen pragom tolerancije točnosti. Ovaj prag osigurava da parovi ulaz-izlaz ostanu u prihvatljivim granicama, sprječavajući agresivne optimizacije koje krše zahtjeve aplikacije. Cilj algoritma za izgradnju je generirati bogat skup kandidata koji uključuje optimalno rješenje, definirano kao najbrže izvedivo izvršavanje koje zadovoljava kriterije točnosti. Ova apstrakcija omogućuje strogu analizu kako različiti putovi izgradnje utječu na konačno vrijeme izvršavanja.
Zatim algoritam za pretraživanje radi na ovom skupu kandidata kako bi odabrao najbolje rješenje. U idealnom slučaju, ovaj algoritam bi trebao provesti iscrpnu evaluaciju svakog kandidata kako bi pronašao onaj s minimalnim vremenom izvršavanja. Međutim, u praksi, proračuni vremena za izgradnju često ograničavaju dubinu tog pretraživanja. Dakle, cijeli kompilator predstavlja se kao uređeni par (tuple) izgraditelja (builder) i pretraživača (searcher). Izazov leži u izgradnji optimalnog izgraditelja koji čini globalno optimalno rješenje dostižnim. Budući da ne postoji jedan univerzalni put izgradnje koji funkcionira za sve modele, sustav mora podržavati prilagodljive putove izgradnje. To znači da se niz kompilacijskih prolaza, koji pretvaraju međupredstave u konačne izvršne datoteke, može razlikovati. Različiti modeli mogu postići najbolje performanse kroz različite nizove transformacija, čak i na istom ciljanom GPU-u.
Global Performance Tuner koristi ove prilagodljive rute izgradnje za automatsko podešavanje performansi. Za svakog kandidata generiranog različitim rutama, tuner provjerava izlaze prema zadanoj kriteriju točnosti. Zatim mjeri ukupne performanse inferencije za izvedive rješenja. Među svim kandidatima koji zadovoljavaju zahtjeve za točnošću, sustav odabire onaj s najmanjim vremenom izvršavanja. Ovaj pristup osigurava da poboljšanja performansi ne dolaze na štetu vjernosti modela. Razmatrajući proces kompilacije kao pretragu kroz više mogućih ruta izgradnje, a ne kao jedan fiksni put, TensorRT 11.1 pruža skalabilan metod za optimizaciju radnih opterećenja dubokog učenja kroz raznolike modele i hardverske konfiguracije.
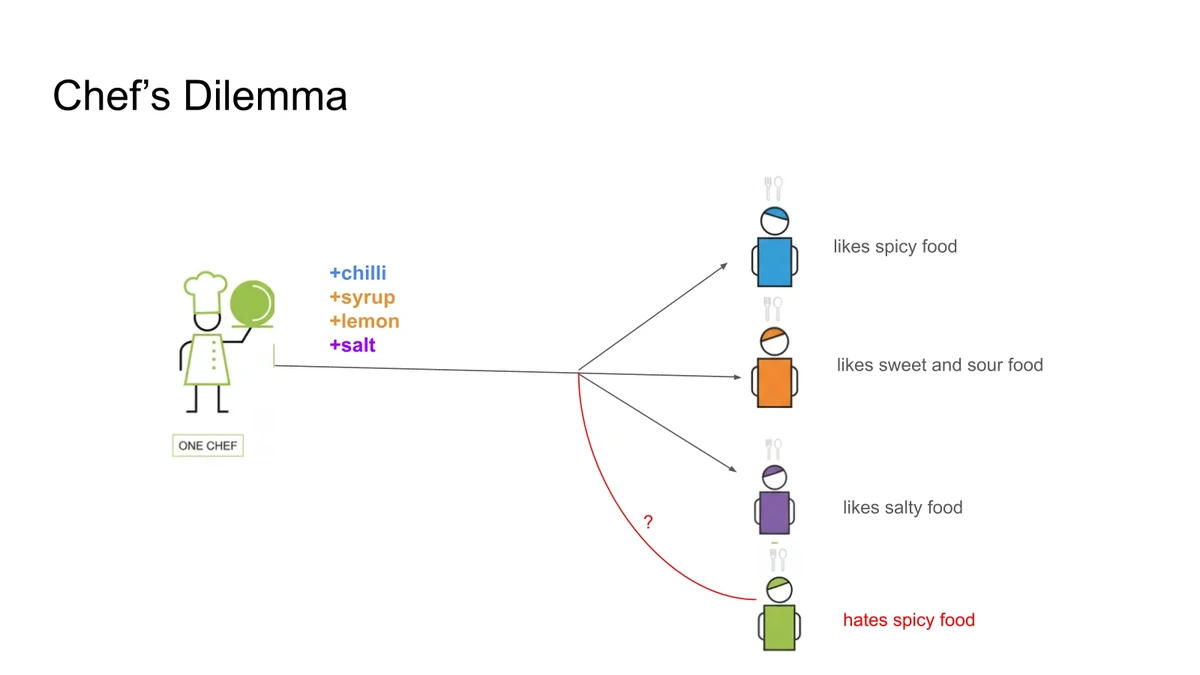
Ova metodologija rješava ključno ograničenje prethodnih pristupa, gdje promjena za jedan model mogla je pogoršati performanse za drugi. Držeći osnovnu cijev stabilnom, ali čineći odluke o raspoređivanju prilagodljivima, sustav učinkovito obrađuje nove modele s nepoznatim preferencijama. Nudi različite varijante optimizacije, odbija one koje ne prolaze provjere točnosti i zadržava konfiguraciju s najboljim performansama. Ovo je analogno šefu kuharu koji nudi novom klijentu besplatne uzorke kako bi pronašao preferiranu kombinaciju začina, umjesto da nameće jedan standardni recept. Rezultat je robusniji proces kompilacije koji se prilagođava specifičnim potrebama svake neuronske mreže, osiguravajući razvojnicima najvišu moguću brzinu inferencije bez kompromisa u traženoj preciznosti njihovih aplikacija.