Optimisation de l'inférence IA par co-conception de la mémoire à tous les niveaux de la pile
 Public
- 06 Nov, 2026
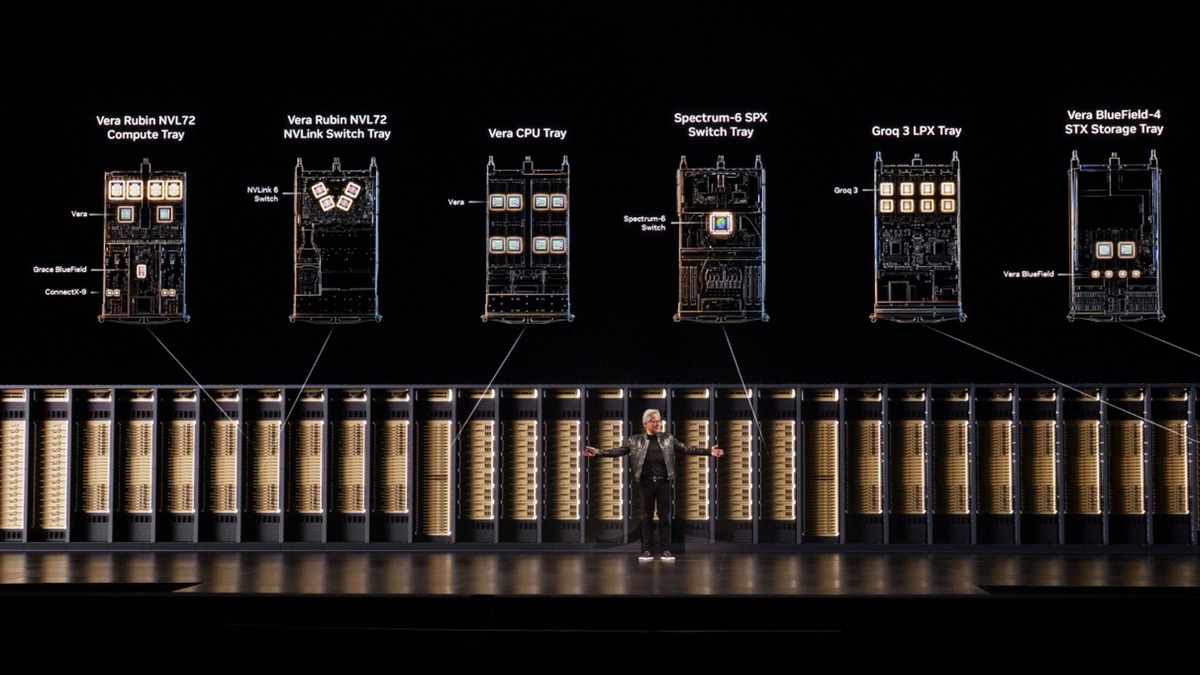
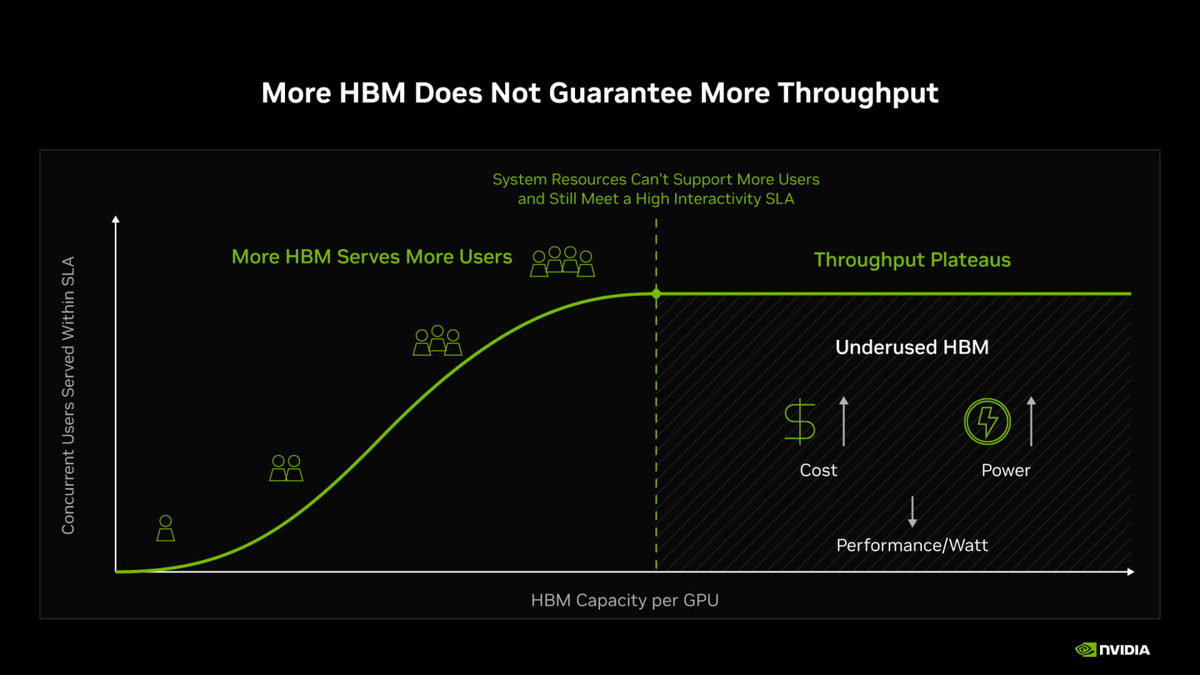
L'expansion rapide des grands modèles de langage, l'élargissement des fenêtres de contexte et la croissance des applications agentiques exercent une pression de plus en plus forte sur les ressources de mémoire GPU. Face à la raréfaction de l'offre et à la hausse des prix, le secteur fait face à un défi critique : comment traiter davantage de données sans simplement ajouter du matériel coûteux. NVIDIA s'attaque à ce problème en s'éloignant de l'approche traditionnelle consistant à intégrer davantage de mémoire à large bande passante (HBM) sur les puces. Au lieu de cela, l'entreprise adopte une stratégie de co-conception complète de la pile (full-stack codesign), où les GPU, CPU, le réseau, le stockage et le logiciel sont conçus en tandem. Cette approche holistique vise à extraire un travail utile maximal de chaque octet de mémoire dans l'ensemble de l'infrastructure de l'usine IA, plutôt que de compter uniquement sur l'augmentation de la capacité brute.
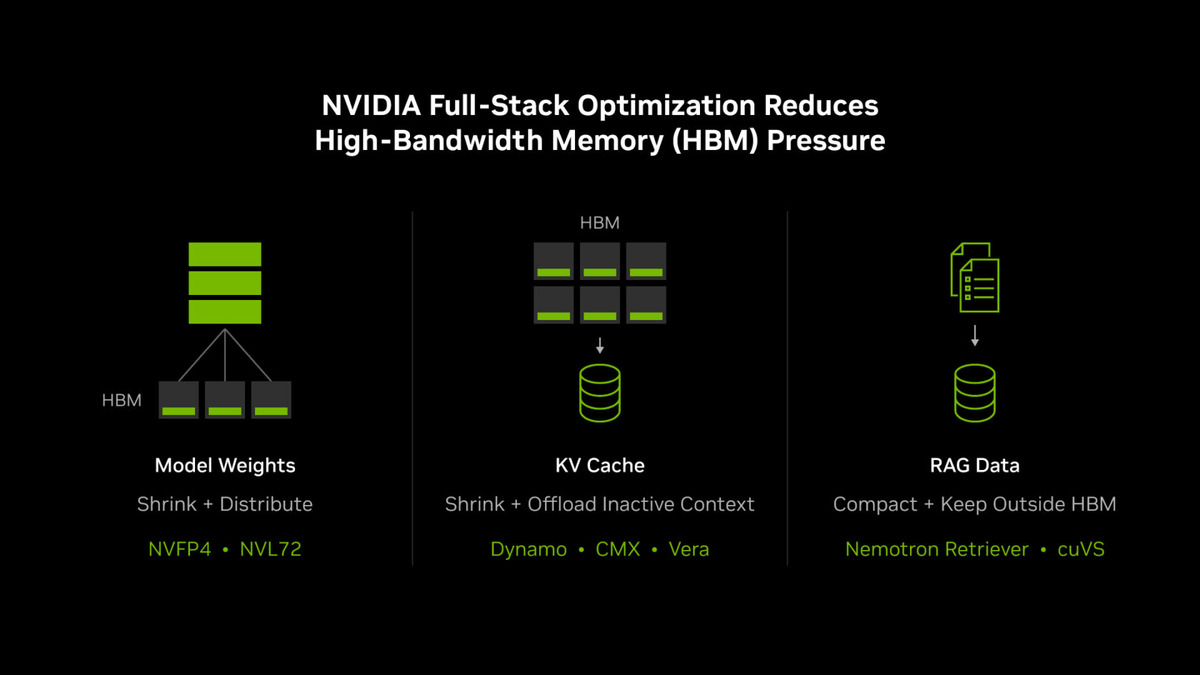
Le cœur de cette stratégie réside dans la gestion efficace de la hiérarchie de la mémoire et du stockage. Dans une usine IA, la HBM constitue le niveau le plus rapide, mais aussi le plus coûteux et le plus disputé, stockant des données critiques telles que les poids des modèles et le cache Key-Value (KV). Sous ce niveau se trouvent la mémoire CPU, les SSD locaux et le stockage partagé, qui offrent une plus grande capacité à moindre coût, mais avec une vitesse réduite. L'efficacité du système dépend de la manière dont les données sont placées et déplacées entre ces niveaux. En réduisant l'empreinte des poids des modèles, en déplaçant les contextes de cache KV inactifs vers un stockage moins coûteux et en compactant les embeddings de la génération augmentée par récupération (RAG), NVIDIA s'assure que l'espace HBM limité est réservé aux opérations actives de haute priorité. Cela prévient le phénomène de « mur de mémoire », où les unités de calcul attendent les données car la bande passante est saturée, maintenant ainsi une faible latence pour les utilisateurs simultanés.
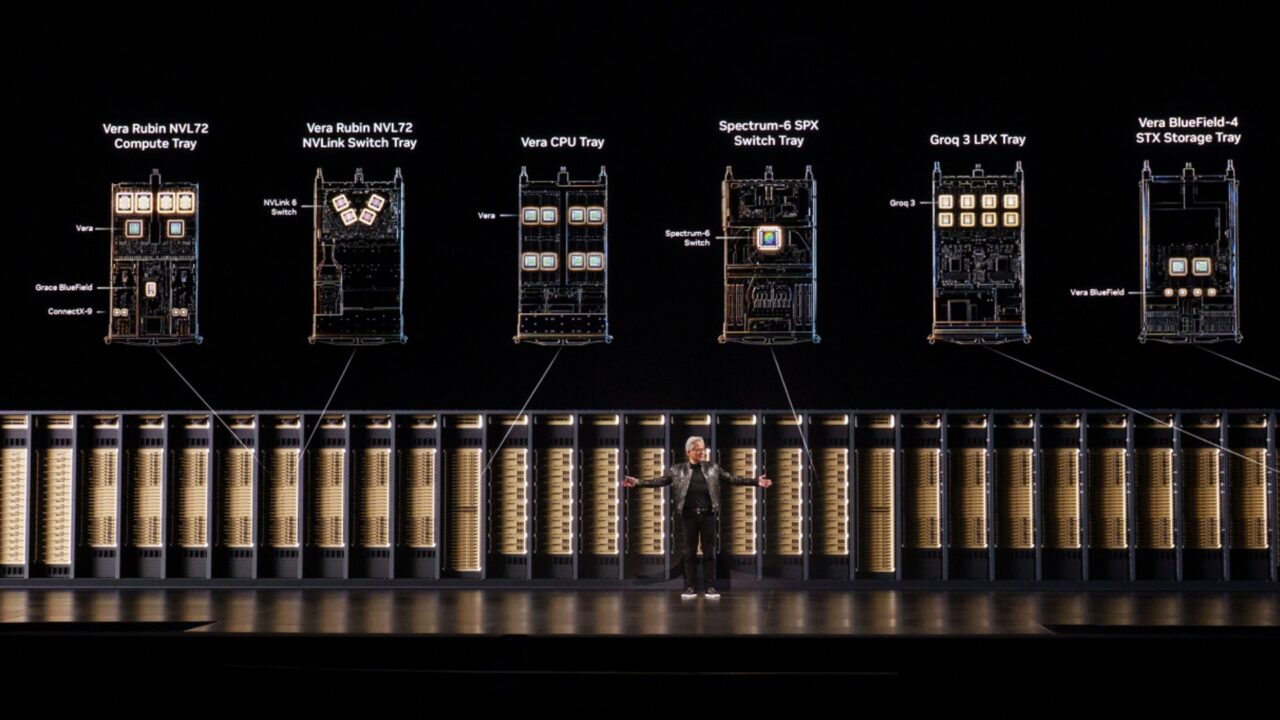
L'impact de cette approche de co-conception est clairement visible dans les dernières métriques de performance des plateformes. De la génération Blackwell Ultra à la future plateforme Vera Rubin, la capacité HBM par GPU n'a augmenté que d'environ 3 %. Cependant, les gains d'efficacité sont considérables. Sur le benchmark SemiAnalysis AgentX, le débit par dollar pour les tâches agentiques a augmenté jusqu'à 30 fois. Plus précisément, le NVIDIA GB300 NVL72 offre un débit par dollar jusqu'à 10 fois supérieur à celui de la plateforme H200 à 100 jetons par seconde par utilisateur, malgré un doublement de la capacité HBM. Le Vera Rubin NVL72 devrait offrir un débit par dollar jusqu'à 30 fois supérieur à celui du GB300 NVL72 à 125 jetons par seconde par utilisateur, avec une augmentation de la capacité HBM de seulement 3 %. Cela démontre que l'optimisation du flux de données et du placement dans le stockage génère des retours bien plus importants qu'une simple expansion de la capacité mémoire.
Pour les opérateurs de fabriques d'IA, la métrique principale est le nombre de jetons utiles livrés dans le cadre d'un budget énergétique spécifique, tout en respectant des exigences strictes en matière de temps de réponse. L'augmentation du nombre de jetons par seconde par watt se traduit directement par une hausse du chiffre d'affaires à partir de la même infrastructure énergétique et par une réduction du coût par jeton. En allégeant la pression sur le HBM liée aux poids des modèles, au contexte inactif et aux données RAG, la co-conception complète garantit que les ressources mémoire sont utilisées pour l'inférence active plutôt que pour le stockage passif. Cette méthode permet aux systèmes de traiter des milliers de milliards de paramètres et des trajectoires agentiques complexes, pouvant impliquer le traitement de jusqu'à 3 millions de jetons, sans être limités par la bande passante mémoire. Le résultat est une infrastructure plus évolutive et plus rentable, capable de soutenir la prochaine génération d'applications d'IA.