NVIDIA TensorRT 11.1 : le Global Performance Tuner pour l'optimisation automatique des moteurs en tenant compte de la précision
 Public
- 24 Oct, 2026
Le déploiement des réseaux de neurones est fondamentalement un défi de compilation, où aucune stratégie optimale unique n'existe pour tous les modèles. Lorsque NVIDIA TensorRT construit un moteur d'inférence, il prend des décisions interdépendantes concernant les transformations de graphe, la fusion de noyaux, le placement mémoire et la quantification. Ce processus, connu sous le nom de planification (scheduling), a un impact significatif sur les performances finales d'inférence. Différents choix de planification peuvent préserver la sémantique du modèle tout en produisant des résultats de vitesse très différents. Étant donné que ces effets sont couplés et dépendent du modèle, ils ne deviennent souvent apparents qu'après la construction et la mesure complètes du moteur. Cela rend la prédiction de la meilleure stratégie de plus en plus difficile à mesure que les modèles et les environnements de déploiement se diversifient.
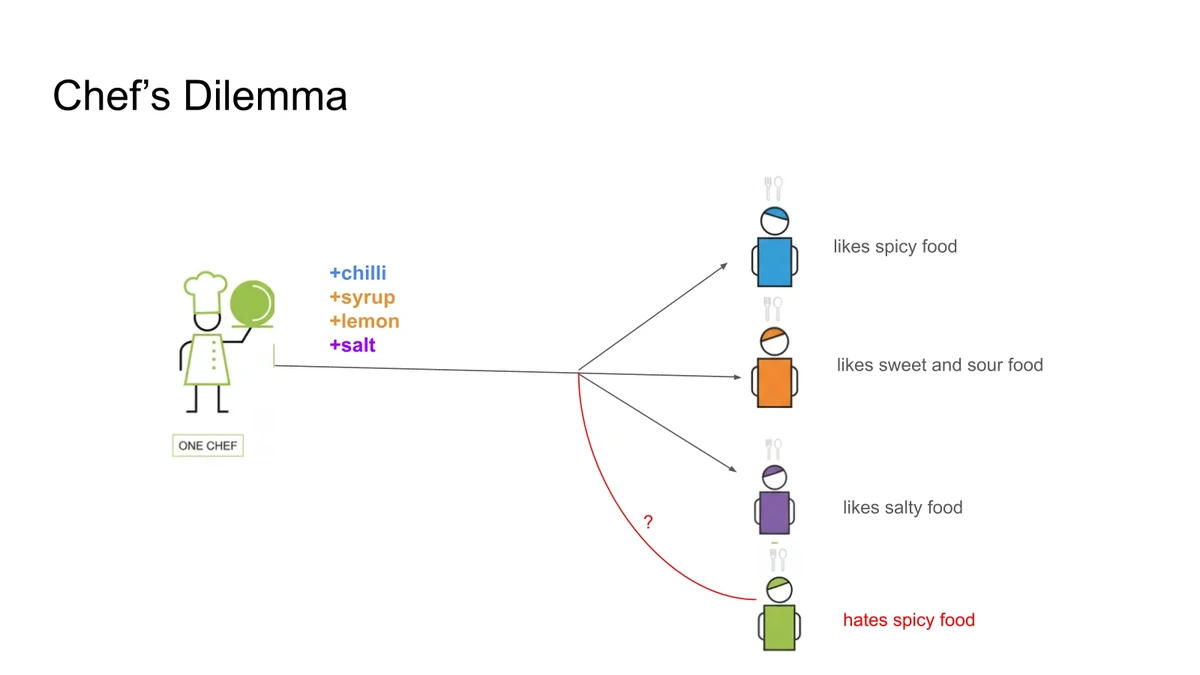
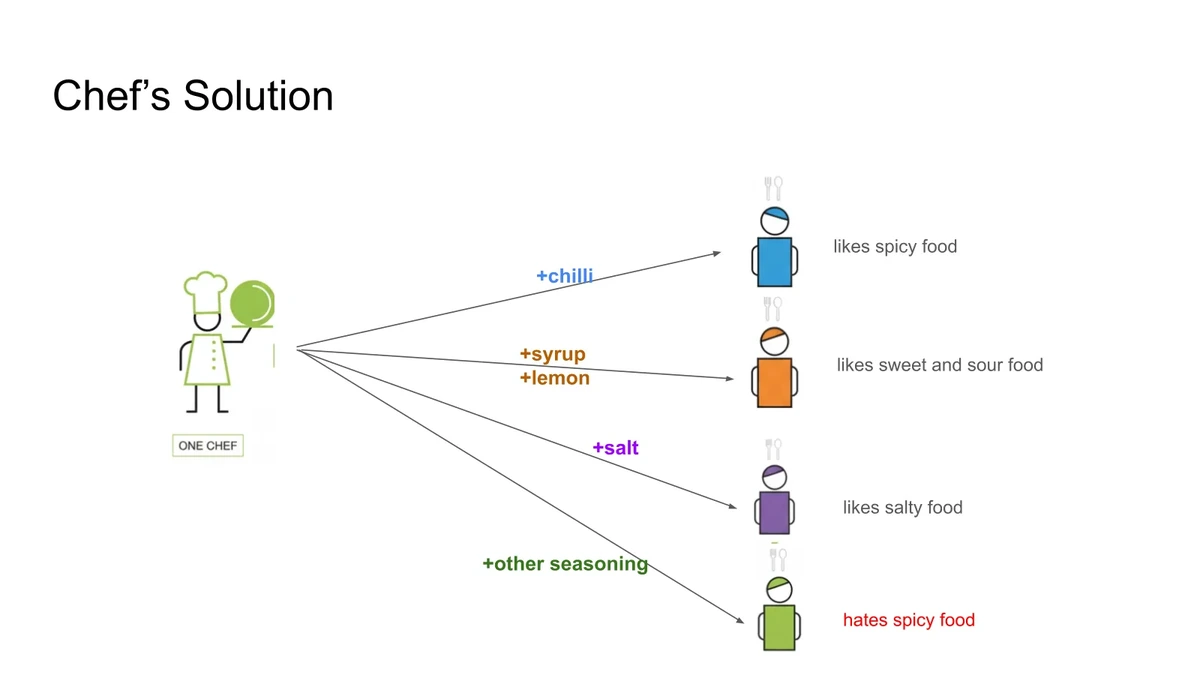
Historiquement, TensorRT s'appuyait sur des modèles internes d'indicateurs clés de performance (KPI) pour identifier les motifs optimisables, qui étaient ensuite encodés sous forme d'heuristiques dans la stratégie de planification par défaut. Bien que cela permettait aux utilisateurs de bénéficier automatiquement de connaissances expertes, cela a créé un problème d'évolutivité. Une heuristique conçue pour un type de modèle pouvait provoquer une régression des performances sur un autre, nécessitant des exceptions supplémentaires qui rendaient la logique de planification complexe et difficile à étendre. Le Global Performance Tuner, introduit dans TensorRT 11.1, résout ce problème en s'éloignant d'une recette unique et fixe. Il considère plutôt le pipeline du compilateur comme une recette de base avec des assaisonnements configurables, permettant au système d'adapter son chemin d'optimisation aux caractéristiques spécifiques de chaque modèle d'entrée, qu'il s'agisse d'un graphe ONNX ou d'un réseau créé via l'API TensorRT.
Pour formaliser cette approche, le système utilise un cadre mathématique qui sépare la génération des solutions candidates de leur sélection. L'espace des modèles comprend toutes les entrées possibles, tandis que l'espace des solutions contient toutes les sorties exécutables, telles que les moteurs TensorRT ou les séquences de noyaux GPU sérialisés. Un algorithme de construction (builder) associe un modèle à un ensemble de solutions candidates, limité par un seuil de tolérance de précision. Ce seuil garantit que les paires entrée-sortie restent dans des limites acceptables, empêchant les optimisations agressives de violer les exigences de l'application. L'objectif de l'algorithme de construction est de générer un ensemble riche de candidats incluant la solution optimale, définie comme l'exécution réalisable la plus rapide qui satisfait aux critères de précision. Cette abstraction permet une analyse rigoureuse de l'impact des différents chemins de construction sur le temps d'exécution final.
Un algorithme de recherche opère ensuite sur cet ensemble de candidats pour sélectionner la meilleure solution. Idéalement, cet algorithme effectuerait une évaluation par force brute de chaque candidat pour trouver celui ayant le temps d'exécution minimal. Cependant, en pratique, les budgets de temps de construction limitent souvent la profondeur de cette recherche. Le compilateur global est donc représenté comme un couple composé d'un constructeur (builder) et d'un chercheur (searcher). Le défi réside dans la construction d'un constructeur optimal qui rend la solution globalement optimale accessible. Étant donné qu'aucun chemin de construction universel unique ne fonctionne pour tous les modèles, le système doit prendre en charge des chemins de construction personnalisables. Cela signifie que la séquence des passes du compilateur, qui transforment les représentations intermédiaires en exécutables finaux, peut varier. Différents modèles peuvent atteindre leurs meilleures performances via des séquences de transformations différentes, même sur le même GPU cible.
Le Global Performance Tuner exploite ces routes de compilation personnalisables pour effectuer un réglage automatique des performances. Pour chaque solution candidate générée par différentes routes, l'outil de réglage valide les résultats par rapport au critère de précision spécifié. Il mesure ensuite les performances d'inférence de bout en bout des solutions viables. Parmi tous les candidats qui satisfont aux exigences de précision, le système sélectionne celui dont le temps d'exécution est le plus faible. Cette approche garantit que les gains de performance ne se font pas au détriment de la fidélité du modèle. En considérant le processus de compilation comme une recherche parmi plusieurs routes de compilation possibles plutôt que comme un chemin unique et fixe, TensorRT 11.1 offre une méthode évolutive pour optimiser les charges de travail d'apprentissage profond sur des modèles et des configurations matérielles variés.
Cette méthodologie résout la limitation fondamentale des approches précédentes, où une modification pour un modèle pouvait dégrader les performances d'un autre. En maintenant le pipeline de base stable tout en rendant les décisions de planification configurables, le système gère efficacement les nouveaux modèles aux préférences inconnues. Il propose différentes variations d'optimisation, rejette celles qui échouent aux contrôles de précision et conserve la configuration offrant les meilleures performances. C'est analogue à un chef qui propose des échantillons gratuits à un nouveau client pour trouver la combinaison d'épices préférée, plutôt que d'imposer une recette standard unique. Le résultat est un processus de compilation plus robuste qui s'adapte aux besoins spécifiques de chaque réseau de neurones, garantissant aux développeurs la vitesse d'inférence la plus élevée possible sans compromettre la précision requise de leurs applications.