NVIDIA déploie des agents IA pour automatiser les opérations des usines IA et alléger la charge des SRE
 Public
- 05 Nov, 2026
À mesure que les clusters GPU s'agrandissent, les ingénieurs en fiabilité des sites (SRE) rencontrent des difficultés pour corréler les baisses de performance aux niveaux du calcul, du réseau et du matériel. NVIDIA a développé l'AI Factory Operations Agent pour optimiser l'exploitation interne des DGX SuperPOD et réduire le travail manuel. Le système utilise des agents spécialisés qui détectent les pannes, identifient leurs causes racines et fournissent des recommandations via une interface de chat. Les ingénieurs peuvent interagir avec ces agents en langage naturel, basculer entre les investigations et suivre les actions à des fins d'audit, ce qui élimine le besoin de vérifier manuellement de nombreux tableaux de bord.
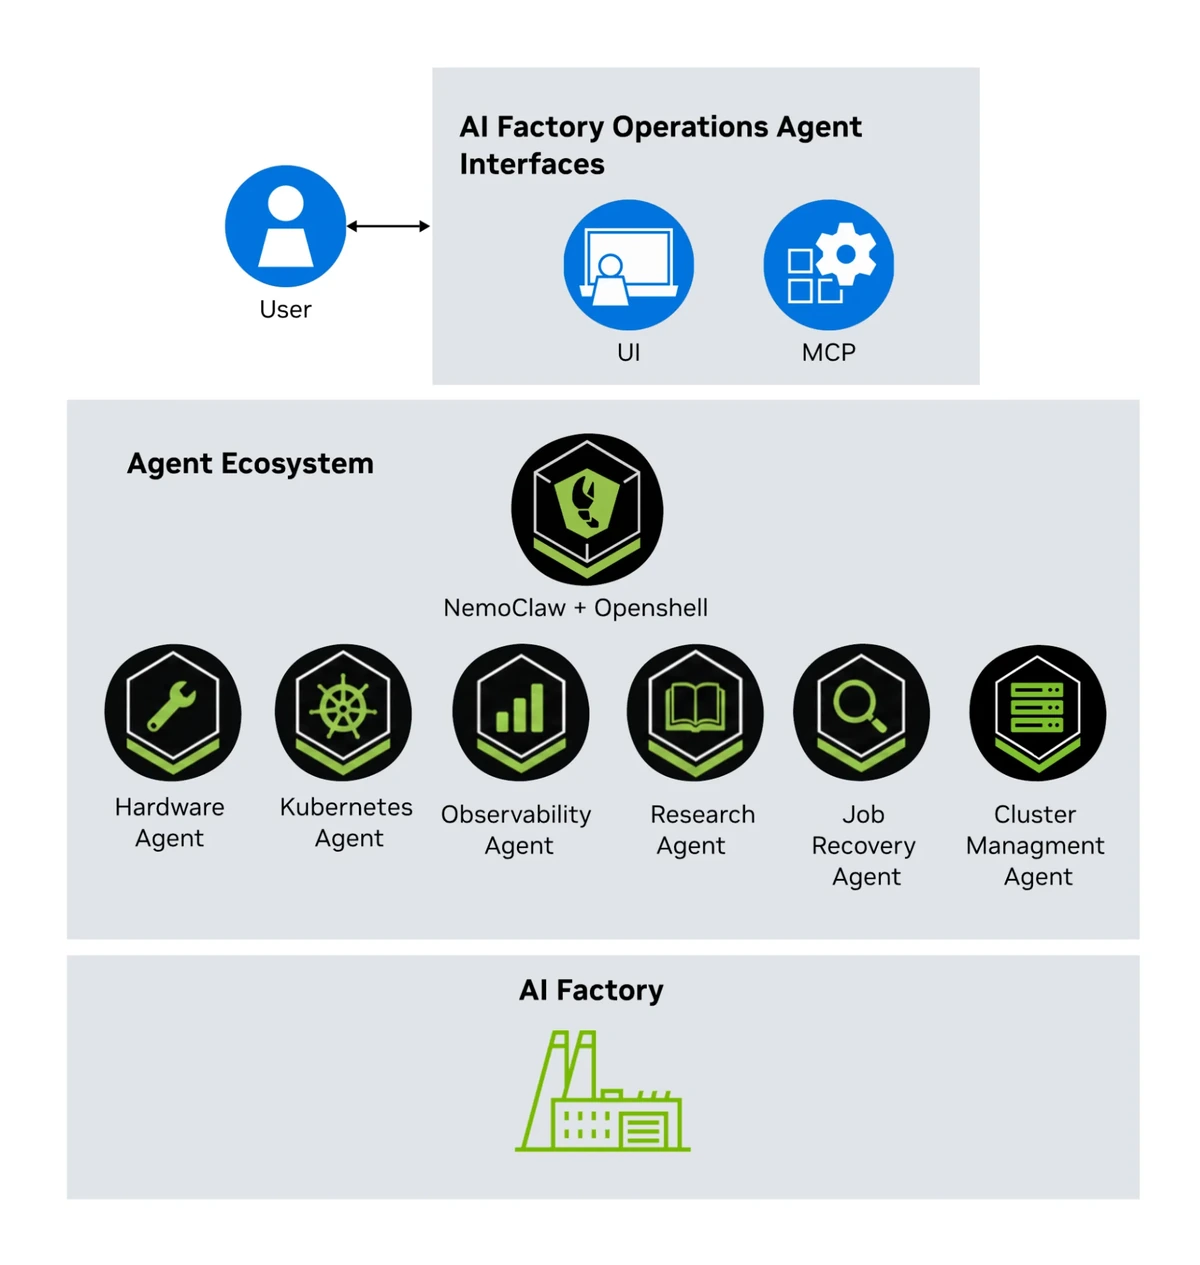
L'exemple destiné aux développeurs est basé sur le modèle NVIDIA NemoClaw et intègre un runtime d'agent orienté utilisateur qui achemine les requêtes vers des agents spécialisés par domaine. La connectivité est établie via des plugins OpenClaw et des serveurs Model Context Protocol, qui exposent des outils opérationnels ciblés. Le framework utilise NVIDIA OpenShell et prend en charge le déploiement entièrement sur site pour garantir la souveraineté des données. L'inférence repose sur des modèles ouverts NVIDIA Nemotron servis localement, fonctionnant sur des clusters de production DGX H100, B200 et GB300. Cette conception modulaire permet d'ajouter de nouveaux agents et des intégrations d'infrastructure sans modifier les composants existants.
Le déploiement s'effectue en tant qu'application du plan de contrôle Kubernetes, où Helm gère l'interface utilisateur, la passerelle OpenClaw, les serveurs MCP et les points d'accès pour l'inférence. Pour l'exécution de commandes dans le shell, OpenShell crée des environnements isolés Kubernetes par session afin de séparer les commandes du pod principal de la passerelle, garantissant que le runtime ne modifie pas les charges de travail de production. La sécurité est assurée par un contrôle d'accès à plusieurs niveaux. L'outil côté serveur run_kubectl utilise des binaires verrouillés et des identifiants en lecture seule, tandis que le RBAC Kubernetes définit les ressources inspectables. Cette configuration permet aux agents de vérifier leurs autorisations, par exemple en confirmant qu'ils peuvent obtenir la liste des pods, mais pas les secrets ou créer de nouveaux pods.
Le déploiement interne utilise un ensemble d'agents spécialisés par domaine. L'agent Job Recovery analyse les échecs d'entraînement aux niveaux du planificateur et du matériel. L'agent Hardware trie les pannes au niveau des périphériques, telles que les erreurs PCIe et les anomalies thermiques. L'agent Observability interroge Prometheus et Grafana Loki pour générer des tableaux de bord dynamiques. L'agent Recherche recherche dans la documentation préchargée, tandis que l'agent Kubernetes fournit une visibilité en lecture seule sur l'état du cluster. L'agent Cluster Management interagit avec les API de Base Command Manager. Les outils transversaux incluent la recherche web et l'exécution de code, et le framework prend en charge des serveurs MCP personnalisés pour des besoins opérationnels spécifiques.
NVIDIA recommande un plan de contrôle accéléré par GPU dédié, isolé du cluster de production, pour gérer l'orchestration des agents sans consommer les ressources nécessaires à l'entraînement. Dans les environnements multi-locataires, OpenShell impose des limites en exécutant les agents dans des environnements isolés avec des restrictions au niveau du noyau, garantissant que les SRE des locataires n'accèdent qu'à leurs espaces de noms et nœuds spécifiques. Le framework est disponible en tant que logiciel open source expérimental sur GitHub, bien que les API et les configurations puissent changer entre les versions. Les clients NVIDIA peuvent contacter leurs gestionnaires de compte pour demander l'accès aux agents de gestion de cluster propriétaires développés pour un usage interne.