NVIDIA AICR confirme la prise en charge de Kubernetes pour Vera Rubin NVL72
 Public
- 03 Nov, 2026
La configuration de Kubernetes pour du nouveau matériel GPU, tel que NVIDIA Vera Rubin, est une tâche complexe et sujette aux erreurs, nécessitant une alignement précis des pilotes, des noyaux, des runtimes et des planificateurs. NVIDIA AI Cluster Runtime (AICR), qui fait partie de la plateforme DSX AI Factory, simplifie ce processus en capturant les configurations optimisées sous forme de recettes réutilisables. Il génère des bundles pour les outils de déploiement et valide les clusters en cours d'exécution, garantissant que les environnements sont prêts pour les plateaux de calcul Vera Rubin NVL72 dès le premier jour. Cette approche aide les équipes de plateforme à concevoir, construire et exploiter des usines IA efficaces à l'aide de composants logiciels modulaires et open source.
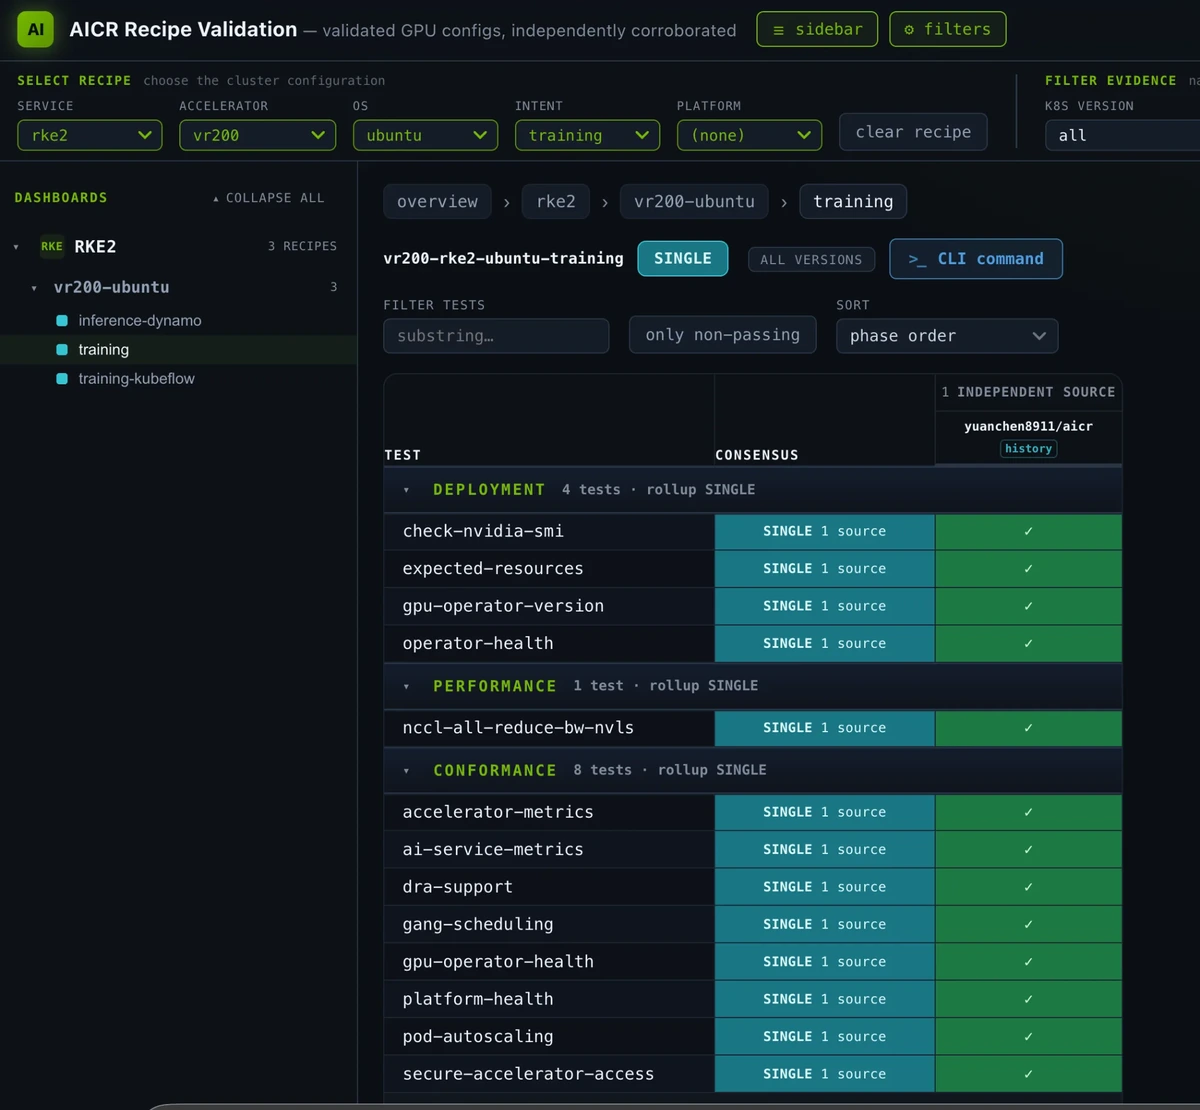
Pour les équipes qui exploitent actuellement des GB200 NVL72, Vera Rubin NVL72 représente la troisième génération de l'architecture MGX à l'échelle du rack, avec plusieurs modifications visibles pour l'utilisateur. Pour valider la prise en charge de bout en bout, le bundle de runtime AICR a été déployé sur des clusters Vera Rubin en utilisant GPU Operator v26.7.0, le pilote DRA v0.5.0 et un pilote R615 installé sur l'hôte. Les deux variantes de recette, pour l'entraînement et l'inférence, ont passé la validation de bout en bout. La variante d'entraînement inclut une porte de performance : un all-reduce NCCL inter-nœuds via le tissu NVLink à l'aide d'un IMEX ComputeDomain, conditionné par un seuil minimal de bande passante du bus. Une problème temporaire de matériel ou de tissu a été rencontré lors des premières validations sur un cluster, mais le repositionnement du matériel l'a résolu, permettant à tous les GPU de rejoindre un seul groupe de tissu.
AICR capture les choix spécifiques à la plateforme sous forme de recette versionnée, rendant les configurations explicites et reproductibles. La nouvelle famille de recettes pour Vera Rubin (service : rke2, accélérateur : vr200, OS : Ubuntu) est livrée en version Preview, sans support de production complet tant que la plateforme est en préversion. Le premier déploiement visait une combinaison inédite : arm64, Ubuntu 26.04, un noyau avec des pages de 64 Ko, RKE2 et Vera Rubin, permettant d'obtenir un runtime fonctionnel en quelques heures. Un second cluster a reproduit ce résultat le lendemain, démontrant la reproductibilité de la recette. Cette approche versionnée garantit que les décisions spécifiques prises lors de la mise en service sont conservées et vérifiables sur différents clusters.
Le flux de travail AICR, exécuté avec la chaîne d'outils v1.0.0, commence par la génération hors ligne de la recette. La commande aicr recipe résout les critères par rapport au catalogue, produisant un fichier YAML qui superpose cinq superpositions sur 14 composants. Les composants clés incluent GPU Operator, le pilote DRA, DraNet pour l'allocation des appareils ConnectX-9 et NodeWright pour le mode netns RDMA exclusif. La commande de génération du bundle aicr bundle crée un ensemble de graphiques Helm ordonnés et un script de déploiement. Ce bundle inclut NodeWright, KAI Scheduler, NVSentinel, NFD et la pile Prometheus, avec les versions de tous les composants verrouillées conformément à la configuration validée sur le matériel Vera Rubin.
La validation implique la capture de l'état du cluster et la vérification des contraintes de préparation. La commande aicr snapshot enregistre l'état, tandis que aicr validate exécute les phases de déploiement, de conformité et de performance. La phase de déploiement vérifie la version du système d'exploitation et les détails du noyau, tandis que la phase de conformité valide l'état des composants. La phase de performance lance une opération NCCL all-reduce en tant que tâche au sein du cluster, en vérifiant la bande passante du bus par rapport au seuil minimal défini dans la recette. Le validateur provisionne lui-même le ComputeDomain et le modèle IMEX ResourceClaimTemplate, sans nécessiter d'étapes préalables de la part de l'opérateur. La variante d'inférence, qui utilise la plateforme Dynamo, passe les mêmes contrôles de déploiement et de conformité sur un cluster identique.
Un test critique de bout en bout implique un ComputeDomain à deux nœuds, où les canaux IMEX sont réclamés par des pods sur chaque plateau de calcul. Pour les images avec IMEX géré par l'hôte, le service statique nvidia-imex de l'hôte doit être désactivé et masqué, car il est mutuellement exclusif avec les ComputeDomains gérés par DRA. GPU Operator v26.7.0 et les versions supérieures fournissent un CRD plus strict, exigeant la configuration explicite de numNodes, ce qui affecte les installations de clusters neuves, mais pas les mises à niveau. L'application du manifeste de test entraîne le lancement de deux pods, chacun avec un canal IMEX injecté, ce qui prend environ 12 secondes. L'ensemble de la séquence, de la génération de la recette à la validation, s'achève en environ cinq minutes, la phase de performance ajoutant le temps d'exécution de la tâche NCCL.