Daviator accélère VASP sur les GPU NVIDIA : calcul des points k par lots et précision mixte
 Public
- 18 Nov, 2026
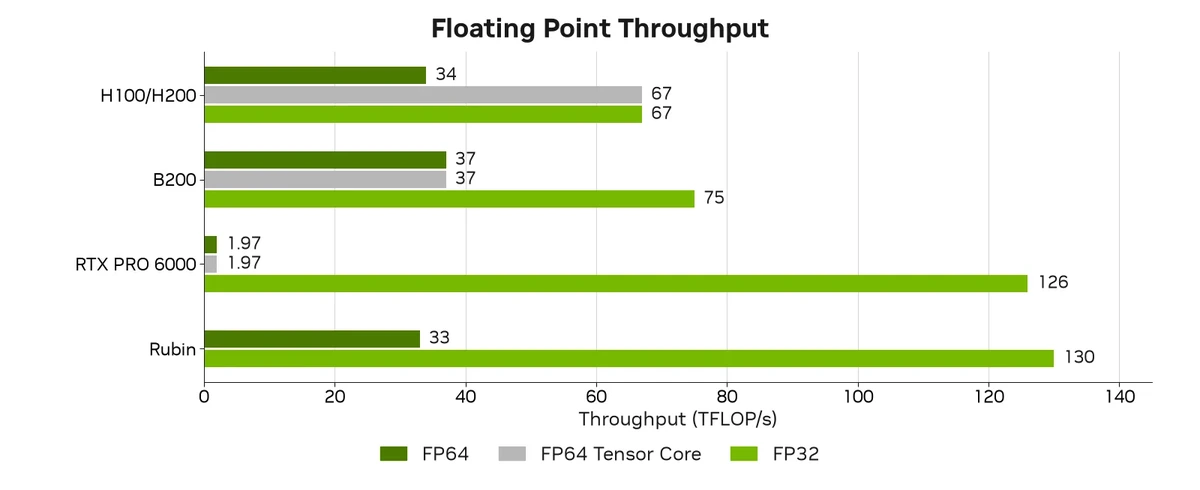
Pour entraîner des potentiels interatomiques par apprentissage automatique (MLIP), il faut des dizaines, voire des centaines de millions de calculs DFT d'énergies, de forces et de contraintes. On les obtient le plus souvent avec VASP, le principal code DFT en ondes planes. Ces tâches utilisent généralement de petites mailles élémentaires et des grilles de points k denses, ce qui laisse les GPU sous-exploités. Le portage OpenACC de VASP traite les points k de manière séquentielle : pour les petits systèmes, des centaines de noyaux minuscules sont lancés à chaque étape, et le surcoût de lancement finit par dominer le temps de calcul. Un système composé d'un seul atome de fer avec 752 points k s'exécutait 8 fois plus lentement sur GPU que sur CPU, obligeant les chercheurs à répartir manuellement les tâches selon leur taille. De plus, le FP64 stagne : les performances FP64 de Hopper, Blackwell et Rubin n'augmentent pas, alors que le FP32 continue de progresser. Le RTX PRO 6000 affiche même un rapport FP32:FP64 de 64:1.
Daviator est une bibliothèque de noyaux GPU de NVIDIA qui remplace les boucles sur les points k par des opérations par lots. Elle repose sur un solveur de Davidson par lots s'appuyant sur des FFT et des GEMM par lots ainsi que sur des noyaux spécifiques. Les lancements sont moins nombreux, l'occupation des SM approche de la saturation et les données ne quittent pas la mémoire du GPU. VASP conserve la boucle SCF, le mélange, la symétrie et les entrées-sorties, tandis que Daviator s'intègre à des points d'appel bien définis. Il s'active via le microservice NVIDIA ALCHEMI VASP avec le paramètre LDAVIATOR=True dans INCAR et intercepte le solveur de Davidson (ALGO = Normal). Les fichiers d'entrée existants n'ont pas besoin d'être modifiés. L'exemple porte sur un seul atome de Fe avec ISPIN = 2, NBANDS = 12, PREC = Accurate et une grille 30x30x30 centrée sur le point Gamma.
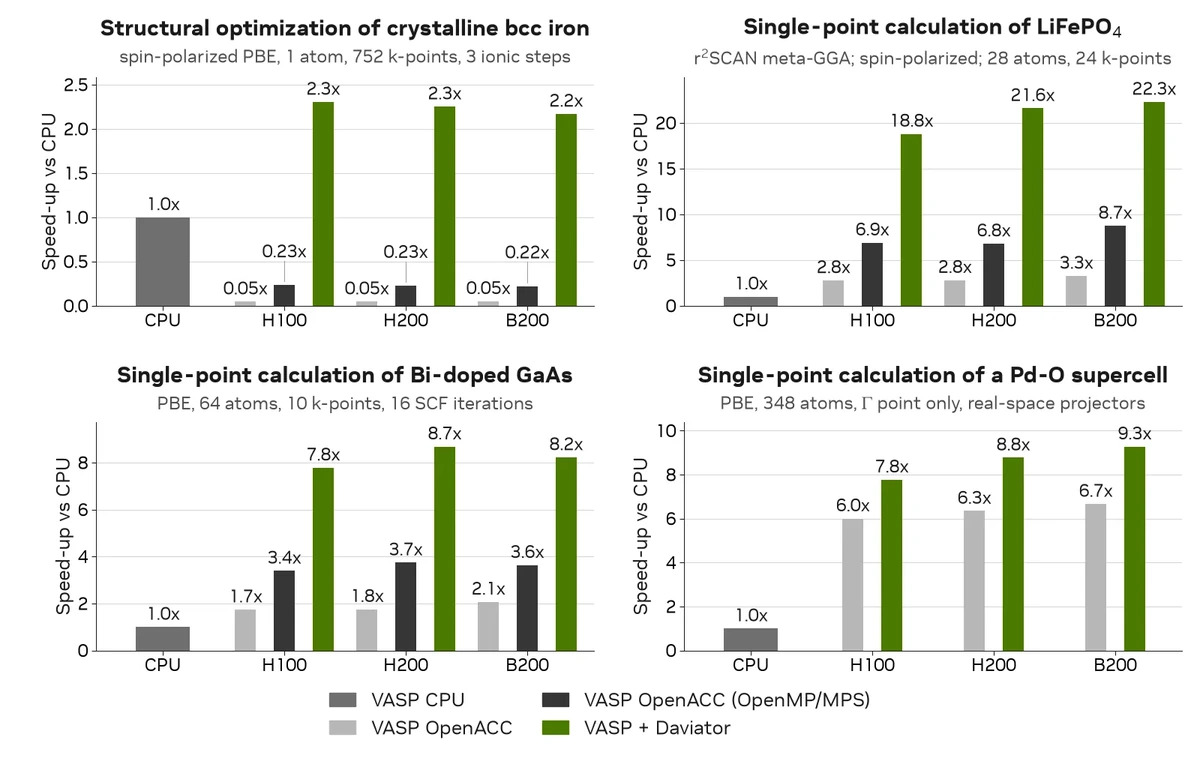
Certains noyaux sont spécialisés selon la taille des lots et peuvent être compilés lors de leur première utilisation. Il est donc conseillé, dans les scripts de tâches, de faire pointer CUDA_CACHE_PATH vers un stockage rapide, par exemple /tmp/cudacache, plutôt que vers $HOME, et de définir CUDA_CACHE_DISABLE=0. Les calculs se lancent comme d'habitude, par exemple mpirun -np 1 vasp_std. Pour l'instant, seule l'exécution sur un nœud unique est prise en charge ; le mode multinœud, vasp_ncl et vasp_gam sont prévus. La comparaison a été faite avec VASP 6.6.0 sur CPU et avec OpenACC sur H100/H200 et B200. Un atome de fer est calculé plus de 2 fois plus vite que sur CPU. Pour LiFePO4 avec r2SCAN, le solveur de Davidson est accéléré 22 fois, et pour GaAs dopé au Bi de 64 atomes, le temps de calcul diminue de plus de 85 %. Même un système de 348 atomes avec un seul point k est calculé plus rapidement, si bien qu'il n'est plus nécessaire de répartir les tâches selon leur taille. Selon les estimations pour les jeux de données, le temps d'obtention des résultats est réduit jusqu'à 22 fois et le coût jusqu'à 75 % par rapport au CPU.
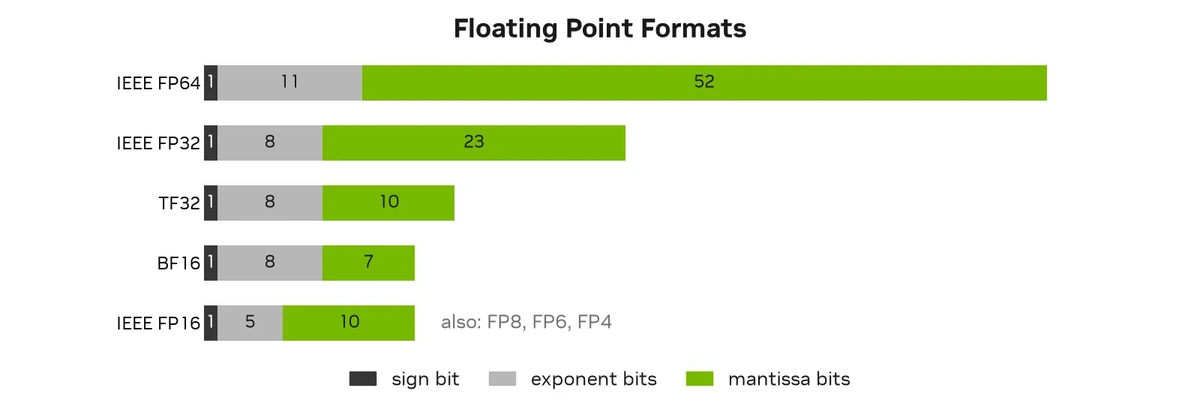
Daviator par lots calcule toujours en FP64, et concevoir un solveur de Davidson en précision mixte n'est pas simple. Si l'on fait passer les noyaux en FP32 et que l'on compare le résultat au FP64, on obtient seulement un verdict « réussi » ou « échoué ». Or des défaillances silencieuses, comme une dérive de l'énergie, une convergence vers une mauvaise solution ou des trajectoires de DM divergentes, peuvent sembler tout à fait plausibles. On utilise donc un type à virgule flottante générique dont le nombre de bits de mantisse et d'exposant est configurable. Il permet de déterminer la précision minimale requise pour chaque noyau et de décider s'il faut le passer en FP32, le réécrire ou le conserver comme « îlot » FP64. Les résultats dépendent des données d'entrée et du seuil. L'instrumentation doit aussi couvrir les dépendances et les fonctions mathématiques, et les exécutions instrumentées, lentes, peuvent être parallélisées sur des ressources HPC. On commence par des conversions FP64↔FP32 autour du chemin critique et par des noyaux à type configurable, puis on réduit les zones FP64 d'itération en itération.
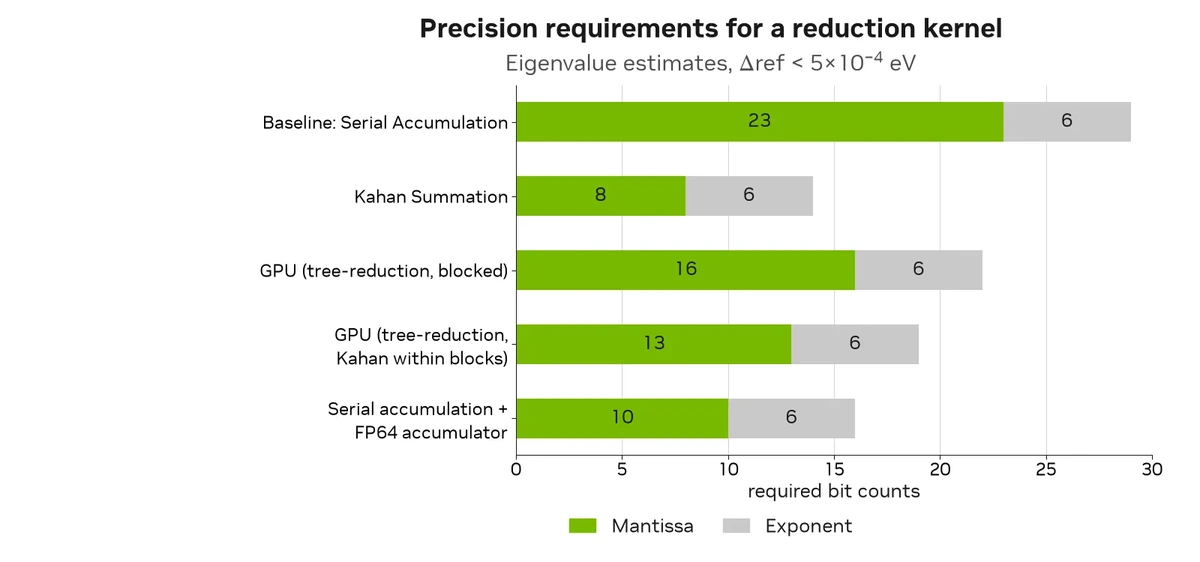
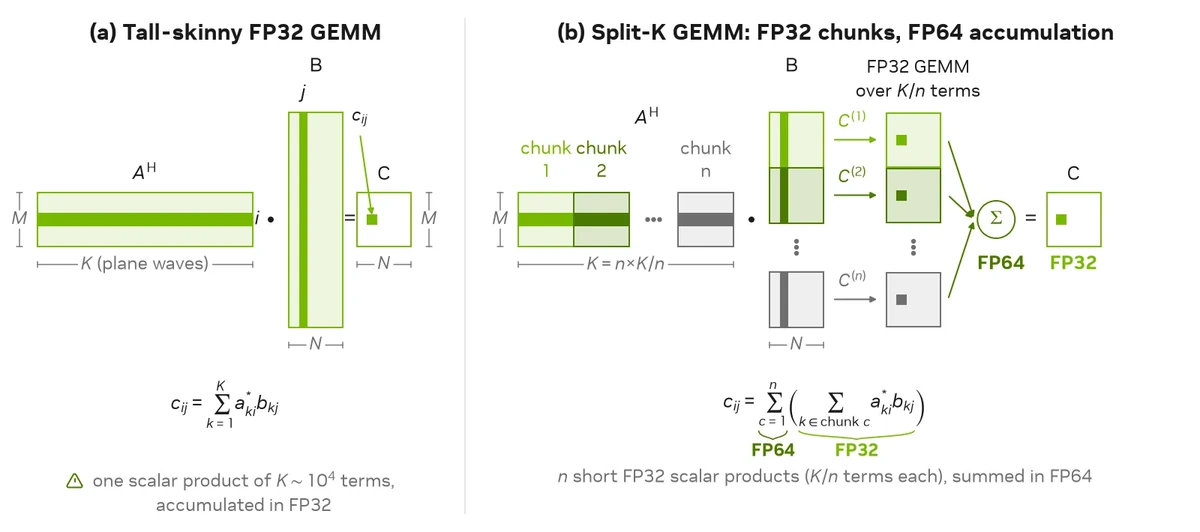
L'analyse basée sur Verificarlo a montré que les FFT, l'application du hamiltonien et la mise à jour des orbitales pouvaient passer en FP32. Le problème aux valeurs propres dans le sous-espace, les énergies, les critères de convergence et les GEMM hautes et étroites à partir desquelles sont construites les matrices du sous-espace sont restés en FP64. Ces GEMM de la méthode de Rayleigh-Ritz alimentent un solveur aux valeurs propres sensible, c'est pourquoi on utilise un algorithme split-k : les produits scalaires sont calculés par blocs en FP32, et l'accumulation finale se fait en FP64. Le seuil EDIFF de VASP vaut par défaut 10-4 eV et peut descendre à 10-6 eV ou moins, alors que le FP32 offre environ 7 chiffres significatifs. Le solveur mixte converge jusqu'à 10-4 à 10-6 eV selon les données d'entrée, puis le calcul se poursuit en FP64 en dessous du niveau de bruit du FP32. Sur GaAsBi-64, le FP32 apporte une accélération de 2x avec EDIFF = 10-5 eV, et la combinaison FP32→FP64 est 1,5 fois plus rapide que le FP64 pur à 10-8 eV.
Sur les H100 et H200, dont les Tensor Cores FP64 égalent le débit FP32, le gain est faible. En revanche, sur la RTX PRO 6000, le solveur de Davidson en FP32 est 3 à 7 fois plus rapide, et le calcul complet environ 2 fois plus rapide. La précision mixte s'active avec le paramètre LDAVIATOR_MIXED_PRECISION (0 signifie FP64). Chaque pas ionique commence avec un stockage des données en FP32 jusqu'à ce que DAVIATOR_EDIFF_FP32 ou DAVIATOR_SWITCH_TO_FP64_AFTER_STEP soit atteint ; une valeur de 10-4 à 10-5 convient à la plupart des données d'entrée. L'exemple utilise EDIFF = 5e-07, LDAVIATOR = True, LDAVIATOR_MIXED_PRECISION = True, DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2 et DAVIATOR_EDIFF_FP32 = 5e-05. Une licence VASP est requise, et Daviator en précision mixte fonctionnera sur n'importe quel GPU NVIDIA via le microservice ALCHEMI VASP.