Accélération du chargement des données vers le GPU avec NVIDIA KvikIO et GPUDirect Storage
 Public
- 22 Oct, 2026
NVIDIA Magnum IO GPUDirect Storage (GDS) résout le goulot d'étranglement lors du transfert de grands jeux de données du stockage vers les accélérateurs en permettant un chemin de données direct qui contourne le stockage intermédiaire en mémoire CPU. À mesure que les modèles d'IA et les jeux de données d'entraînement croissent de manière exponentielle, le transfert efficace des données est essentiel pour maintenir l'alimentation des GPU. Bien que l'interface principale de GDS soit l'API C cuFile, Python reste le langage dominant dans le développement moderne de l'IA. NVIDIA KvikIO comble cet écart en fournissant des interfaces Python et C++ de haut niveau et idiomatiques pour l'entrée/sortie de fichiers à haute performance. Il se situe au-dessus de cuFile, offrant des contrôles supplémentaires sur l'exécution des requêtes d'entrée/sortie, permettant aux développeurs de gérer le chemin de données sans passer au code C de bas niveau.
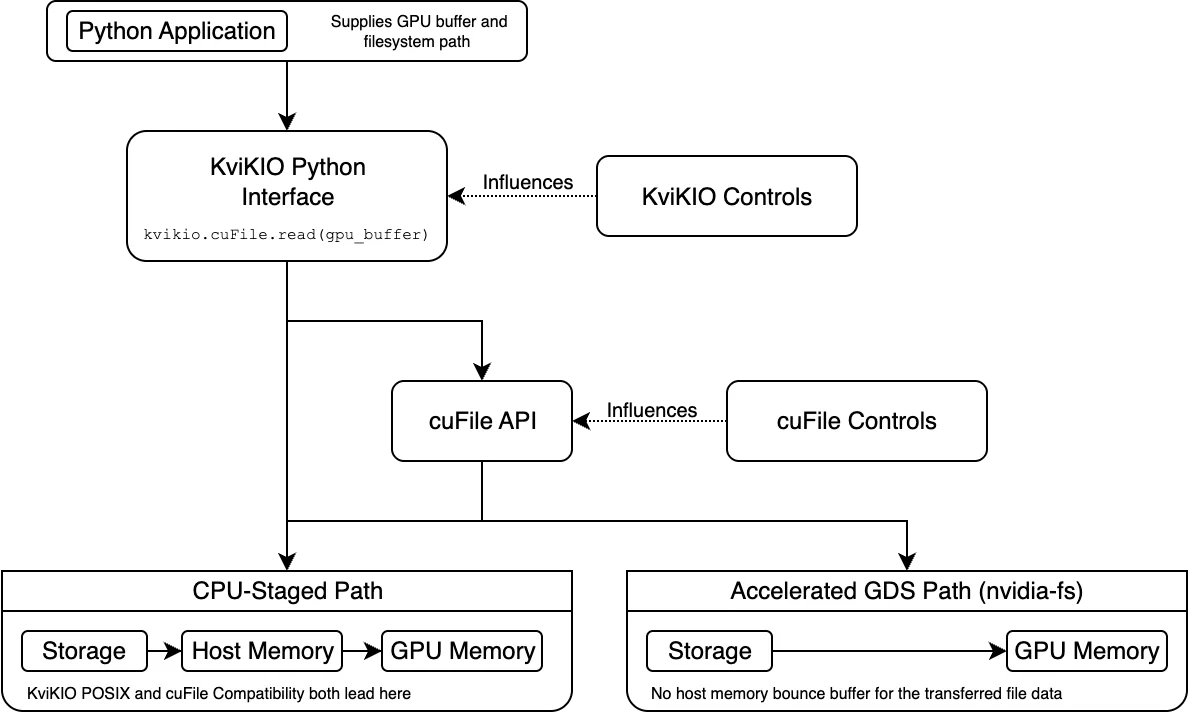
L'architecture implique deux points de décision distincts pour le choix du chemin de transmission des données. Premièrement, KvikIO détermine s'il doit envoyer la requête via cuFile ou utiliser son propre chemin de compatibilité POSIX, qui utilise la mémoire hôte comme étape intermédiaire. Ce choix est influencé par le paramètre compat_mode, qui peut prendre les valeurs AUTO, ON ou OFF. En mode AUTO, KvikIO tente d'utiliser cuFile, mais bascule sur POSIX si celui-ci n'est pas disponible. Deuxièmement, une fois que cuFile reçoit la requête, il décide d'utiliser le chemin GDS accéléré ou son propre chemin de compatibilité avec stockage intermédiaire sur CPU, en fonction de la prise en charge par le système et de la configuration. Par conséquent, l'appel à l'API cuFile ne confirme que le choix de KvikIO ; il ne garantit pas que le chemin GDS accéléré a été utilisé. Les développeurs doivent vérifier le chemin final pour assurer des performances optimales.
Pour commencer, configurez un environnement Python et installez la version de KvikIO pour CUDA 13 à l'aide de la commande pip install kvikio-cu13, qui inclut CuPy en tant que dépendance. Avant d'effectuer des opérations d'entrée/sortie, inspectez la configuration active à l'aide de l'API par défaut de KvikIO. Les paramètres clés incluent compat_mode, qui indique le mode actif, et gds_threshold, la taille minimale de requête envoyée à cuFile. Sur le système de test, le seuil est de 16 Ko, ce qui signifie que les lectures plus petites sont effectuées directement via le chemin POSIX de KvikIO. Ces paramètres peuvent être contrôlés par des variables d'environnement telles que KVIKIO_COMPAT_MODE et KVIKIO_GDS_THRESHOLD. De plus, le script gdscheck.py peut être utilisé pour vérifier les composants GDS installés, les systèmes de fichiers pris en charge et la configuration cuFile active sur la plateforme.
Pour lire des données dans la mémoire GPU, allouez un tableau CuPy de la taille appropriée et utilisez le gestionnaire de contexte kvikio.CuFile pour effectuer la lecture. Par exemple, pour lire un fichier de 1 Gio, il faut créer un tampon CuPy de 1 Gio et le passer à la méthode read. Pour vérifier le chemin de transmission des données, activez les statistiques d'exécution de cuFile en définissant la variable d'environnement CUFILE_STATS_LEVEL=3 et en exécutant le script en mode interactif. Ensuite, utilisez gds_stats pour inspecter les compteurs. Dans la sortie par GPU, le compteur nvfs suit les opérations utilisant le module noyau nvidia-fs (chemin accéléré), tandis que posix suit les opérations utilisant le chemin de compatibilité. Avec les paramètres par défaut, une lecture de 1 Gio est divisée en 256 opérations de 4 Mio chacune, toutes affichant nvfs=256 et posix=0, confirmant l'utilisation du chemin accéléré.
Un contrôle supplémentaire est possible en modifiant indépendamment les paramètres de KvikIO et de cuFile. La définition de KVIKIO_COMPAT_MODE=off force KvikIO à utiliser cuFile, tandis que CUFILE_FORCE_COMPAT_MODE=true force cuFile à utiliser son chemin de compatibilité, ce qui entraîne l'apparition de compteurs posix dans les statistiques. À l'inverse, KVIKIO_COMPAT_MODE=on contourne complètement cuFile, en utilisant le backend de KvikIO avec stockage intermédiaire sur CPU. En plus du choix du chemin, les paramètres d'exécution dans le fichier cufile.json contrôlent le traitement des requêtes. KvikIO divise les grandes opérations en tâches basées sur KVIKIO_TASK_SIZE, qui sont ensuite envoyées à cuFile. cuFile peut diviser davantage ces requêtes en fonction de son pool de threads interne et de min_io_threshold_size_kb. Par exemple, une requête de 1 Gio avec une taille de tâche de 4 Mio résulte en 256 requêtes cuFile distinctes, chacune traitée comme une pièce unique.
Si KvikIO envoie une seule requête volumineuse (par exemple, 1 Gio) à cuFile, ce dernier peut la diviser en morceaux plus petits pour un traitement parallèle, limité par le nombre de threads de travail et max_request_parallelism. Dans une configuration avec quatre threads de travail, une requête de 1 Gio est divisée en quatre morceaux de 256 Mio. Comme le tampon de destination n'est pas enregistré pour le DMA de stockage, cuFile utilise un tampon GPU intermédiaire enregistré, en copiant les données par blocs de 16 Mio maximum. Le paramètre min_io_threshold_size_kb influence la planification des requêtes ; par exemple, une requête de 16 Mio peut être divisée en deux morceaux de 8 Mio pour respecter le seuil. KvikIO fait partie des bibliothèques CUDA-X et a été utilisé dans cuDF, cuCIM et cuPhoton pour accélérer l'ingestion de données au format Parquet, ORC et d'images scientifiques. La compréhension de ces couches permet aux développeurs d'optimiser les performances d'entrée/sortie pour des charges de travail spécifiques.