Blog
 Public
- 09 Nov, 2026
Infraestructura automatizada de trazado de LLM para el desarrollo de agentes de IA
La introducción de agentes de IA suele provocar un cuello de botella crítico: la ausencia de una base estructurada para recopilar los historiales de ejecución necesarios para la evaluación y la mejora. Los ingenieros de despliegue (FDE) de AI Shift, filial de CyberAgent, se enfrentan a este problema a diario al crear diversas aplicaciones de IA para clientes. Su misión es maximizar el valor integrándose a fondo en los flujos de trabajo de los clientes, pero la prioridad de añadir instrumentación de observabilidad suele ser baja. Dado que las aplicaciones funcionan correctamente sin trazado, y que decidir cómo instrumentar cada componente es complejo, los FDE suelen aplazar esta tarea. Este retraso dificulta evaluar la calidad de los resultados y demostrar a los clientes la rentabilidad, lo que crea una brecha entre el desarrollo rápido y la supervisión operativa necesaria.Para resolver este problema, el equipo desarrolló una arquitectura de trazado de dos capas que equilibra la automatización y el contexto de negocio. La primera capa utiliza un LLM Gateway, en concreto Agent Router (antes Envoy AI Gateway), para capturar telemetría a nivel de infraestructura. Al enrutar todas las llamadas a LLM a través de esta pasarela, el sistema registra automáticamente las entradas, las salidas, los nombres de los modelos y el número de tokens. Estos datos se envían mediante OpenTelemetry a un recolector y después se filtran para que a Langfuse, una plataforma de ingeniería de LLM, lleguen solo las trazas relacionadas con LLM. Este enfoque libera a los FDE de la carga de tomar decisiones: no necesitan decidir manualmente si instrumentar cada llamada a LLM, ya que la pasarela lo hace de forma automática a nivel de infraestructura.Sin embargo, el LLM Gateway por sí solo no puede capturar la semántica específica del negocio ni mantener el contexto en flujos de trabajo complejos. Sin propagación de contexto a nivel de aplicación, la pasarela genera trazas independientes y superficiales para cada llamada al LLM, lo que dificulta el análisis. Para resolverlo, el equipo desarrolló un Tracing SDK propio. Este SDK no se utiliza para instrumentar las llamadas al LLM en sí, que siguen siendo responsabilidad de la pasarela, sino para adjuntar metadatos de negocio. Permite a los desarrolladores definir trazas con entradas específicas, identificadores de usuario e identificadores de sesión, lo que proporciona una jerarquía clara de operaciones. Por ejemplo, una traza puede abarcar un proceso de "revisión", vinculando el contexto del usuario y el propósito concreto de la llamada al LLM, como una comprobación de guardarraíles o una evaluación, con el resultado obtenido.Para reducir aún más la carga de desarrollo, el equipo creó un AI Skill que permite a los asistentes de programación insertar automáticamente la instrumentación necesaria del Tracing SDK. Esta automatización garantiza que, incluso cuando el desarrollo se acelera con la ayuda de la IA, el código de observabilidad requerido se aplique de forma coherente. Los datos resultantes en Langfuse están muy estructurados y muestran trazas claras con metadatos adjuntos, como las sesiones de usuario y los propósitos de las llamadas. Esta configuración asegura que, incluso si se omite la instrumentación manual del SDK, el LLM Gateway sigue registrando los datos básicos de la llamada, lo que ofrece una alternativa de respaldo para un análisis mínimo. Esta infraestructura permite que los FDE se centren en resolver los problemas de los clientes y, al mismo tiempo, mantengan la calidad de datos necesaria para la evaluación y la mejora continuas de los agentes.
- Public
- 09 Nov, 2026
Chaos lanza V-Ray 7.5 para 3ds Max con una integración avanzada de IA y nuevas herramientas de iluminación
Chaos ha lanzado oficialmente V-Ray 7 para 3ds Max, Update 5. Es un paso importante para el renderizador de producción que se utiliza en visualización arquitectónica, VFX y motion graphics. Esta actualización se centra en las capacidades de inteligencia artificial: presenta un asistente de IA experimental que va más allá del soporte técnico básico. El asistente puede recomendar assets de la biblioteca Chaos Cosmos haciéndolos coincidir con imágenes de referencia, y utiliza la función Sky Match para sugerir combinaciones adecuadas de HDRI y LUT para un renderizado realista del cielo. Quizá lo más destacable es la función Render Critique: el asistente puntúa los renders del 1 al 10 según el fotorrealismo, la composición y la calidad de la iluminación. Se trata de una retroalimentación estética automatizada que puede generar debate entre los artistas sobre el papel de la IA en el juicio creativo.Además del asistente, V-Ray 7.5 integra un servidor de Model Context Protocol (MCP), que permite que herramientas de IA externas, como Claude o ChatGPT, controlen el programa. Aunque el servidor MCP nativo solo está disponible en las ediciones para SketchUp y Rhino, los servidores MCP de terceros son compatibles con la versión para 3ds Max. La biblioteca Chaos Cosmos también recibe nuevas funciones de IA, entre ellas la búsqueda por imágenes y un sistema 3D generativo. Ahora los usuarios pueden generar modelos 3D a partir de imágenes con los modelos de IA HY 3D de Tencent o Trellis.2 de Microsoft. Estas incorporaciones buscan simplificar la creación e integración de assets, reduciendo el trabajo manual necesario para poblar las escenas con geometría y materiales realistas y acelerando así las fases de preproducción y de composición de escenas (layout) en proyectos visuales complejos.La actualización también incluye mejoras importantes en el motor de renderizado principal que no están relacionadas con la IA. Hay dos nuevos tipos de luz nativa: Spot Light, que permite crear una iluminación focal físicamente precisa sin modificar las luces planas o de disco, y Cylinder Light, diseñada para imitar los tubos fluorescentes y las luminarias lineales reales. Spot Light admite el enlace de luces (light linking) y la contribución atmosférica directa, aunque algunos parámetros, como la forma del cono y las compuertas (barn doors), por ahora se limitan al renderizado con CPU. Para el trabajo con volúmenes, el nuevo objeto experimental VRayVolume permite importar y renderizar directamente archivos OpenVDB y cachés de simulación en la vista del puerto de visualización de 3ds Max. Esto se complementa con nuevos nodos de muestreador y un material de volumen específico, lo que mejora el flujo de trabajo de los artistas que manejan datos volumétricos complejos.V-Ray para 3ds Max ahora admite directamente los datos volumétricos generados por Zenith, el sistema de simulación de humo y fuego del complemento tyFlow, lo que facilita un pipeline más fluido para los artistas de efectos. La actualización también mejora las herramientas incluidas en determinadas suscripciones. Veras, la herramienta de IA para arquitectura, incorpora un sistema de modelado agéntico que crea modelos 3D a partir de bocetos o imágenes con GPT-6 Astra o Claude Opus 5.5, además de una nueva pestaña Nodes para personalizar los flujos de trabajo de IA. Anima, el sistema de animación de multitudes, recibe en la versión 7.1 un servidor MCP y compatibilidad con OpenMCP, y los proyectos de Anima ahora se pueden importar directamente a Vantage, el renderizador de trazado de rayos en tiempo real. Tanto Anima como Vantage siguen siendo exclusivos del paquete V-Ray Collection y no están disponibles en los planes Solo ni Premium.V-Ray 7.5 para 3ds Max es compatible con 3ds Max 2021 y versiones posteriores, en sistemas operativos Windows 10 o más recientes. El software solo está disponible mediante alquiler. La suscripción V-Ray Solo cuesta 89,15 dólares al mes o 540 dólares al año. La suscripción V-Ray Premium cuesta 129,90 dólares al mes o 778,80 dólares al año. Estas estructuras de precios reflejan el acceso escalonado a las funciones: los planes Premium y Collection ofrecen acceso al conjunto ampliado de herramientas, que incluye Veras, Anima y Vantage. La versión posiciona V-Ray como un centro neurálgico para la creación asistida por IA, al combinar la potencia tradicional del renderizado con las capacidades generativas actuales para responder a las crecientes exigencias de la producción visual de alta gama y del desarrollo de medios interactivos.
- Public
- 09 Nov, 2026
NVIDIA y Corea amplían su colaboración en IA soberana
NVIDIA y el Ministerio de Ciencia y TIC de Corea amplían su alianza en materia de IA soberana, que abarcará semiconductores, centros de datos y talento. La iniciativa permite que las empresas coreanas de NPU y XPU se incorporen al ecosistema NVIDIA NVLink Fusion. Para mejorar el aprovechamiento de las GPU, el plan incluye formación, certificación, hackatones y seminarios técnicos para desarrolladores locales.En el marco de la iniciativa AI for All, NVIDIA trabajará con tres consorcios seleccionados y cuatro de los principales desarrolladores coreanos de modelos fundacionales. Utilizarán el software NVIDIA Dynamo para optimizar y escalar la inferencia de IA. Además, NVIDIA anunció una nueva colaboración con SK Telecom y Rebellions, con el respaldo del MSIT, para impulsar la infraestructura de IA soberana para modelos y cargas de trabajo coreanos mediante NVLink Fusion.
- Public
- 08 Nov, 2026
Actualizaciones de Autodesk Flame 2027.2: mapeo de profundidad con IA mejorado e integración de OpenTimelineIO
Autodesk ha puesto en marcha el ciclo de versiones de Flame 2027, la nueva serie anual de actualizaciones de su software insignia de composición, finalización y efectos. La versión inicial de Flame 2027 presentó un completo sistema nuevo de anotaciones, dos modelos de IA independientes para generar mapas de profundidad a partir de material de vídeo y compatibilidad nativa con el estándar OpenTimelineIO. Estas actualizaciones básicas se han ido perfeccionando en parches posteriores; la reciente actualización Flame 2027.2 garantiza que las funciones principales sean estables y estén totalmente integradas en el flujo de trabajo del usuario. La versión también extiende estas mejoras a Flare y Flame Assist, las ediciones reducidas del software, para que los usuarios de los distintos niveles de la línea de productos puedan aprovechar las nuevas funciones y las mejoras en los flujos de trabajo.El nuevo sistema Annotations permite marcar los clips directamente dentro de Flame, sin necesidad de cambiar a una plataforma especializada de revisión de planos para añadir notas. Los usuarios pueden insertar anotaciones de texto o dibujadas, como líneas, flechas, círculos, rectángulos o trazos a mano alzada, directamente sobre los clips en el Player o en los visores. Estos marcadores y los marcadores de segmento con anotaciones se indican claramente en la línea de tiempo, y las propias anotaciones se pueden seleccionar y gestionar mediante la Timeline Ribbon. Esta integración simplifica la comunicación entre artistas y directores, ya que permite recibir comentarios al instante y hacer un seguimiento de las revisiones sin salir del entorno de composición.Una incorporación significativa a las herramientas de IA son dos nuevos modelos de aprendizaje automático, ML Depth Indoor y ML Depth Outdoor, que generan datos de profundidad de escenas completas a partir de imágenes fijas o clips. A diferencia del modelo Face Analysis existente, optimizado específicamente para rostros humanos, estos nuevos modelos están diseñados para trabajar con entornos interiores y exteriores complejos. Los datos de profundidad obtenidos se pueden utilizar para crear mattes en el objeto Selective o en nodos ML Depth independientes. Además, el sistema admite la carga de modelos de IA de profundidad personalizados en formato ONNX, lo que ofrece flexibilidad a los estudios que han desarrollado modelos propios. Esta capacidad aumenta la precisión de la separación de objetos y de la comprensión de la escena en planos complejos.Las mejoras de flujo de trabajo en Flame 2027 se centran en una mejor conservación de los metadatos y en la introducción de tokens personalizados. Los metadatos por fotograma de los clips importados ahora se pueden editar mediante un nuevo nodo Metadata y escribir en la cabecera del archivo OpenEXR al exportar secuencias de archivos o publicar contenido. Además, los usuarios pueden crear tokens personalizados para insertar cadenas de texto predefinidas en los campos de texto compatibles, lo que simplifica las tareas repetitivas. Ahora el software también admite añadir Markers en el entorno Effects. La integración con el pipeline se ha ampliado con la compatibilidad con OpenTimelineIO, el estándar abierto para la información de edición de montaje. Los archivos OTIO se pueden abrir en el entorno Conform de forma similar a los archivos AAF, XML o EDL, aunque la implementación actual solo admite secuencias OTIO básicas y todavía no procesa los efectos ni las propiedades de otros programas de VFX.
- Public
- 08 Nov, 2026
Las herramientas de Android XR alcanzan el estado estable: lanzamiento de XREAL AURA y novedades de Engine Hub
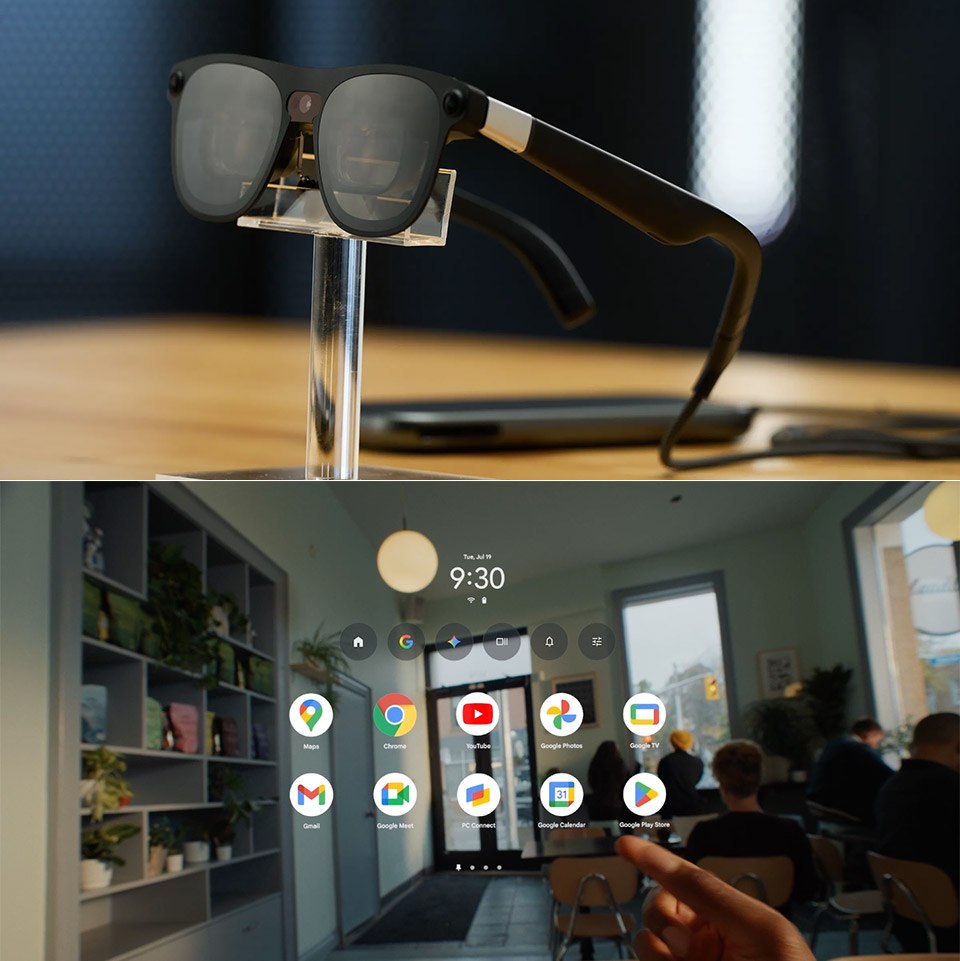
El ecosistema de Android XR ha alcanzado un hito importante con el lanzamiento de XREAL AURA, las primeras gafas XR con cable basadas en esta plataforma. Los dispositivos pesan menos de 95 gramos, lo que garantiza comodidad al llevarlos, y su módulo de computación portátil permite aprovechar la base común de Android. Esta arquitectura asegura que las aplicaciones existentes funcionen inmediatamente después de su despliegue. Así se facilita la entrada de los desarrolladores que quieren ampliar sus productos con interacciones espaciales más ricas, sin tener que recurrir a una refactorización de código a gran escala ni a ajustes complejos de compatibilidad.Para los desarrolladores que crean experiencias nativas con Kotlin y Compose, la preparación para producción se apoya ahora en la capa de la plataforma. Las bibliotecas principales de Jetpack XR SDK han pasado oficialmente a la versión estable, lo que garantiza estabilidad de las API a largo plazo y un rendimiento optimizado. Este conjunto estable incluye Jetpack SceneCore para manipular grafos de escenas 3D, ARCore for Jetpack XR para la percepción del entorno y XR Runtime para la gestión estandarizada de sesiones. Además, los emuladores de Android XR en Android Studio ya son estables. Esto permite a los equipos crear, iterar y validar visualmente diseños para distintos formatos de dispositivos XR directamente desde un portátil, sin necesidad de contar con hardware físico.Las capacidades de anclaje al mundo real se han reforzado con la estabilización de las API geoespaciales en ARCore for Jetpack XR. Estas API permiten a los desarrolladores anclar contenido digital a coordenadas reales con gran precisión y un seguimiento local robusto. La combinación de servicios de posicionamiento visual con la percepción local del dispositivo abre la puerta a experiencias contextuales y basadas en la ubicación, diseñadas específicamente para las gafas XR con cable. Ahora es posible diseñar interfaces con visión directa a través de lentes ópticas (optical see-through) usando Jetpack Compose Glimmer y anclarlas a ubicaciones físicas concretas, lo que garantiza una alineación espacial coherente entre distintas sesiones e interacciones del usuario.Android XR Engine Hub también ha alcanzado el estado estable, lo que simplifica los flujos de configuración y optimización para Unity, Godot y Unreal Engine. Este hub facilita la creación de la estructura base del proyecto al ofrecer extensiones de OpenXR preconfiguradas y ajustes de proyecto validados, de modo que se puede empezar a crear de inmediato. Además, incorpora flujos de perfilado nativos que permiten capturar e inspeccionar trazas del sistema, límites térmicos y presupuestos de fotogramas en los núcleos de CPU y GPU directamente desde la interfaz del motor. Esta integración permite identificar a tiempo los cuellos de botella de rendimiento durante el desarrollo y mantener una alta tasa de fotogramas y estabilidad térmica en las aplicaciones inmersivas.Para respaldar la expansión hacia interacciones centradas en el audio, se han presentado nuevas herramientas para diseñar experiencias multimodales y ligeras. Los desarrolladores ya pueden usar la API ML Kit Gen AI Text to Speech para generar voces de sonido natural impulsadas por IA en el propio dispositivo. Las nuevas guías de diseño sobre buenas prácticas de sonido, incluido el uso de Earcons, ayudan a orientar a los usuarios en entornos aumentados y de prioridad auditiva. Estas capacidades permiten crear aplicaciones conversacionales manos libres combinando Jetpack Projected, ML Kit y modelos Gemini Nano en el dispositivo, pensadas para gafas inteligentes y otros formatos que priorizan la voz y la entrada de audio frente a las pantallas visuales.
- Public
- 08 Nov, 2026
Unity lanza un libro electrónico sobre desarrollo XR para Meta VR
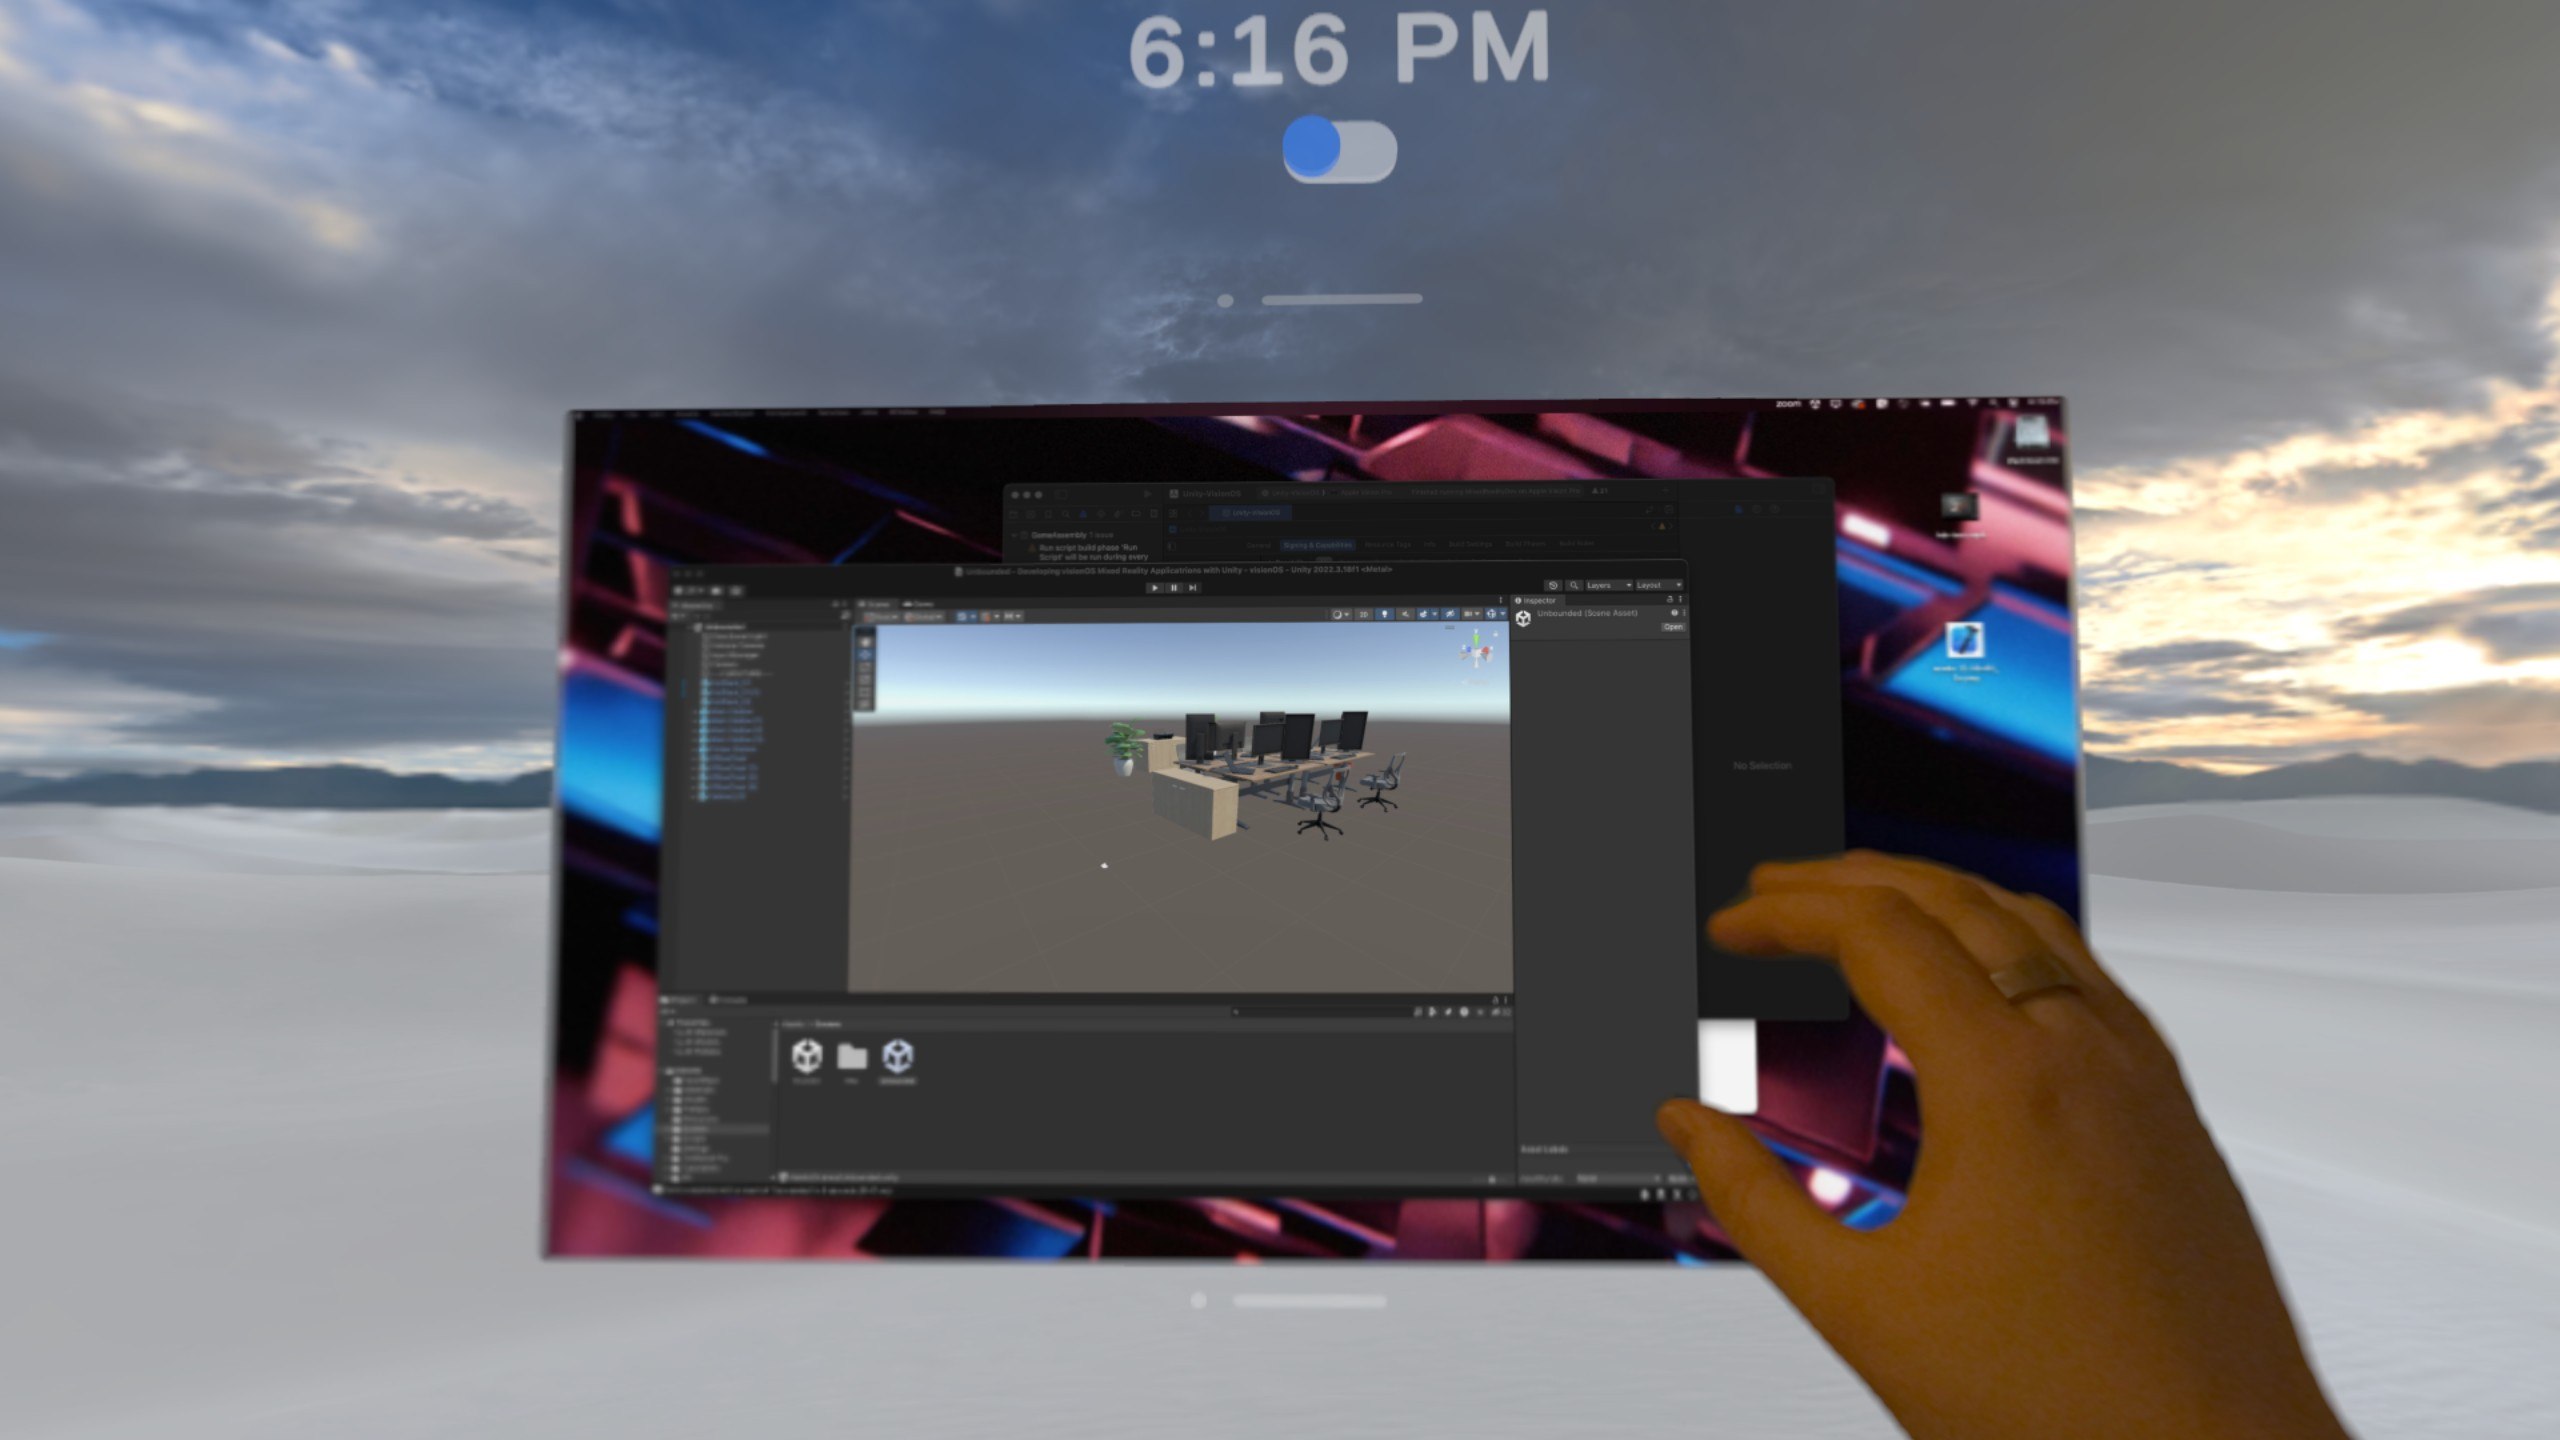
Unity ha lanzado un nuevo libro electrónico titulado «Build XR with Unity: Meta XR». Está dirigido a los desarrolladores que crean nuevos proyectos o portan aplicaciones existentes a dispositivos Meta VR. La guía se centra en las capacidades específicas de Meta VR Glasses. Estas gafas disponen de más memoria de vídeo en el chip que Meta Quest 3. Esta ventaja del hardware permite que el renderizador por teselas (tiled renderer) divida los fotogramas en menos teselas, lo que optimiza el rendimiento. El libro recomienda usar Unity 6.6 y XR Interaction Toolkit en la versión 3.6 o posterior. En Unity Hub hay disponible una plantilla de RV con escenas de ejemplo, assets y ajustes de paquetes recomendados, lo que simplifica la etapa inicial de configuración.Para ejecutar la plantilla en un dispositivo físico, los desarrolladores deben activar el modo de desarrollador, conectar el visor y cambiar la plataforma de compilación a Meta Quest mediante el menú File > Build Profiles. Es fundamental comprobar en Project Settings que estén activados OpenXR y los dos grupos de funciones, Meta y Android XR. Esto garantiza la compatibilidad y mantiene la portabilidad del proyecto. Quienes no tengan un visor pueden usar XR Interaction Simulator, incluido en el paquete XR Interaction Toolkit. Este permite probar las interacciones directamente en el editor. Los usuarios de Windows pueden utilizar Meta Horizon Link para ejecutar las aplicaciones en el dispositivo directamente desde el editor. Así se evita la necesidad de un ciclo completo de compilación y despliegue durante el desarrollo iterativo.Al portar proyectos desde Quest 2 o Quest 3, los desarrolladores deben reevaluar sus estrategias de renderizado foveado. En Meta VR Glasses, el renderizado foveado fijo ofrece un ahorro de recursos menor. Es imprescindible realizar pruebas comparativas para determinar la técnica óptima. Para resolver los cuellos de botella en tareas repetitivas, el nuevo Unity CLI y el paquete Unity Pipeline ofrecen una interfaz de línea de comandos ligera para el editor. El paquete Pipeline convierte el editor en ejecución en un servidor local en segundo plano. Mantiene las escenas y las bases de datos de assets "calientes" en memoria, evitando los retrasos del arranque en frío. Esta configuración permite que agentes de IA capaces de ejecutar comandos de shell, como Claude Code, Codex, Cursor, Copilot y Gemini CLI, controlen el editor, compilen aplicaciones y ayuden a resolver errores.Unity ofrece plugins oficiales para Claude y Codex. Estos enseñan a los agentes a seguir los flujos de trabajo estándar de Unity e instalan 29 habilidades con un solo comando al inicio. Para cerrar el ciclo de verificación, el componente Meta XR Operator permite a los agentes interactuar dentro de la aplicación XR en ejecución. Puede inspeccionar escenas, mover la cabeza y los mandos, realizar gestos como pellizcar, tocar y agarrar, incluido el gaze-and-pinch para Meta VR Glasses, y capturar las vistas renderizadas. Como componente experimental, Meta XR Operator está pensado para el desarrollo y las pruebas, no para dependencias de producción. Los desarrolladores deben seguir probando la comodidad, el tracking y el rendimiento en hardware físico para garantizar una experiencia de usuario sólida.
- Public
- 08 Nov, 2026
Epic Games hace gratuita de forma permanente la biblioteca Megascans y permite el entrenamiento de IA
Epic Games ha hecho oficialmente que toda la biblioteca Quixel Megascans esté disponible para su descarga gratuita, con lo que pone fin al periodo anterior de acceso gratuito limitado. La biblioteca incluye más de 23 000 objetos y materiales 3D de alta calidad, entre ellos más de 8 000 escaneos de objetos reales, como plantas, edificios y utilería, además de 11 000 materiales y texturas escaneados. Este contenido se utiliza ampliamente en el desarrollo de videojuegos, la visualización arquitectónica, el diseño de motion graphics y la producción de efectos visuales. Los assets se distribuyen a través de Fab, el marketplace en línea de Epic, donde las fichfichas individuales se están actualizando para reflejar el nuevo estado gratuito.Publicación en X: https://x.com/quixeltools/status/2118346475528994821La transición al acceso gratuito se está llevando a cabo de forma progresiva, y todos los assets pasarán a ser gratuitos a más tardar el 12 de noviembre de 2026. Los usuarios que compraron assets comerciales de Megascans después del 1 de enero de 2025 recibirán un reembolso, aunque estos créditos se aplican al saldo de la cuenta de Epic y solo pueden usarse para otros productos de Epic. Esta decisión sigue a una historia compleja: Epic adquirió Megascans y Quixel en 2019 y, al principio, ofrecía el contenido de forma gratuita exclusivamente para proyectos en Unreal Engine. A finales de 2024, los assets se hicieron gratuitos durante un breve período para otras aplicaciones y después se empezaron a vender por separado en Fab, pero ahora esa estrategia se ha revertido en favor de un acceso gratuito permanente.La distribución gratuita viene acompañada de un cambio importante: Epic ha actualizado los términos de la licencia para permitir a los desarrolladores entrenar modelos de IA generativa con el contenido de Megascans y Megaplants. Aunque la licencia estándar de assets de Epic se mantiene en gran medida sin cambios, las fichas de estos assets en Fab se han actualizado con la indicación explícita «Permite el uso con IA: Sí». Este cambio es especialmente importante para los desarrolladores de herramientas de IA generativa, ya que les da acceso a datos de entrenamiento de alta calidad que incluyen tipos de objetos, como plantas 3D detalladas, que las herramientas generativas comerciales todavía tienen dificultades para reproducir con alta fidelidad.Esta decisión posiciona a Megascans como un recurso fundamental tanto para los flujos de trabajo 3D tradicionales como para los nuevos procesos basados en IA. Al eliminar las barreras económicas y permitir de forma explícita el entrenamiento de IA, es probable que Epic acelere la integración de escaneos de alta fidelidad en modelos de aprendizaje automático. Ahora los desarrolladores pueden aprovechar toda la amplitud de la biblioteca, tanto para assets de producción como para la creación de conjuntos de datos de IA, sin restricciones de licencia. La actualización garantiza que los equipos que trabajan en juegos, VFX o investigación de IA dispongan de recursos coherentes y de alta calidad, lo que fomenta la innovación tanto en el renderizado en tiempo real como en la síntesis 3D generativa.
- Public
- 06 Nov, 2026
Optimización de mundos construidos por los jugadores: la estrategia de renderizado de SEED en Unity
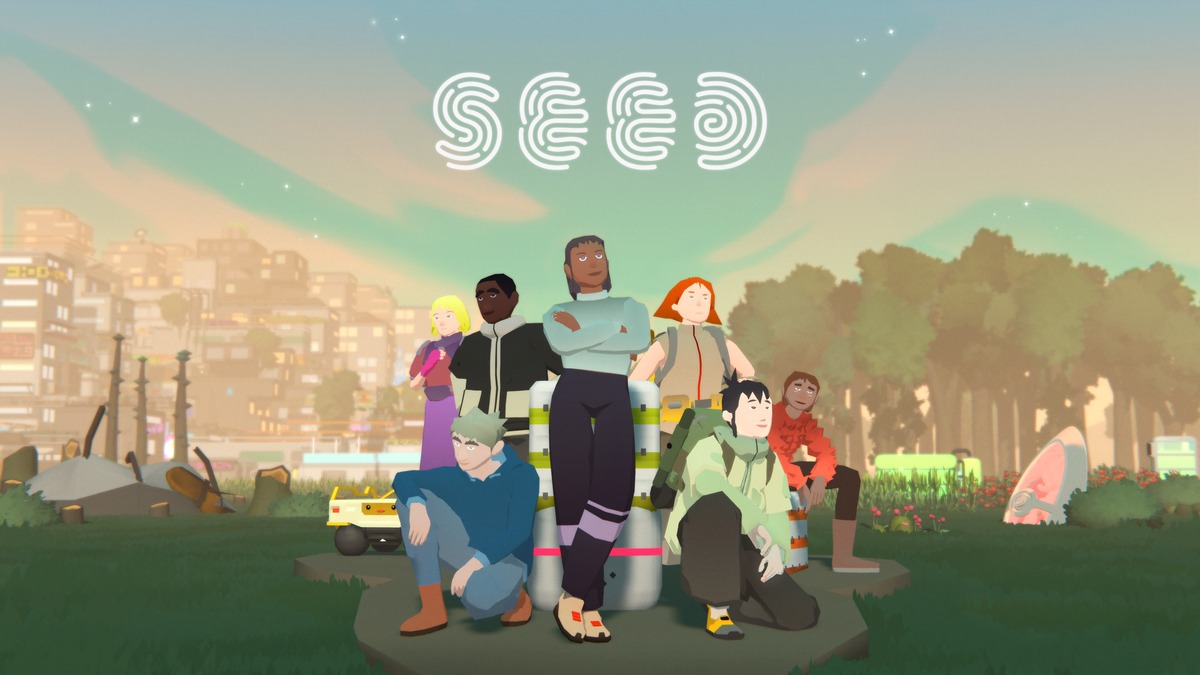
SEED es un sandbox MMO persistente de Klang Games, desarrollado con Unity. La acción transcurre en un planeta lejano, donde los jugadores controlan a personajes autónomos llamados brotes (seedlings). El juego cuenta con una economía dirigida por los jugadores, construcción de sociedad y una expansión continua del mundo que sigue adelante incluso cuando los jugadores se desconectan. Cada nueva construcción, árbol o personaje añadido por los jugadores aumenta la carga de renderizado en el cliente de Unity, que debe procesar este estado dinámico en una amplia gama de hardware, desde PC potentes hasta teléfonos móviles. La simulación se ejecuta en servidores dedicados, mientras que el cliente se encarga de renderizar el estado transmitido en streaming y de enviar las acciones del jugador, como los clics y los movimientos de la cámara.El estilo artístico de SEED es deliberadamente estilizado y de pocos polígonos: la mayor parte de los datos de las superficies se almacena directamente en la geometría y no en texturas. Este enfoque reduce el coste de sombreado y el uso del ancho de banda de memoria, algo fundamental para el rendimiento en dispositivos móviles. Los edificios se construyen con pequeños módulos en forma de ladrillo sobre una cuadrícula de un metro. Cada vóxel colocado por un jugador se expande en unos 15 módulos, y los interiores se generan solo cuando se visualizan. La sociedad más grande de una isla concurrida cuenta con 172 edificios, unos 12 500 vóxeles y 190 000 módulos. Se renderizan con BatchRendererGroup, con tareas que se ejecutan en el C# Job System y se compilan con el compilador Burst, lo que garantiza la eficiencia incluso con una gran cantidad de objetos.Klang Games utiliza Universal Render Pipeline (URP) y sigue de cerca las soluciones estándar de Unity para garantizar la compatibilidad con futuras actualizaciones. El juego funciona actualmente en Unity 6.3, y el equipo actualiza el motor aproximadamente una o dos veces al año para acceder a las nuevas funciones de renderizado. Los efectos personalizados se implementan mediante renderer features propias, en lugar de sustituir URP, lo que permite conservar los mecanismos básicos, como SRP batching y GPU Resident Drawer. Para los elementos de la naturaleza se usa Shader Graph con el shader estándar Lit, y para los personajes, shaders Unlit con un paso de iluminación personalizado. Esta estrategia garantiza que la creación de shader graphs propios no rompa los mecanismos básicos de rendimiento, y ofrece una base estable para un mundo donde los jugadores determinan la complejidad del renderizado.La interacción con un entorno denso, construido por los jugadores, requiere métodos de selección precisos. Con el zoom acercado, el juego usa una selección con precisión de píxel: los objetos se dibujan en un off-screen render target con ID únicos, lo que permite al cliente identificar el objeto exacto que hay bajo el cursor. En los dispositivos móviles, donde la entrada táctil es menos precisa, el sistema comprueba los píxeles circundantes y muestra una lista de selección si detecta varios objetos. Con el zoom alejado, el sistema cambia a raycasts de físicas, y usa Unity Physics para inicializar y consultar una enorme cantidad de colliders de árboles, objetos y ladrillos de edificios. Una tarea que se ejecuta de forma continua determina si los objetos están dentro de edificios para gestionar las capas de renderizado y la iluminación, lo que permite, por ejemplo, desactivar GameObjects o ajustar la visibilidad según la ubicación del jugador dentro de una estructura.La optimización del rendimiento se apoya en gran medida en datos realistas procedentes de instantáneas de servidores en producción, que se restauran de forma local para probar sociedades a gran escala. Este enfoque reveló que en PC el juego suele estar limitado por la CPU debido al envío de draw calls, a pesar de usar GPU Resident Drawer. El problema se debía al fundido cruzado animado de los LOD, que impedía el instancing de los objetos. Al desactivar la parte de animación y usar transiciones manuales, el equipo recuperó el instancing, lo que redujo de forma notable la carga de la CPU. En los dispositivos móviles, la principal limitación es la memoria, no la CPU. Con Memory Profiler, el equipo detectó problemas como texturas duplicadas y colecciones de C# demasiado grandes. Para resolver el uso de memoria de la geometría, sustituyeron los LOD Groups clásicos por Mesh LOD en Unity 6.2. Esta función almacena todos los niveles de detalle en una sola malla, lo que reduce el consumo de memoria y simplifica la gestión de assets en las plataformas móviles.
- Public
- 06 Nov, 2026
Meta Quest Horizon OS 2.10 PTC: modo «Cine» y navegador simplificado
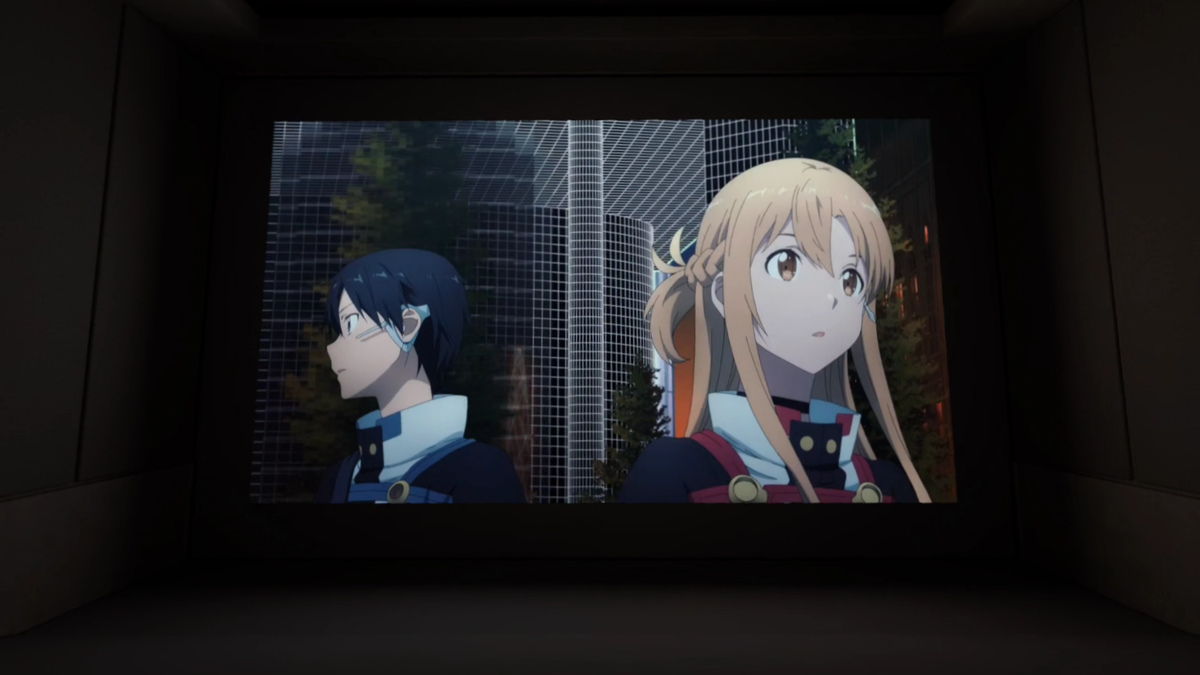
Horizon OS 2.10 (versión 210) ha comenzado a distribuirse en el Public Test Channel (PTC), que funciona como canal beta para las versiones preliminares del software del sistema de Meta Quest. Los usuarios que se unen a este canal reciben compilaciones tempranas del sistema operativo, aunque las funciones del PTC no siempre coinciden con la versión estable final. Algunas funciones pueden retrasarse, eliminarse o implementarse de forma gradual para un grupo limitado de usuarios como parte de experimentos. En ocasiones, Meta ha descrito las funciones de manera inexacta o las ha indicado para versiones que en realidad estaban previstas para lanzamientos posteriores, lo que ha generado cierta confusión sobre los plazos exactos de las nuevas capacidades.La principal novedad de esta actualización es el espacio «Cine», un entorno independiente diseñado para el consumo de contenido multimedia. Esta sala de alta resolución, al estilo de un cine en casa, se abre mediante un nuevo botón en la barra de control de la ventana, distinto de la opción «Foco» ya existente. Al seleccionarla, el sistema cambia a este entorno inmersivo, y al salir, el usuario vuelve al VR Home tradicional o al modo Passthrough. El modo «Cine» admite actualmente iluminación dinámica en tiempo real basada en el contenido que se reproduce, aunque todavía no incluye la función Dynamic Ambiance mencionada anteriormente, que podría llegar en una actualización futura. Las aplicaciones con compatibilidad confirmada son el Media Player del sistema, Browser, YouTube, Disney+ y Amazon Prime Video.Otro cambio significativo es la reorganización del lanzador del sistema, conocido como Navigator, que ha pasado por varias iteraciones durante el último año. Este rediseño, con el nombre en clave Simplified Navigator, consolida la interfaz en tres pestañas principales: Búsqueda, Biblioteca y Notificaciones. Se eliminan varios botones anteriores, entre ellos Me, People, Quick Controls, Show/Hide Windows y las opciones Environment/App, así como los filtros de la izquierda en la pestaña Biblioteca. Ahora se accede a los controles rápidos pulsando el indicador de estado en la parte superior del overlay, que se ha reorganizado en una cuadrícula de botones más grandes, con una nueva opción para alternar entre VR Home y Passthrough.La sección Biblioteca también ha recibido modificaciones sustanciales: las carpetas de aplicaciones al estilo de los smartphones pasan a ser las predeterminadas en la vista de cuadrícula. Se ha añadido una carpeta específica llamada Unknown Sources para las aplicaciones de origen externo (sideloading). Sin embargo, un retroceso notable es la eliminación de la opción de filtrar la Biblioteca para mostrar solo las aplicaciones instaladas o comprobar las actualizaciones disponibles, por lo que ahora se muestra todo el contenido accesible para la cuenta. Este problema se mitiga en parte con una nueva vista de lista (List View), que conserva las opciones de filtrado anteriores. Además, se ha modificado el diseño de los indicadores de privacidad: los permisos activos y usados recientemente ahora se muestran en verde en lugar del morado atenuado.Entre otros cambios no documentados en esta compilación del PTC se incluye un comportamiento mejorado al cambiar el tamaño de las ventanas, que beneficia a las aplicaciones con relación de aspecto fija, como YouTube, al reducir los tirones visuales durante el escalado. Meta también señala que ahora los usuarios pueden hacer videollamadas con su avatar en la aplicación Chats, alternando entre vídeo con avatar y modo solo audio mediante el icono de vídeo de la barra de llamada. Esta función, presentada originalmente como Selfie Camera, podría sentar las bases de las próximas funciones de Hologram Calling. Además, se ha eliminado el interruptor External Microphone del menú experimental, aunque la compatibilidad con micrófonos externos por USB-C parece seguir funcionando sin él.
- Public
- 06 Nov, 2026
Optimización de la inferencia de IA mediante el codiseño de la memoria en todos los niveles de la pila
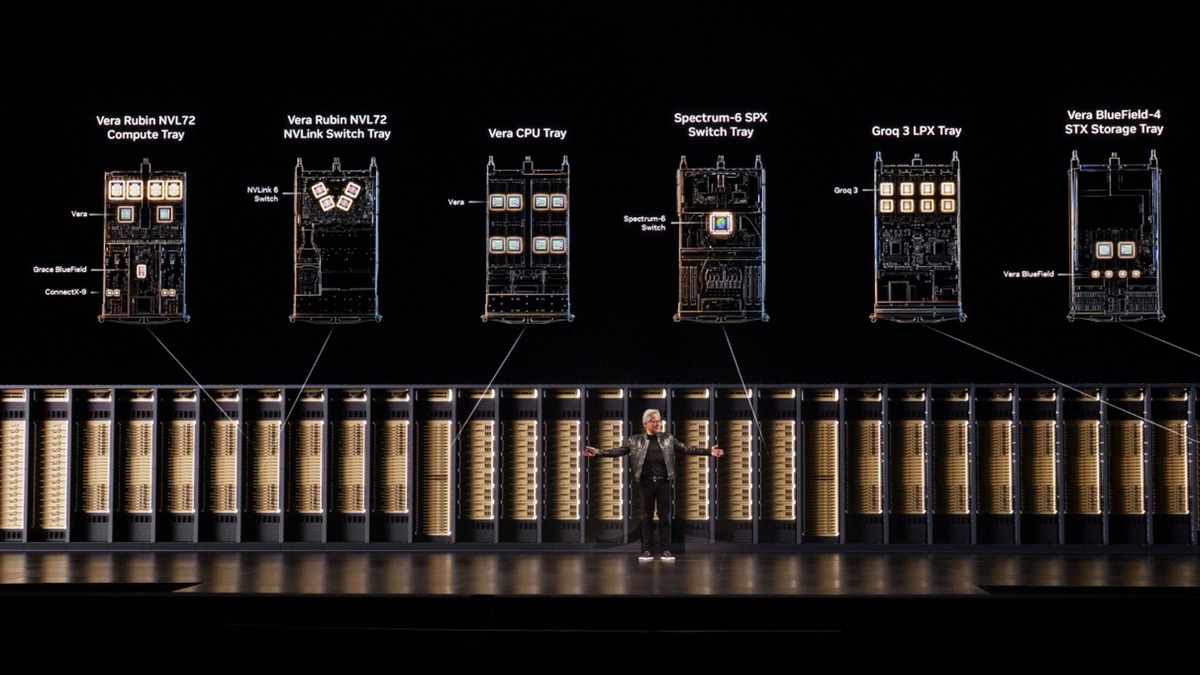
La rápida expansión de los grandes modelos de lenguaje, la ampliación de las ventanas de contexto y el auge de las aplicaciones agénticas ejercen una presión cada vez mayor sobre los recursos de memoria de las GPU. Con el endurecimiento del suministro y el aumento de los precios, el sector se enfrenta a un desafío crítico: cómo procesar más datos sin recurrir simplemente a añadir hardware costoso. NVIDIA aborda este problema abandonando el enfoque tradicional de instalar más memoria High Bandwidth Memory (HBM) en los chips. En su lugar, la compañía aplica una estrategia de codiseño de pila completa (full-stack codesign), en la que las GPU, las CPU, las redes, los sistemas de almacenamiento y el software se desarrollan de forma sincronizada. Este enfoque integral busca extraer el máximo trabajo útil de cada byte de memoria en toda la infraestructura de la fábrica de IA, en lugar de depender únicamente del aumento de la capacidad bruta.El núcleo de esta estrategia consiste en gestionar de forma eficaz la jerarquía de memoria y almacenamiento. En una fábrica de IA, la HBM es el nivel más rápido, pero también el más caro y disputado, y en ella se guardan datos críticos como los pesos del modelo y la caché Key-Value (KV). Por debajo de este nivel se encuentran la memoria de la CPU, los SSD locales y el almacenamiento compartido, que ofrecen mayor capacidad a un coste menor, pero con menos velocidad. La eficiencia del sistema depende de lo bien que se coloquen y se muevan los datos entre estos niveles. Al reducir el tamaño de los pesos del modelo, descargar los contextos inactivos de la caché KV en un almacenamiento más barato y compactar los embeddings de la generación aumentada por recuperación (RAG), NVIDIA consigue que el limitado espacio de la HBM quede reservado para operaciones activas y de alta prioridad. Esto evita el fenómeno del «muro de memoria», en el que las unidades de cálculo esperan datos porque el ancho de banda está saturado, y así se mantiene una latencia baja para los usuarios simultáneos.El impacto de este enfoque de codiseño se aprecia con claridad en las métricas de rendimiento más recientes de las plataformas. Desde la generación Blackwell Ultra hasta la futura plataforma Vera Rubin, la capacidad de HBM por GPU ha aumentado solo un 3 %. Sin embargo, las mejoras de eficiencia son considerables. En el benchmark SemiAnalysis AgentX, el rendimiento de las tareas agénticas por dólar ha aumentado hasta 30 veces. En concreto, NVIDIA GB300 NVL72 ofrece hasta 10 veces más rendimiento por dólar que la plataforma H200 a 100 tokens por segundo por usuario, a pesar de haber duplicado la capacidad de HBM. Se prevé que Vera Rubin NVL72 ofrezca hasta 30 veces más rendimiento por dólar que GB300 NVL72 a 125 tokens por segundo por usuario, con un aumento de la capacidad de HBM de apenas un 3 %. Esto demuestra que optimizar el flujo de datos y su ubicación en el almacenamiento da un resultado mucho mayor que ampliar sin más la capacidad de memoria.Para los operadores de fábricas de IA, la métrica principal es el número de tokens útiles entregados dentro de un presupuesto energético concreto, cumpliendo requisitos estrictos de tiempo de respuesta. Aumentar los tokens por segundo por vatio se traduce directamente en mayores ingresos con la misma infraestructura energética y en un menor coste por token. Al aliviar la presión sobre la HBM causada por los pesos del modelo, el contexto inactivo y los datos de RAG, el codiseño de pila completa garantiza que los recursos de memoria se usen para inferencia activa y no para almacenamiento pasivo. Este método permite a los sistemas manejar billones de parámetros y trayectorias agénticas complejas, que pueden implicar el procesamiento de hasta 3 millones de tokens, sin que el ancho de banda de la memoria suponga un cuello de botella. El resultado es una infraestructura más escalable y rentable, capaz de dar soporte a la próxima generación de aplicaciones de IA.
- Public
- 06 Nov, 2026
Sistema de inteligencia de Android y API de MCP para aplicaciones agénticas
El sistema de inteligencia de Android actúa como la capa base que conecta a los agentes de IA con las aplicaciones en un ecosistema diverso de dispositivos: teléfonos, dispositivos vestibles, gafas XR, televisores y automóviles. La arquitectura está diseñada para proteger la privacidad de los usuarios y permite tanto la asistencia bajo petición como las acciones proactivas. Los desarrolladores obtienen control sobre la integración de las aplicaciones mediante API y herramientas basadas en el conocido estándar Model Context Protocol. El componente central, Android MCP, funciona con la biblioteca Jetpack AppFunctions y sirve como un marco unificado para la llamada a herramientas. Permite la conexión directa con agentes de IA cualificados en el dispositivo y admite tanto al agente del sistema como a agentes locales personalizados dentro de las aplicaciones. Para los escenarios que requieren alcance multiplataforma, hay disponible una opción con servidor MCP remoto, que complementa la solución nativa de Android.Android MCP es la vía de integración recomendada cuando el recorrido del usuario implica cifrado de extremo a extremo, datos locales sensibles del dispositivo o la necesidad de acceder a los sensores y al hardware del dispositivo. También es esencial cuando la ejecución debe realizarse de forma local o cuando no hay ningún endpoint de servidor disponible. Para ampliar las capacidades agénticas íntegramente en el dispositivo, las API de ML Kit GenAI se han actualizado para aprovechar las nuevas funciones de Gemini Nano 4, como la llamada a funciones. Ahora los desarrolladores pueden usar el acceso directo a modelos de ML Kit a través de la Prompt API y la nueva Agentic API. La Agentic API automatiza la ejecución de funciones, guarda el historial de conversación, gestiona el bucle de orquestación e incluye protecciones automáticas para garantizar la seguridad.Para los flujos de trabajo que requieren un enfoque híbrido que combine procesamiento en la nube y local, Firebase AI Logic ofrece una solución sencilla. Esto permite a los desarrolladores llamar a modelos avanzados en la nube, como Gemini 4, y recurrir a la inferencia en el dispositivo con Gemini Nano cuando esté disponible. Para gestionar los costes de producción y proteger las aplicaciones, hay disponibles Firebase App Check, nuevas plantillas de prompts de servidor y límites de gasto de Firebase. Además, el renderizador Jetpack Compose A2UI ya está en alfa y permite que los agentes transmitan interfaces nativas de Compose, ricas e interactivas, directamente desde un protocolo JSON. Esta capacidad permite a los agentes «hablar el lenguaje de la interfaz» y crear interfaces dinámicas sin escribir manualmente el código de diseño.Connected Apps Platform introduce una forma de llegar a usuarios con una intención alta a través de las superficies de Gemini y Search. Esta plataforma combina Android MCP, para la ejecución nativa en el dispositivo, con servidores MCP remotos para un alcance multiplataforma más amplio. Los desarrolladores pueden empezar hoy mismo a crear y probar de forma local con Gemini Apps Developer Mode. Para el despliegue en producción hay disponible una lista de espera de la versión preliminar, limitada por ahora a aplicaciones seleccionadas y listas para producción en las categorías compatibles; está previsto ofrecer más adelante un acceso de autoservicio más amplio. Este cambio refleja una transformación más amplia en el comportamiento de los usuarios: pasar de hacer preguntas a realizar acciones directas mediante experiencias de aplicaciones integradas.