Optimización de la inferencia de IA mediante el codiseño de la memoria en todos los niveles de la pila
 Public
- 06 Nov, 2026
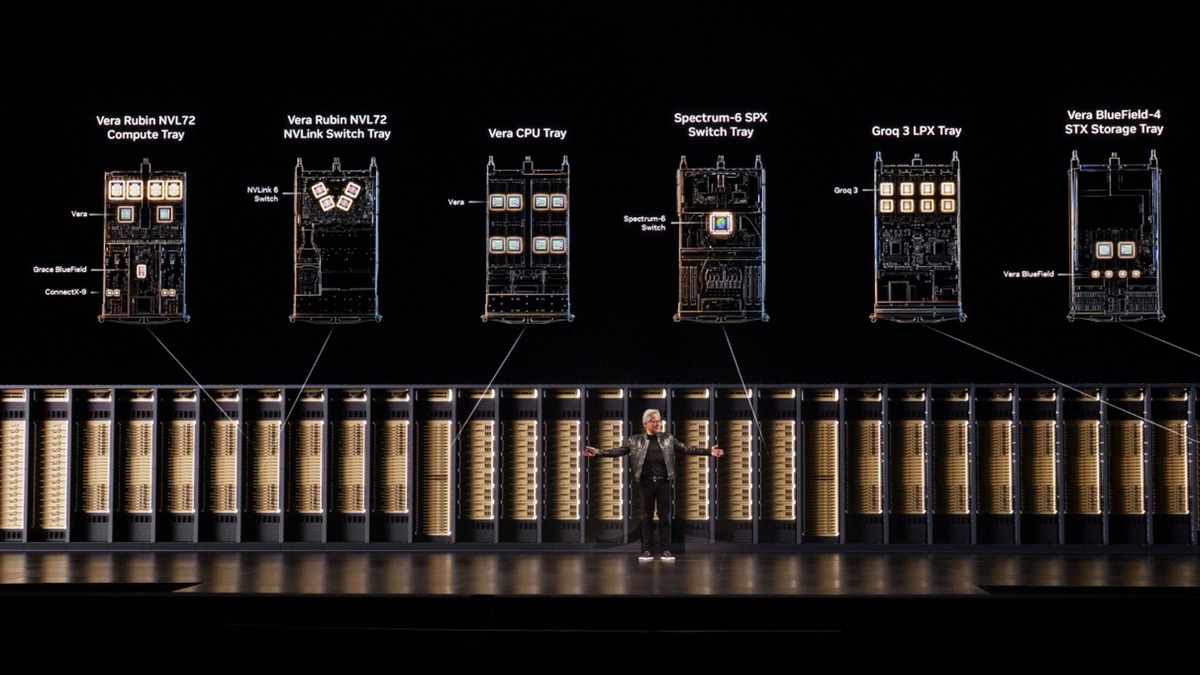
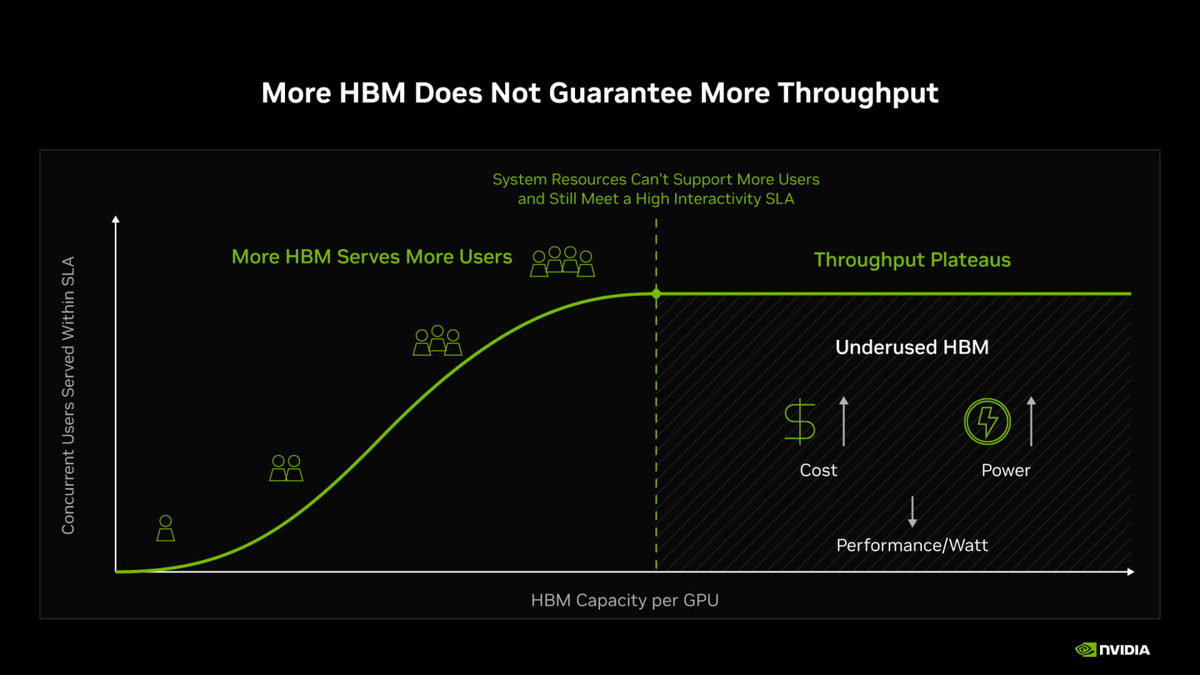
La rápida expansión de los grandes modelos de lenguaje, la ampliación de las ventanas de contexto y el auge de las aplicaciones agénticas ejercen una presión cada vez mayor sobre los recursos de memoria de las GPU. Con el endurecimiento del suministro y el aumento de los precios, el sector se enfrenta a un desafío crítico: cómo procesar más datos sin recurrir simplemente a añadir hardware costoso. NVIDIA aborda este problema abandonando el enfoque tradicional de instalar más memoria High Bandwidth Memory (HBM) en los chips. En su lugar, la compañía aplica una estrategia de codiseño de pila completa (full-stack codesign), en la que las GPU, las CPU, las redes, los sistemas de almacenamiento y el software se desarrollan de forma sincronizada. Este enfoque integral busca extraer el máximo trabajo útil de cada byte de memoria en toda la infraestructura de la fábrica de IA, en lugar de depender únicamente del aumento de la capacidad bruta.
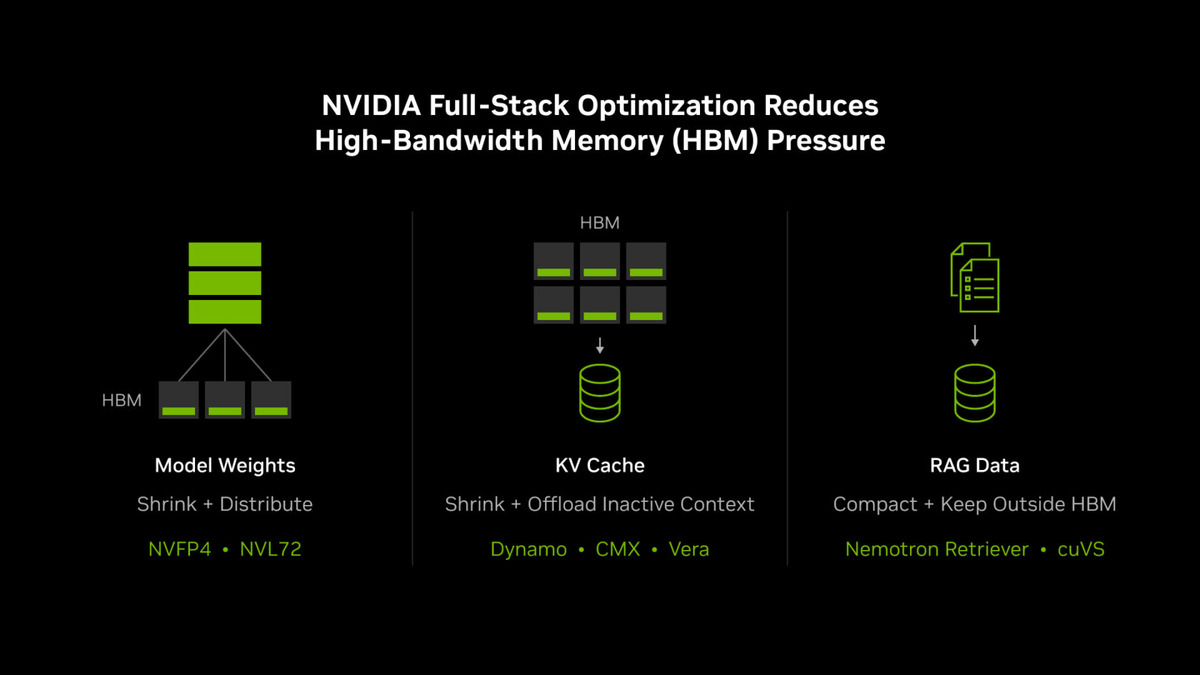
El núcleo de esta estrategia consiste en gestionar de forma eficaz la jerarquía de memoria y almacenamiento. En una fábrica de IA, la HBM es el nivel más rápido, pero también el más caro y disputado, y en ella se guardan datos críticos como los pesos del modelo y la caché Key-Value (KV). Por debajo de este nivel se encuentran la memoria de la CPU, los SSD locales y el almacenamiento compartido, que ofrecen mayor capacidad a un coste menor, pero con menos velocidad. La eficiencia del sistema depende de lo bien que se coloquen y se muevan los datos entre estos niveles. Al reducir el tamaño de los pesos del modelo, descargar los contextos inactivos de la caché KV en un almacenamiento más barato y compactar los embeddings de la generación aumentada por recuperación (RAG), NVIDIA consigue que el limitado espacio de la HBM quede reservado para operaciones activas y de alta prioridad. Esto evita el fenómeno del «muro de memoria», en el que las unidades de cálculo esperan datos porque el ancho de banda está saturado, y así se mantiene una latencia baja para los usuarios simultáneos.
El impacto de este enfoque de codiseño se aprecia con claridad en las métricas de rendimiento más recientes de las plataformas. Desde la generación Blackwell Ultra hasta la futura plataforma Vera Rubin, la capacidad de HBM por GPU ha aumentado solo un 3 %. Sin embargo, las mejoras de eficiencia son considerables. En el benchmark SemiAnalysis AgentX, el rendimiento de las tareas agénticas por dólar ha aumentado hasta 30 veces. En concreto, NVIDIA GB300 NVL72 ofrece hasta 10 veces más rendimiento por dólar que la plataforma H200 a 100 tokens por segundo por usuario, a pesar de haber duplicado la capacidad de HBM. Se prevé que Vera Rubin NVL72 ofrezca hasta 30 veces más rendimiento por dólar que GB300 NVL72 a 125 tokens por segundo por usuario, con un aumento de la capacidad de HBM de apenas un 3 %. Esto demuestra que optimizar el flujo de datos y su ubicación en el almacenamiento da un resultado mucho mayor que ampliar sin más la capacidad de memoria.
Para los operadores de fábricas de IA, la métrica principal es el número de tokens útiles entregados dentro de un presupuesto energético concreto, cumpliendo requisitos estrictos de tiempo de respuesta. Aumentar los tokens por segundo por vatio se traduce directamente en mayores ingresos con la misma infraestructura energética y en un menor coste por token. Al aliviar la presión sobre la HBM causada por los pesos del modelo, el contexto inactivo y los datos de RAG, el codiseño de pila completa garantiza que los recursos de memoria se usen para inferencia activa y no para almacenamiento pasivo. Este método permite a los sistemas manejar billones de parámetros y trayectorias agénticas complejas, que pueden implicar el procesamiento de hasta 3 millones de tokens, sin que el ancho de banda de la memoria suponga un cuello de botella. El resultado es una infraestructura más escalable y rentable, capaz de dar soporte a la próxima generación de aplicaciones de IA.