NVIDIA Green Contexts: partición explícita de los recursos de la GPU para tareas concurrentes
 Public
- 07 Oct, 2026
Las aplicaciones de GPU modernas suelen ejecutar varios componentes independientes dentro de un mismo proceso. Por ejemplo, operadores sensibles a la latencia conviven con kernels en segundo plano orientados al rendimiento. Estos componentes normalmente comparten una sola GPU, lo que provoca interferencias impredecibles y contención de recursos. Los contextos tradicionales de CUDA se diseñaron para una época en la que las GPU atendían una única carga de trabajo dominante. Por eso resultan pesados y poco adecuados para una partición fina de los recursos. Generan una sobrecarga considerable de hardware en los cambios de contexto y carecen de mecanismos para definir explícitamente cómo se reparten los recursos de ejecución entre las tareas concurrentes.
Green contexts resuelven este problema al permitir que las aplicaciones seleccionen de forma explícita un subconjunto de los recursos de ejecución de la GPU y dirijan el trabajo directamente a ellos. Disponibles en la Driver API desde CUDA 12.4, ahora también lo están a través de la Runtime API a partir de CUDA 13.1. Esta función permite a los desarrolladores definir dónde se ejecuta el trabajo y cómo se reparten los recursos dentro de un proceso. El caso de uso principal es la partición de SM, en la que se asignan Streaming Multiprocessors concretos a un green context. Así, varias cargas de trabajo pueden ejecutarse de forma simultánea sin competir por las mismas unidades de cómputo.
Más allá de la asignación de SM, los green contexts pueden aprovisionar recursos de colas de trabajo. En el modelo tradicional, las cargas de trabajo independientes ordenadas por stream podían asignarse a las mismas colas de trabajo subyacentes, lo que causaba una serialización no deseada incluso cuando había recursos de ejecución suficientes. Al aprovisionar explícitamente las colas de trabajo, los green contexts permiten a las aplicaciones expresar la concurrencia esperada y eliminar las dependencias falsas. Crear y destruir estos contextos tiene un coste bajo, y su ciclo de vida no sincroniza de forma implícita trabajo de GPU no relacionado. Esto proporciona un modelo de programación más explícito que depender del estado implícito del dispositivo.
El modelo de programación pasa de un direccionamiento implícito a uno explícito. Históricamente, las aplicaciones usaban cudaSetDevice y creaban streams cuyo destino de ejecución se deducía del estado actual del dispositivo asociado al hilo. Con los green contexts, representados por el tipo cudaExecutionContext_t, los desarrolladores crean un contexto para un conjunto de recursos elegido y luego crean streams a partir de él mediante cudaExecutionCtxStreamCreate. Esto garantiza que el trabajo enviado a esos streams quede asociado estrictamente a los recursos del green context. Para las aplicaciones que se dirigen a todo el dispositivo, el modelo tradicional sigue disponible a través de cudaDeviceGetExecutionCtx, lo que asegura la compatibilidad con versiones anteriores y una adopción gradual.
Un caso de uso típico es el solapamiento de la comunicación con los kernels GEMM en el entrenamiento distribuido, o el manejo de operadores sensibles a la latencia en plataformas de sensores de IA. La prioridad de los streams por sí sola no basta cuando los kernels voluminosos ocupan todos los SM, ya que el planificador no puede interrumpir los bloques en ejecución. Los green contexts reservan SM específicos para el trabajo crítico, sin esperar a que terminen los bloques voluminosos. Las pruebas en una GPU NVIDIA Blackwell con 148 SM mostraron que, mientras la prioridad de los streams ofrece una mejora de 27 veces frente a streams de igual prioridad, los green contexts proporcionan una reducción adicional de la latencia de 20 veces al garantizar recursos dedicados al kernel crítico.
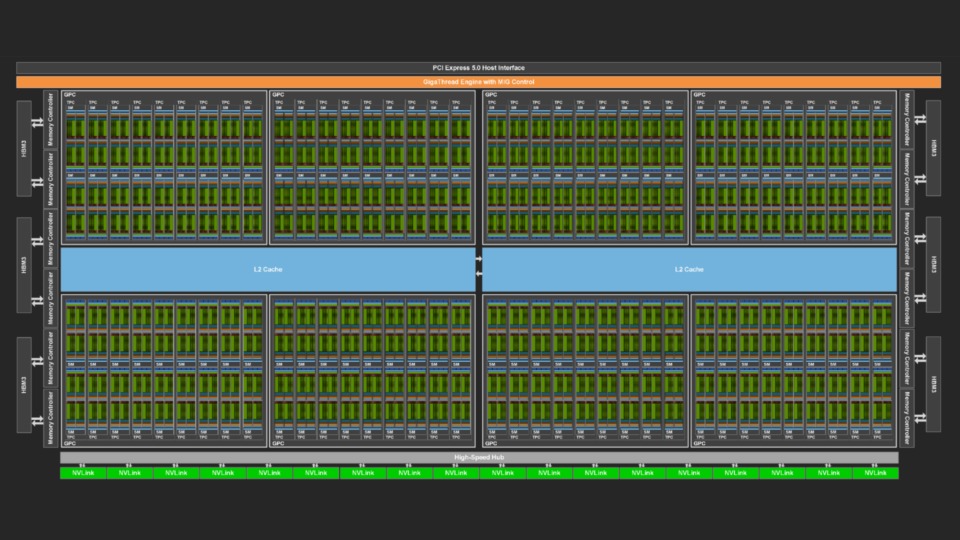
La implementación consiste en consultar los recursos del dispositivo, dividir los SM en grupos críticos y restantes, y empaquetar cada uno con configuraciones específicas de colas de trabajo. Los desarrolladores usan cudaDevSmResourceSplit para separar los recursos y cudaDevResourceGenerateDesc para crear los descriptores. Los green contexts son opcionales y aditivos: permiten que las aplicaciones existentes sigan usando todo el dispositivo mientras incorporan un control más fino donde haga falta. Este enfoque es especialmente útil para alcanzar los objetivos de concurrencia o latencia en flujos de trabajo complejos, y ofrece un mecanismo robusto para gestionar el reparto de recursos de la GPU en aplicaciones modernas de varios componentes.