NVIDIA cuPhoton acelera el análisis de imágenes astronómicas con una canalización nativa de GPU
 Public
- 07 Oct, 2026
Los instrumentos científicos de alto rendimiento, como los observatorios, los telescopios y las fuentes de rayos X, generan datos de imagen a una velocidad que supera la capacidad de las canalizaciones limitadas por la CPU. El cuello de botella computacional rara vez es un único kernel lento; más bien, es todo el recorrido desde los datos sin procesar del sensor hasta la decisión científica, que incluye la lectura de datos, la correspondencia de funciones de dispersión del punto, la sustracción del fondo, el ajuste de modelos y la clasificación de objetos. Las instalaciones modernas acumulan petabytes de datos multidimensionales por campaña, y las implementaciones que dan prioridad a la CPU pueden tardar entre horas y meses en ofrecer resultados útiles a partir de datos generados en segundos. Este retraso dificulta obtener conclusiones científicas a tiempo. NVIDIA cuPhoton resuelve este problema al ofrecer una ruta nativa de GPU que cubre todas las etapas, desde la lectura del sensor hasta la clasificación, reduce el tiempo de espera a segundos y permite a los investigadores trabajar en ciclos interactivos ágiles.
NVIDIA cuPhoton es un kit de herramientas de código abierto NVIDIA CUDA-X, formado por bloques de construcción acelerados por GPU para la astronomía espectral y óptica, así como para el análisis láser y de rayos X en el dominio temporal. Al mantener los datos de imagen en la GPU desde la lectura inicial del sensor hasta la clasificación final, el kit de herramientas reduce de forma significativa la latencia. Por ejemplo, el Observatorio Vera C. Rubin (NSF-DOE) registra una nueva exposición de 3,2 gigapíxeles cada 39 segundos después de que oscurece. Su pipeline Prompt Processing debe clasificar unas 10 000 detecciones como transitorios astrofísicos o artefactos en un plazo de 60 a 120 segundos. En una sola noche, esto supone hasta 20 terabytes de imágenes y 10 millones de objetos candidatos. cuPhoton escala en sistemas NVIDIA Grace Blackwell y Vera Rubin con varias GPU y varios nodos, y acelera la carga de imágenes hasta 14 900 veces y el procesamiento de señales hasta 14 550 veces en cargas de trabajo representativas que implican cientos de terabytes.
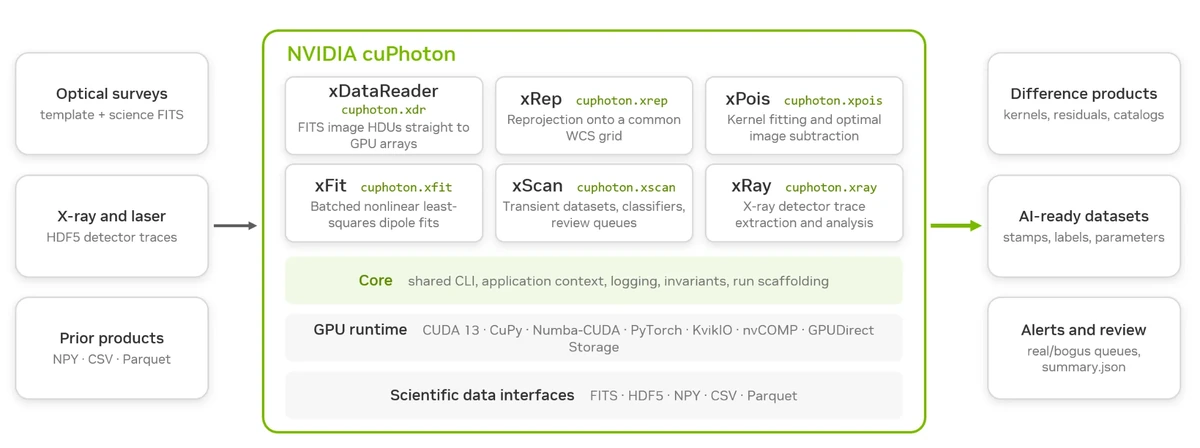
El kit de herramientas incluye cinco componentes principales para el flujo de trabajo con imágenes: xDataReader, xRep, xPois, xFit y xScan, además de xRay para el análisis de detectores de rayos X en el dominio temporal. Para la configuración es necesario clonar el repositorio y aprovisionar un entorno Linux bloqueado con el comando uv sync --locked --extra dev --extra gpu --extra viz. Este entorno admite el ecosistema NVIDIA CUDA 13, que incluye CuPy, PyTorch, Numba-CUDA, KvikIO y NVIDIA nvCOMP, junto con bibliotecas de visualización como Bokeh y Pillow. La versión 0.1.3 de cuPhoton admite de Python 3.12 a 3.14 en Linux. Compilar el componente xDataReader desde el código fuente requiere un compilador C++17, los encabezados de desarrollo de CUDA y cuFile, y una instalación de desarrollo reentrante de CFITSIO. El script completo del flujo de trabajo está disponible en el repositorio para ejecuciones automatizadas o para uso interactivo en cuadernos Jupyter.
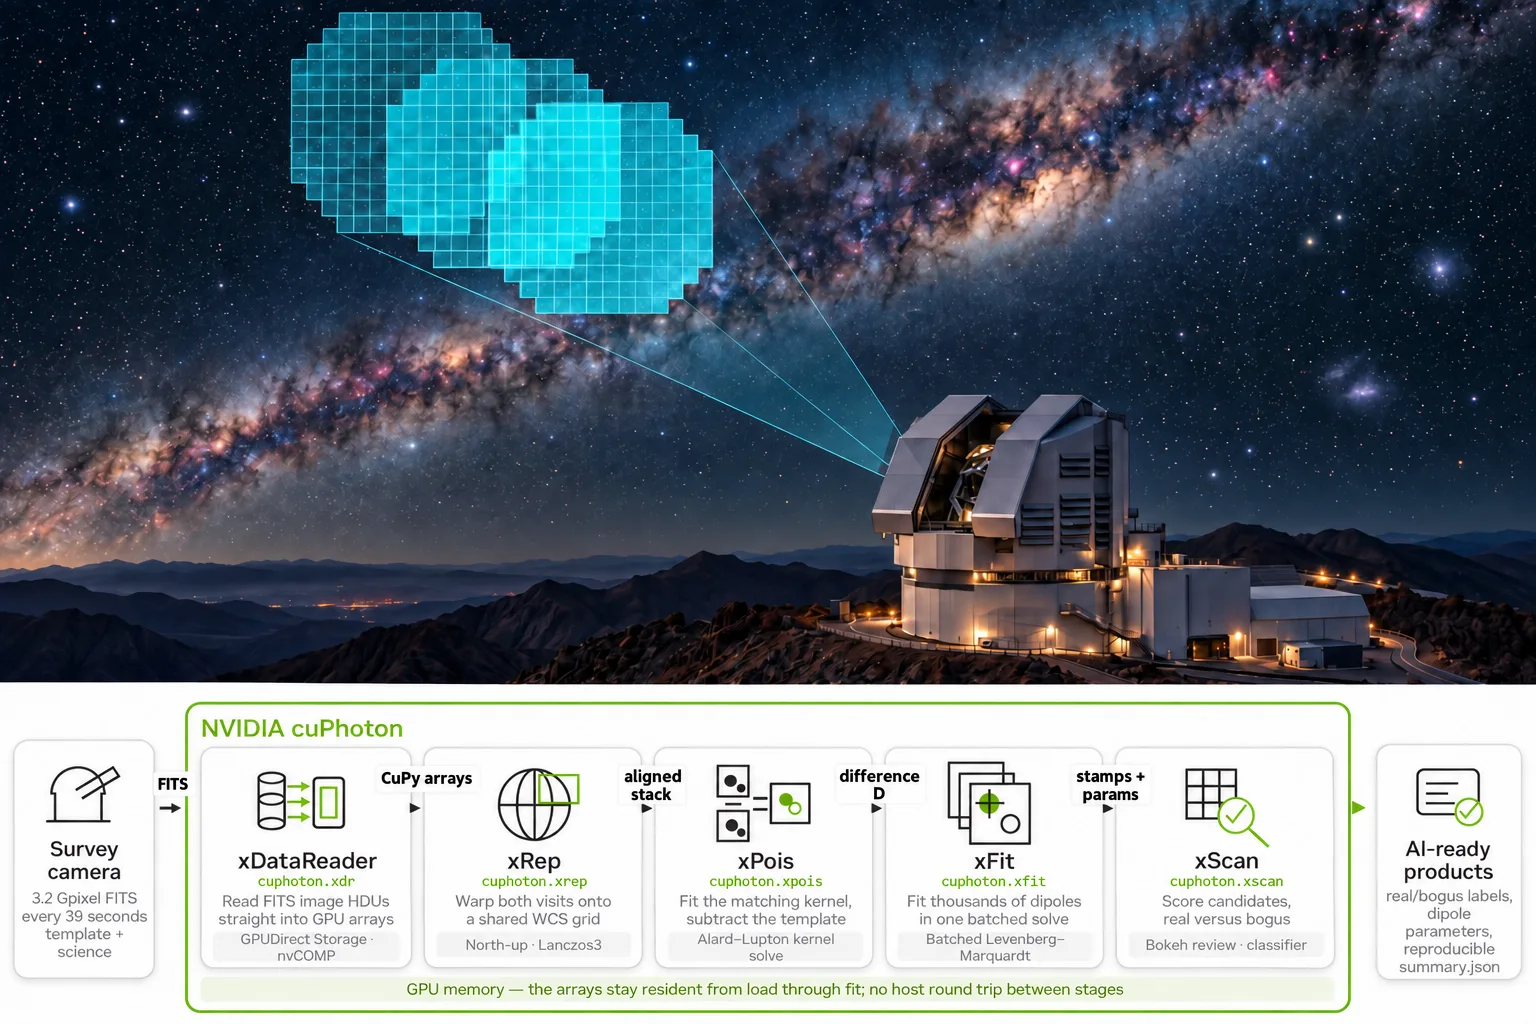
El módulo xDataReader acelera la carga de archivos en formato Flexible Image Transport System (FITS) directamente en la GPU, evitando la sobrecarga tradicional del análisis sintáctico en la CPU y de la transferencia por PCIe. Divide la carga de trabajo: CFITSIO planifica los rangos de bytes en la CPU, KvikIO los lee mediante GPUDirect Storage (cuando está disponible) y nvCOMP descomprime las teselas GZIP en la GPU. La función pública de la API batch_to_device devuelve pilas de arreglos de CuPy, y admite HDU de imagen sin comprimir de 2 a 16 ejes e imágenes bidimensionales con compresión por teselas GZIP_1 o GZIP_2. La compresión Rice y la cuantización de coma flotante con dithering no son compatibles. Para las imágenes del HDU primario, los usuarios deben pasar hdu_indices=(0,), mientras que por defecto se usa el índice de HDU 1. Los archivos agrupados en una misma llamada deben coincidir en forma y tipo de datos en cada HDU seleccionado.
El módulo xRep remuestrea imágenes bidimensionales sobre una cuadrícula celeste común con orientación norte arriba, con el fin de alinear visitas que no comparten una cuadrícula de píxeles debido al dithering, a la rotación o a diferencias en la escala de placa. La función build_stack_spec_from_fits lee las soluciones del sistema de coordenadas mundiales de las cabeceras FITS para construir una huella de destino, mientras que reproject_stack deforma cada elemento sobre esa cuadrícula. El parámetro backend tiene por defecto el valor "auto", que da preferencia a CuPy, después a PyTorch con CUDA y, por último, a la CPU si no hay ninguna GPU disponible. La interpolación usa Lanczos-3 por defecto. Esta alineación garantiza que las estrellas estáticas de la plantilla y de los fotogramas científicos ocupen las mismas coordenadas, lo que permite aislar la fuente en movimiento como la única posición modificada en el cielo antes de la sustracción.