Optimierung der KI-Inferenz durch gemeinsames Design des Speichers auf allen Ebenen des Stacks
 Public
- 06 Nov, 2026
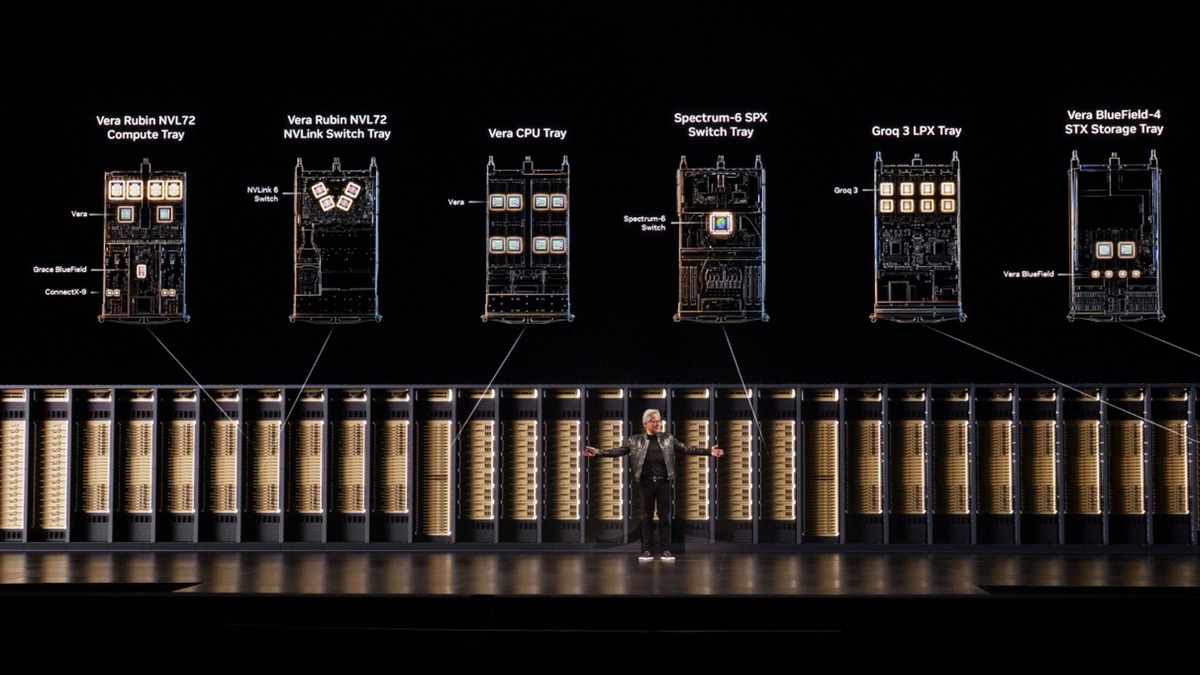
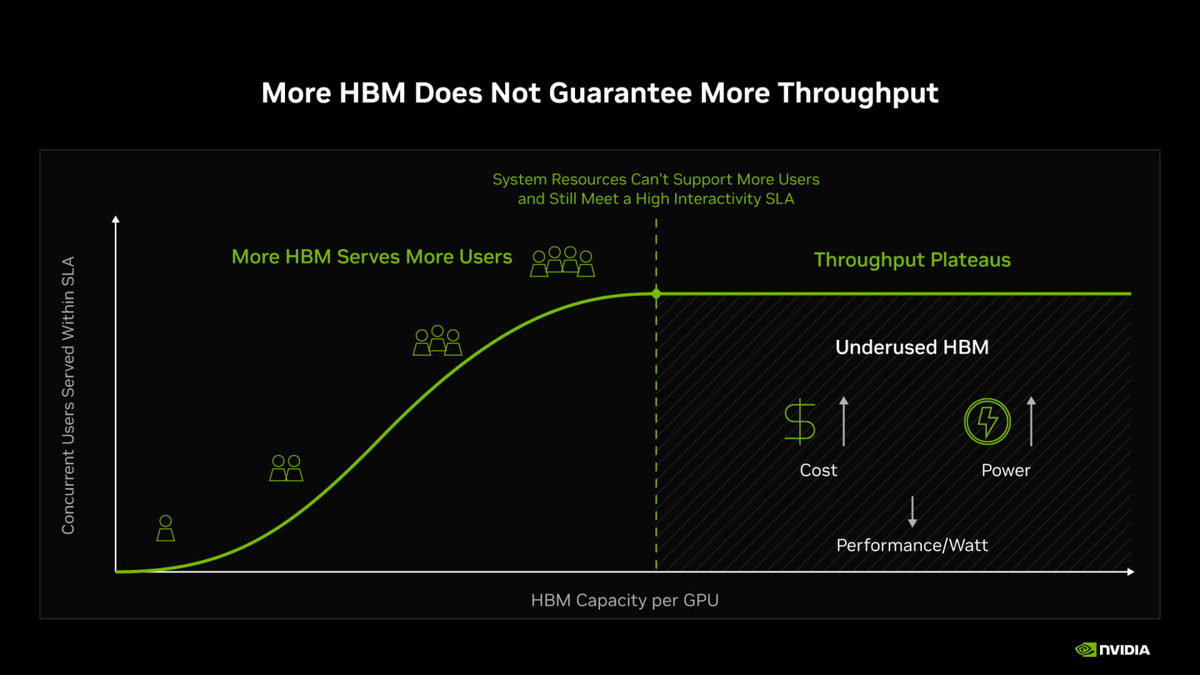
Die rasante Ausweitung großer Sprachmodelle, die Vergrößerung der Kontextfenster und das Wachstum agentischer Anwendungen üben einen immer stärkeren Druck auf die GPU-Speicherressourcen aus. Angesichts knapper werdender Lieferbedingungen und steigender Preise steht die Branche vor einer kritischen Herausforderung: Wie kann mehr Daten verarbeitet werden, ohne einfach teure Hardware hinzuzufügen? NVIDIA geht diesem Problem entgegen, indem es den traditionellen Ansatz verlässt, der auf das Aufbringen größerer Mengen an High Bandwidth Memory (HBM) auf Chips basiert. Stattdessen setzt das Unternehmen auf eine Strategie des vollständigen gemeinsamen Designs (full-stack codesign), bei der GPUs, CPUs, Netzwerk, Speicher und Software gemeinsam entwickelt werden. Dieses ganzheitliche Ziel besteht darin, die maximale nützliche Arbeit aus jedem Byte Speicher in der gesamten KI-Fabrik-Infrastruktur zu extrahieren, anstatt sich ausschließlich auf die Erhöhung der Rohkapazität zu verlassen.
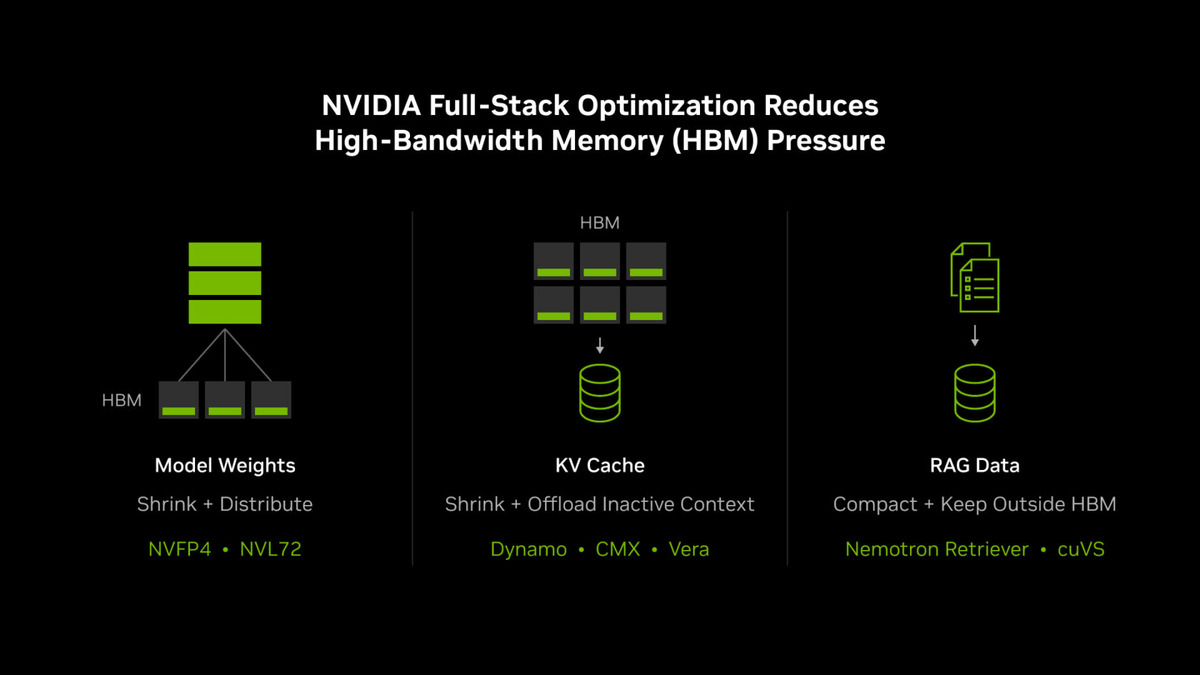
Der Kern dieser Strategie liegt in der effektiven Verwaltung der Speicher- und Storage-Hierarchie. In einer KI-Fabrik dient HBM als die schnellste, aber teuerste und umkämpfteste Ebene, die kritische Daten wie Modellgewichte und den Key-Value (KV)-Cache speichert. Unterhalb dieser Ebene befinden sich der CPU-Speicher, lokale SSDs und geteilter Speicher, die eine größere Kapazität zu geringeren Kosten bieten, jedoch mit reduzierter Geschwindigkeit. Die Effizienz des Systems hängt davon ab, wie gut Daten zwischen diesen Ebenen platziert und bewegt werden. Indem NVIDIA den Fußabdruck der Modellgewichte verkleinert, inaktive KV-Cache-Kontexte in günstigere Speicher auslagert und die Embeddings für Retrieval-Augmented Generation (RAG) komprimiert, stellt das Unternehmen sicher, dass der begrenzte HBM-Speicherplatz für aktive, hochpriorisierte Operationen reserviert bleibt. Dies verhindert das Phänomen der "Speicherwand", bei dem Recheneinheiten auf Daten warten, weil die Bandbreite gesättigt ist, und hält so die Latenz für gleichzeitige Nutzer niedrig.
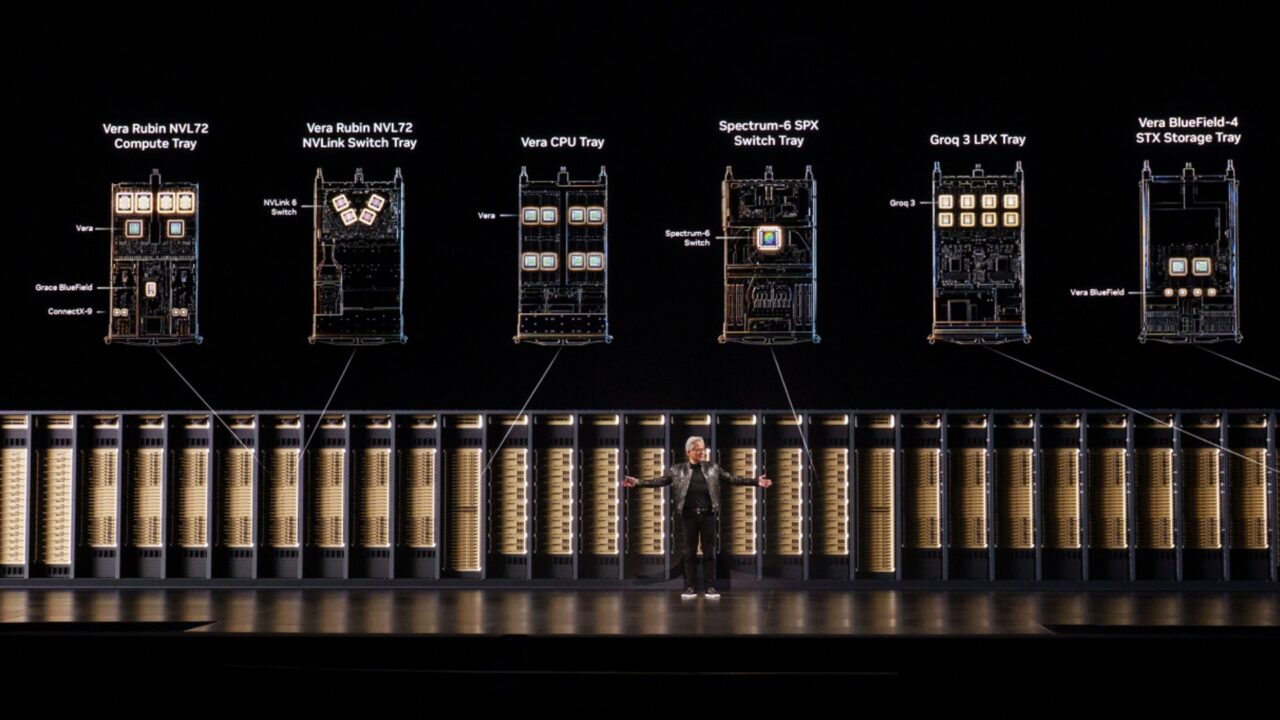
Die Auswirkungen dieses Codesign-Ansatzes sind in den aktuellen Leistungskennzahlen der Plattformen deutlich sichtbar. Von der Blackwell-Ultra-Generation bis zur kommenden Vera-Rubin-Plattform ist die HBM-Kapazität pro GPU um nur etwa 3 % gestiegen. Die Effizienzgewinne sind jedoch erheblich. Im SemiAnalysis-AgentX-Benchmark ist die Durchsatzrate für agentische Aufgaben pro Dollar um bis zu 30-fach gestiegen. Genauer gesagt liefert die NVIDIA GB300 NVL72 bei 100 Token pro Sekunde pro Nutzer eine bis zu 10-fach höhere Durchsatzrate pro Dollar im Vergleich zur H200-Plattform, trotz einer Verdopplung der HBM-Kapazität. Die Vera Rubin NVL72 soll bei 125 Token pro Sekunde pro Nutzer eine bis zu 30-fach höhere Durchsatzrate pro Dollar als die GB300 NVL72 liefern, wobei die HBM-Kapazität nur um 3 % zunimmt. Dies zeigt, dass die Optimierung des Datenflusses und der Speicherplatzierung eine deutlich höhere Rendite bringt als eine einfache Erweiterung der Speicherkapazität.
Für Betreiber von KI-Fabriken ist die zentrale Kennzahl die Anzahl der nützlichen Token, die innerhalb eines bestimmten Energiebudgets unter Einhaltung strenger Anforderungen an die Antwortzeit geliefert werden. Eine Erhöhung der Token pro Sekunde pro Watt führt direkt zu höheren Einnahmen aus derselben Energieinfrastruktur und zu geringeren Kosten pro Token. Indem der Druck auf den HBM durch Modellgewichte, inaktiven Kontext und RAG-Daten reduziert wird, stellt das Full-Stack-Codesign sicher, dass Speicherressourcen für aktive Inferenz und nicht für passive Speicherung genutzt werden. Diese Methode ermöglicht es Systemen, Billionen von Parametern und komplexe agentische Trajektorien zu verarbeiten, die die Verarbeitung von bis zu 3 Millionen Token umfassen können, ohne durch die Speicherbandbreite limitiert zu werden. Das Ergebnis ist eine skalierbarere und kosteneffizientere Infrastruktur, die in der Lage ist, die nächste Generation von KI-Anwendungen zu unterstützen.