CUDA-Bildverarbeitungs-Pipeline optimieren: von Bugs bis zu Benchmarks
 Public
- 02 Sep, 2026
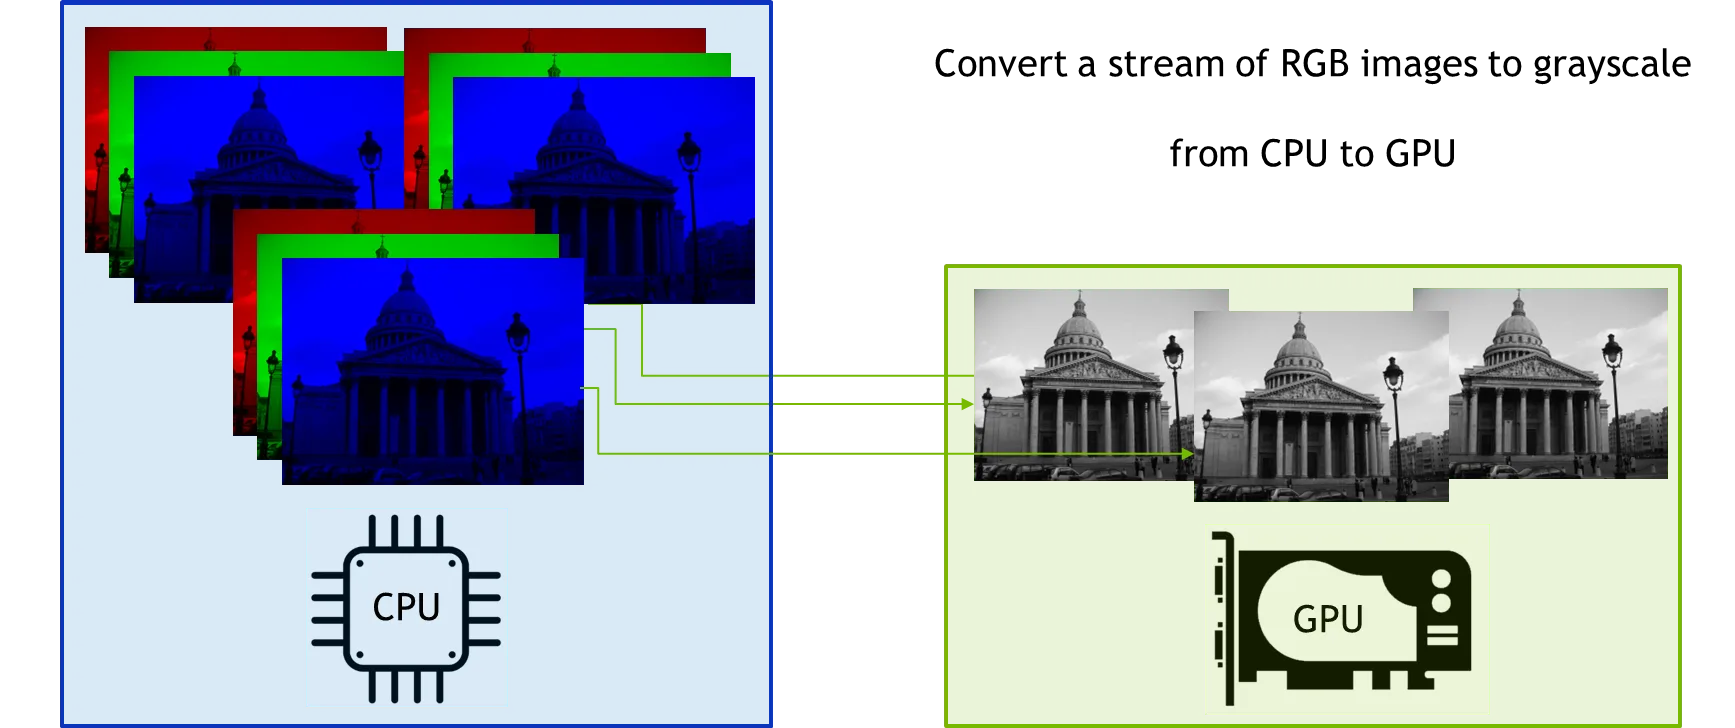
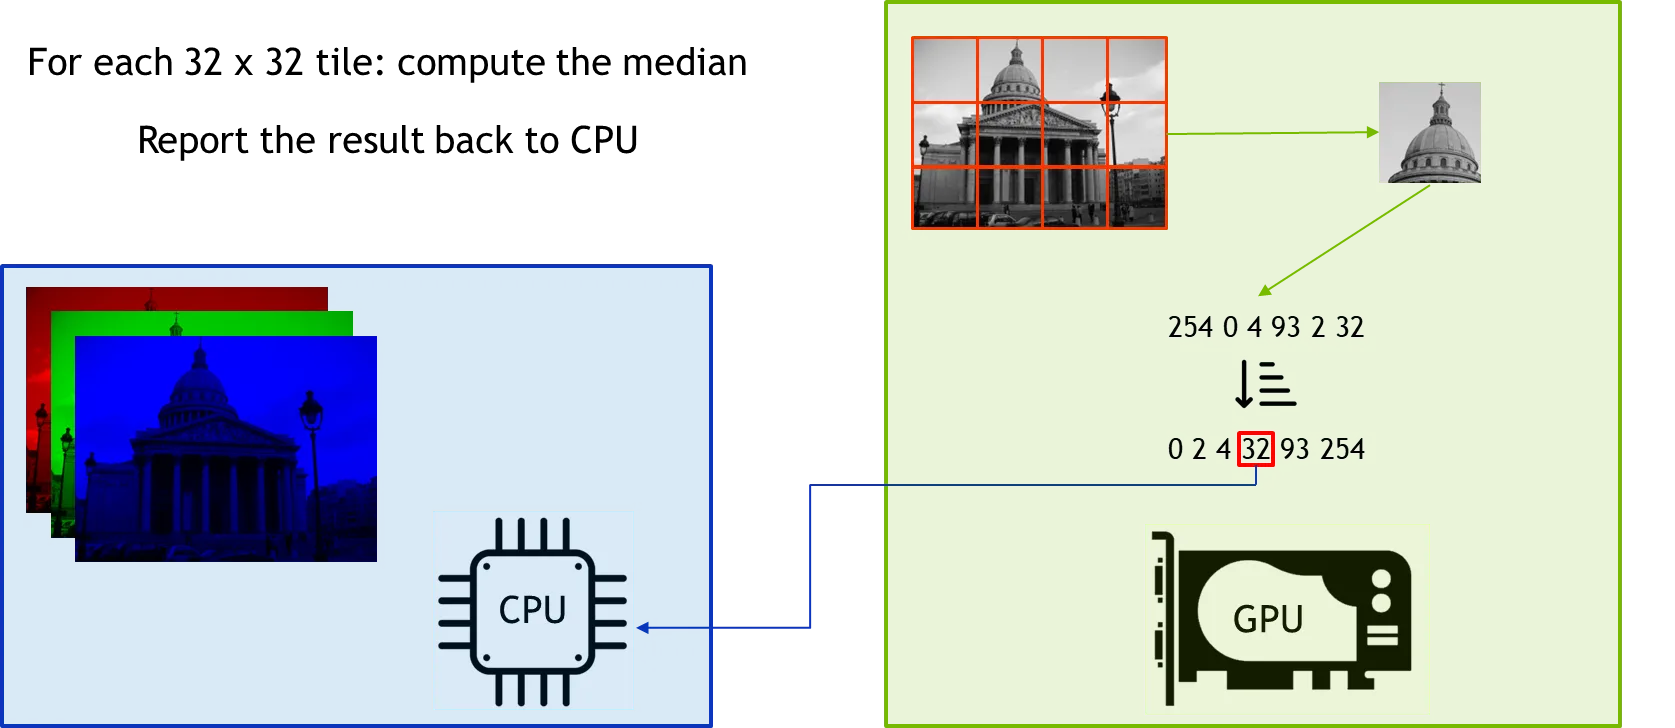
In diesem praktischen CUDA-Beispiel wird ein Strom roter, grüner und blauer Bilder verarbeitet: Zuerst werden die Daten von der CPU auf die GPU kopiert, von RGB in Graustufen umgewandelt, anschließend wird jede Kachel von 32 mal 32 Pixeln sortiert, damit ihr Median berechnet werden kann, und am Ende werden die Mediane zurück auf den Host kopiert. In der Ausgangsimplementierung sind zwei Kernel definiert — computeRGBToGray für die Farbumwandlung und computeMedian<TILE_WIDTH, HISTO_SIZE> für den Median pro Kachel — und main reserviert Speicher, startet die Kernel und gibt Ressourcen innerhalb einer parallelen OpenMP-Schleife über drei Bilder frei.
Im Median-Kernel verbirgt sich ein subtiler, aber gravierender Fehler. Das Schreiben in den gemeinsamen Speicher tile[index] = d_image_gray[index] verwendet fälschlicherweise einen globalen Index, um in den Shared Memory zu schreiben, der auf einen Thread-Block beschränkt ist. Beim Ausführen der Binärdatei tritt der Fehler „illegal memory access“ auf, und compute-sanitizer die Ursache exakt an: ein Schreibzugriff außerhalb des __shared__ um ein Byte in Zeile 55, festgestellt für den Thread (0,3,0) im Block (20,0,0).
Um solche Indexierungsfehler zu vermeiden, hat NVIDIA in CCCL eine neue Launch-API eingeführt. Kernel werden über cuda::make_config, cuda::block_dims, cuda::grid_dims und cuda::launchgestartet; anschließend übernimmt der Kernel die Konfiguration als ersten Parameter und verwendet cuda::gpu_thread.index(cuda::grid, config) und cuda::gpu_thread.index(cuda::block, config), um globale und Block-Indizes getrennt zu ermitteln. Rohe Zeiger lassen sich außerdem durch cuda::std::span, cuda::std::mdspan und cuda::shared_memory_mdspanersetzen, die im Debug-Modus bei Zugriffen außerhalb des Arrays Assertions auslösen.
Sobald der Code fehlerfrei ist, wird er mit Nsight Systems gemessen. Die Instrumentierung des Codes mit NVTX-Bereichen — etwa nvtx3::scoped_range und nvtxRangePushA/nvtxRangePop — macht die Zeitachse leichter lesbar und zeigt, dass der Median-Kernel das Profil dominiert: Er benötigt etwa 2,1 Sekunden pro Bild und ist für 98,5 % der GPU-Zeit verantwortlich, während Speicheroperationen nur 1,5 % ausmachen.
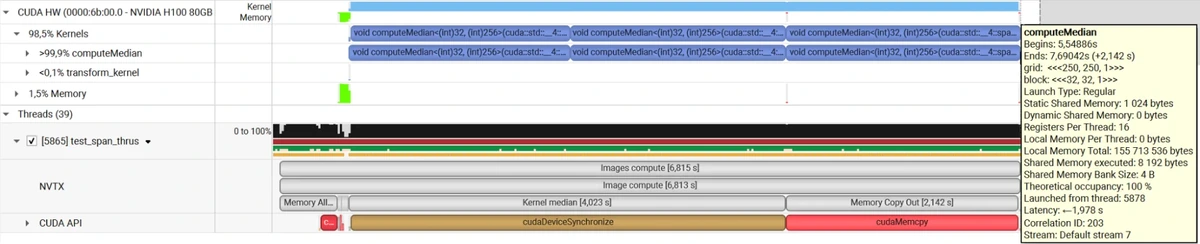
Auf der CPU-Seite dauert die gesamte Phase der Bildberechnung 6,8 Sekunden, und fast all diese Zeit entfällt auf die Median-Kernel. Diese Zeitachse gibt Entwicklern ein klares Ziel für die nächsten Optimierungsschritte vor: Die Medianberechnung ist bei Weitem der teuerste Teil der Pipeline, und die nachfolgenden Schritte der Anleitung konzentrieren sich genau auf ihre Verbesserung.