NVIDIA TensorRT 11.1: Global Performance Tuner für die automatische Optimierung von Engines unter Berücksichtigung der Genauigkeit
 Public
- 24 Oct, 2026
Das Deployment von neuronalen Netzen ist im Wesentlichen eine Kompilieraufgabe, bei der es keine einzelne optimale Strategie für alle Modelle gibt. Wenn NVIDIA TensorRT eine Inferenz-Engine erstellt, trifft es voneinander abhängige Entscheidungen bezüglich Graphentransformationen, Kernel-Fusion, Speicherplatzierung und Quantisierung. Dieser Prozess, bekannt als Scheduling, beeinflusst die endgültige Inferenzleistung erheblich. Verschiedene Scheduling-Optionen können die Semantik des Modells beibehalten, aber völlig unterschiedliche Geschwindigkeitsergebnisse liefern. Da diese Effekte gekoppelt und modellabhängig sind, treten sie oft erst nach dem vollständigen Build und der Messung der Engine zutage. Dies macht die Vorhersage der besten Strategie zunehmend schwieriger, je vielfältiger die Modelle und Deployment-Umgebungen werden.
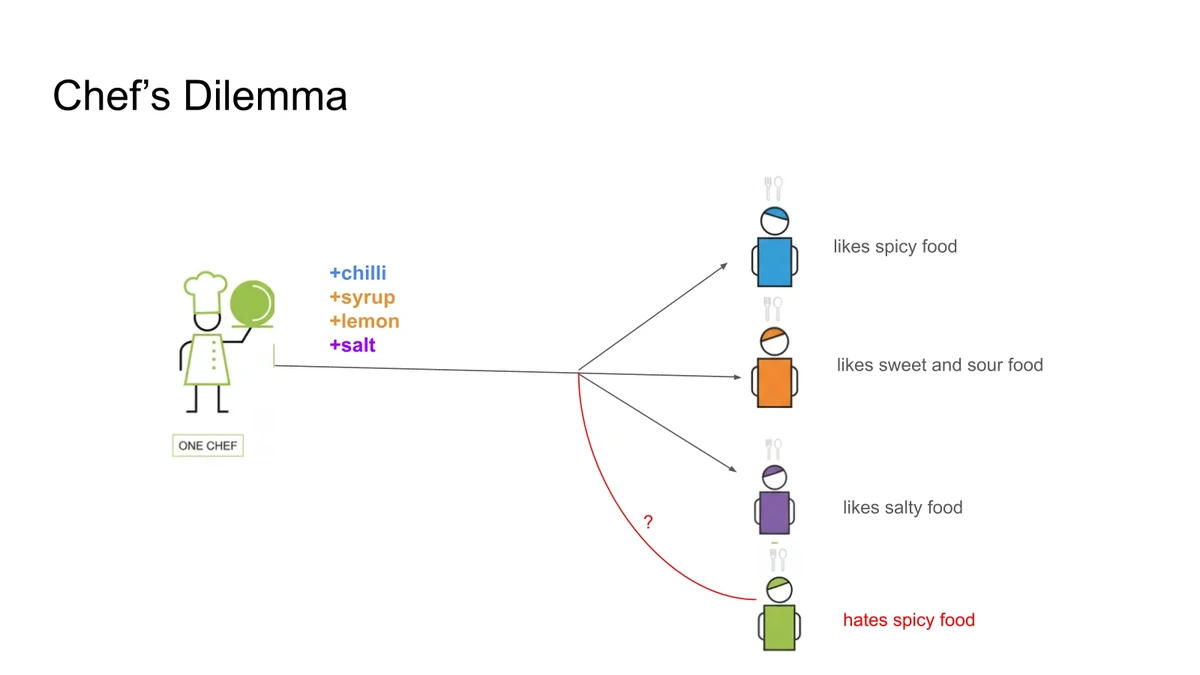
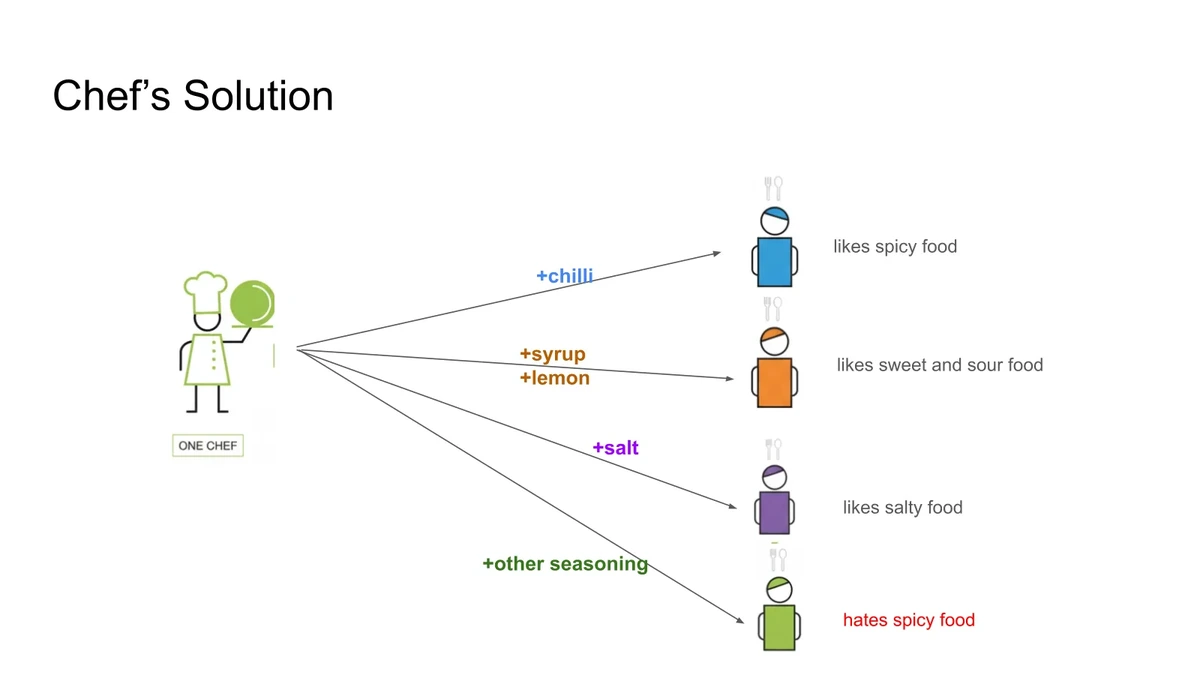
Historisch stützte sich TensorRT auf interne Modelle für Schlüsselkennzahlen (KPI), um optimierbare Muster zu identifizieren, die anschließend als Heuristiken in der Standard-Scheduling-Strategie kodiert wurden. Obwohl dies es den Nutzern ermöglichte, automatisch von Expertenwissen zu profitieren, entstand ein Skalierungsproblem. Eine für einen bestimmten Modelltyp entwickelte Heuristik konnte bei einem anderen Typ zu Leistungseinbußen führen, was zusätzliche Ausnahmen erforderte. Dies machte die Scheduling-Logik komplex und schwer erweiterbar. Der Global Performance Tuner, der in TensorRT 11.1 eingeführt wurde, löst dieses Problem, indem er auf ein einzelnes festes Rezept verzichtet. Stattdessen betrachtet er die Compiler-Pipeline als Basisrezept mit anpassbaren „Gewürzen“, was es dem System ermöglicht, den Optimierungsanpassungspfad an die spezifischen Merkmale des Eingabemodells anzupassen, sei es ein ONNX-Graph oder ein über die TensorRT-API erstelltes Netzwerk.
Um diesen Ansatz zu formalisieren, verwendet das System einen mathematischen Rahmen, der die Generierung von Kandidatenlösungen von ihrer Auswahl trennt. Der Modellraum besteht aus allen möglichen Eingaben, während der Lösungsraum alle ausführbaren Ausgaben enthält, wie z. B. TensorRT-Engines oder serialisierte GPU-Kernel-Sequenzen. Ein Builder-Algorithmus bildet ein Modell auf einen Satz von Kandidatenlösungen ab, der durch einen Schwellenwert für die Genauigkeitstoleranz begrenzt ist. Dieser Schwellenwert stellt sicher, dass die Eingabe-Ausgabe-Paare innerhalb akzeptabler Grenzen bleiben und verhindert, dass aggressive Optimierungen die Anforderungen der Anwendung verletzen. Das Ziel des Builders besteht darin, einen umfangreichen Satz von Kandidaten zu generieren, der die optimale Lösung enthält, definiert als die schnellste zulässige Ausführung, die die Genauigkeitskriterien erfüllt. Diese Abstraktion ermöglicht eine strenge Analyse, wie sich verschiedene Build-Pfade auf die finale Laufzeit auswirken.
Ein Suchalgorithmus arbeitet anschließend mit diesem Kandidatensatz, um die beste Lösung auszuwählen. Im Idealfall würde dieser Algorithmus eine Brute-Force-Evaluation aller Kandidaten durchführen, um den mit der minimalen Laufzeit zu finden. In der Praxis begrenzen jedoch oft Zeitbudgets für den Build die Tiefe dieser Suche. Der gesamte Compiler wird somit als Tupel aus Builder und Searcher dargestellt. Die Herausforderung liegt darin, einen optimalen Builder zu konstruieren, der die global optimale Lösung erreichbar macht. Da es keinen einzelnen universellen Build-Pfad für alle Modelle gibt, muss das System anpassbare Build-Pfade unterstützen. Das bedeutet, dass die Sequenz der Compiler-Pässe, die Zwischenrepräsentationen in finale ausführbare Dateien umwandeln, variieren kann. Verschiedene Modelle können ihre beste Leistung durch unterschiedliche Transformationssequenzen erreichen, selbst auf derselben Ziel-GPU.
Der Global Performance Tuner nutzt diese anpassbaren Build-Routen für die automatische Leistungsoptimierung. Für jeden Kandidaten, der von verschiedenen Routen generiert wurde, validiert der Tuner die Ausgaben anhand des festgelegten Genauigkeitskriteriums. Anschließend misst er die End-to-End-Inferenzleistung der zulässigen Lösungen. Unter allen Kandidaten, die die Genauigkeitsanforderungen erfüllen, wählt das System den mit der geringsten Laufzeit. Dieser Ansatz stellt sicher, dass Leistungsgewinne nicht auf Kosten der Modelltreue erzielt werden. Indem der Kompilierungsprozess als Suche über mehrere mögliche Build-Routen und nicht als einzelner fester Pfad betrachtet wird, bietet TensorRT 11.1 eine skalierbare Methode zur Optimierung von Deep-Learning-Workloads über verschiedene Modelle und Hardware-Konfigurationen hinweg.
Diese Methodik behebt die Kernbeschränkung früherer Ansätze, bei denen eine Änderung für ein Modell die Leistung für ein anderes Modell verschlechtern konnte. Indem die Basis-Pipeline stabil gehalten, aber die Scheduling-Entscheidungen anpassbar gemacht werden, kann das System neue Modelle mit unbekannten Präferenzen effektiv verarbeiten. Es bietet verschiedene Optimierungsvarianten an, lehnt jene ab, die die Genauigkeitsprüfungen nicht bestehen, und behält die leistungsfähigste Konfiguration bei. Dies ist vergleichbar mit einem Koch, der einem neuen Kunden kostenlose Proben anbietet, um die bevorzugte Gewürzkombination zu finden, anstatt ein einzelnes Standardrezept aufzuzwingen. Das Ergebnis ist ein robusterer Kompilierungsprozess, der sich an die spezifischen Bedürfnisse jedes neuronalen Netzes anpasst und sicherstellt, dass Entwickler die höchste mögliche Inferenzgeschwindigkeit erhalten, ohne die erforderliche Präzision ihrer Anwendungen zu beeinträchtigen.