NVIDIA Snapshot verkürzt den Start von GPU-Workloads auf Sekunden
 Public
- 11 Nov, 2026
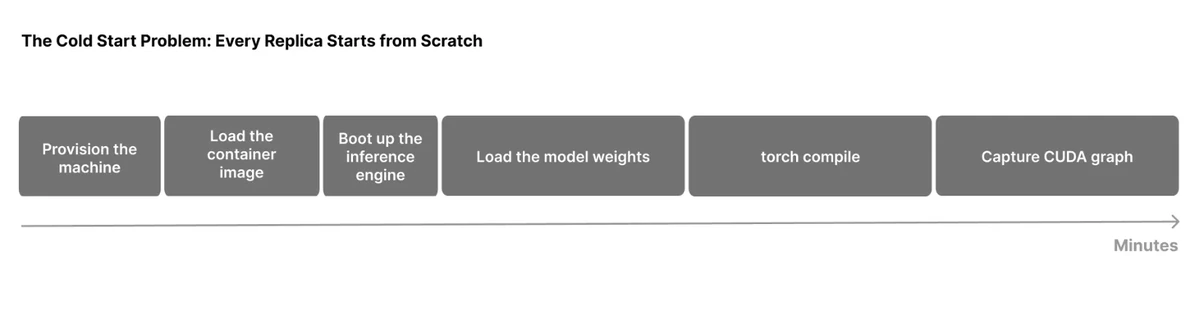
NVIDIA hat Snapshot vorgestellt, eine offene Komponente der Plattform NVIDIA DSX AI Factory Platform, die es ermöglicht, initialisierte GPU-Workloads über verschiedene Inferenz-Replikate hinweg wiederzuverwenden. Das Problem ist allen bekannt, die LLMs betreiben: Wenn die Nachfrage stark steigt oder eine Replikation ausfällt, werden freie GPUs nicht sofort zu Kapazität für die Bedienung, weil die Initialisierung eines LLM-Workloads, der Kaltstart, Minuten dauern kann. Snapshot ist ein System für Checkpoints und Wiederherstellung für GPU-Workloads in Kubernetes. Es speichert einen vollständig initialisierten Workload einschließlich CPU- und GPU-Speicher und stellt diesen Zustand auf kompatibler Infrastruktur wieder her, wodurch Inferenzkapazität in Sekunden statt in Minuten ins Netz gebracht wird. Die Bereitstellung der Infrastruktur und das Laden des Container-Images sind nicht Teil des gemessenen Wiederherstellungspfads.
Das Tool bietet zwei Operationen für GPU-Pods, beide werden über Kubernetes-Custom-Resources gesteuert. Um einen Checkpoint eines laufenden Pods zu speichern, erstellt man ein PodSnapshot mit dessen Namen; um einen Pod aus einer Vorlage zu starten und seinen Checkpoint sofort zu speichern, sobald er bereit ist, erstellt man stattdessen ein SnapshotJob. Wiederherstellung bedeutet, die Annotation nvidia.com/restore-from zu einem neuen Pod hinzuzufügen und das PodSnapshot anzugeben, aus dem wiederhergestellt werden soll. Der Workload selbst benötigt nur einen kleinen Handshake, um vor dem Erstellen des Checkpoints zu pausieren und nach der Wiederherstellung fortzufahren, und im Repository gibt es fertige Beispiele für vLLM, SGLang und NVIDIA TensorRT LLM. Snapshot kann kompatible Workloads, die mehrere GPUs auf einem einzigen Knoten umfassen, als ein einziges Artefakt über alle Ränge hinweg speichern und wiederherstellen - das ermöglicht einen schnellen Start großer Mixture-of-Experts-Modelle mit Tensor-Parallelismus, Daten- und Experten-Parallelismus sowie Decode-Context-Parallelismus, sofern der Workload die Kompatibilitätsanforderungen für Checkpoints, Wiederherstellung und Laufzeitumgebung erfüllt.
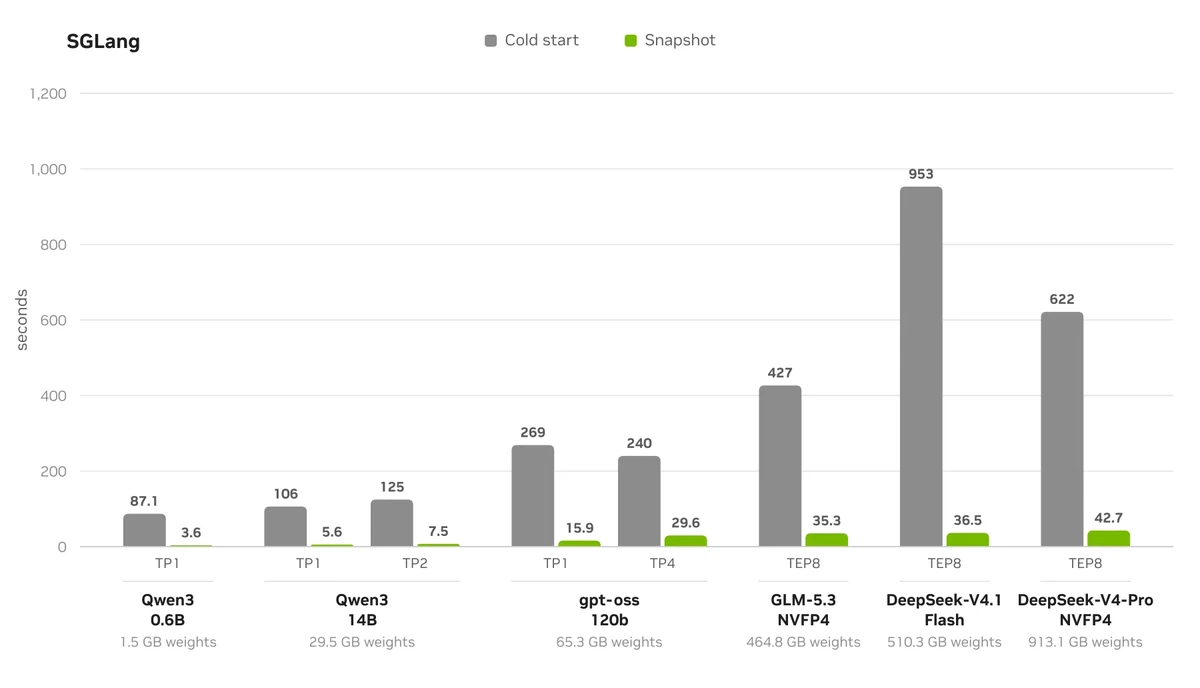
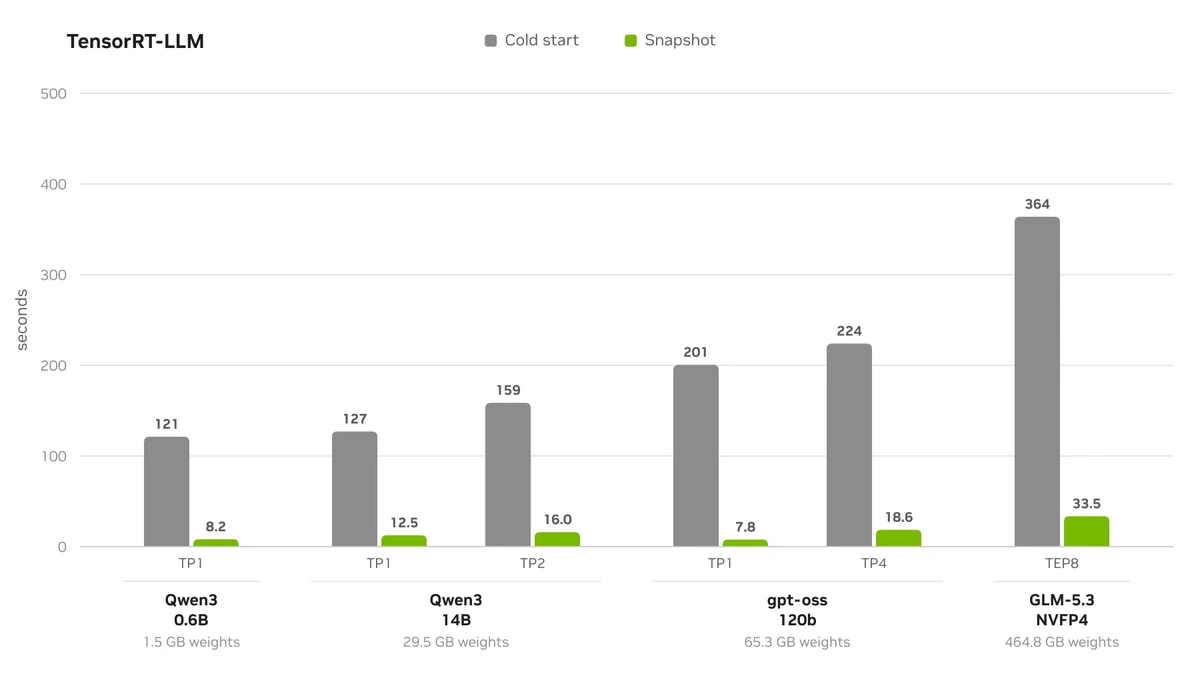
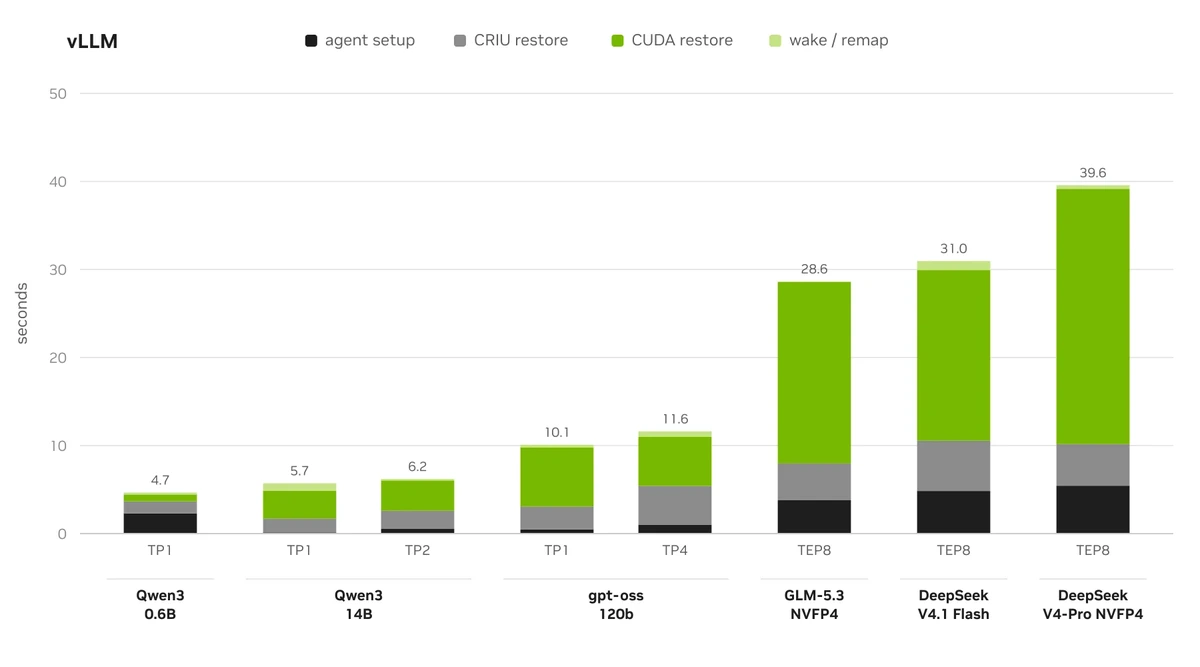
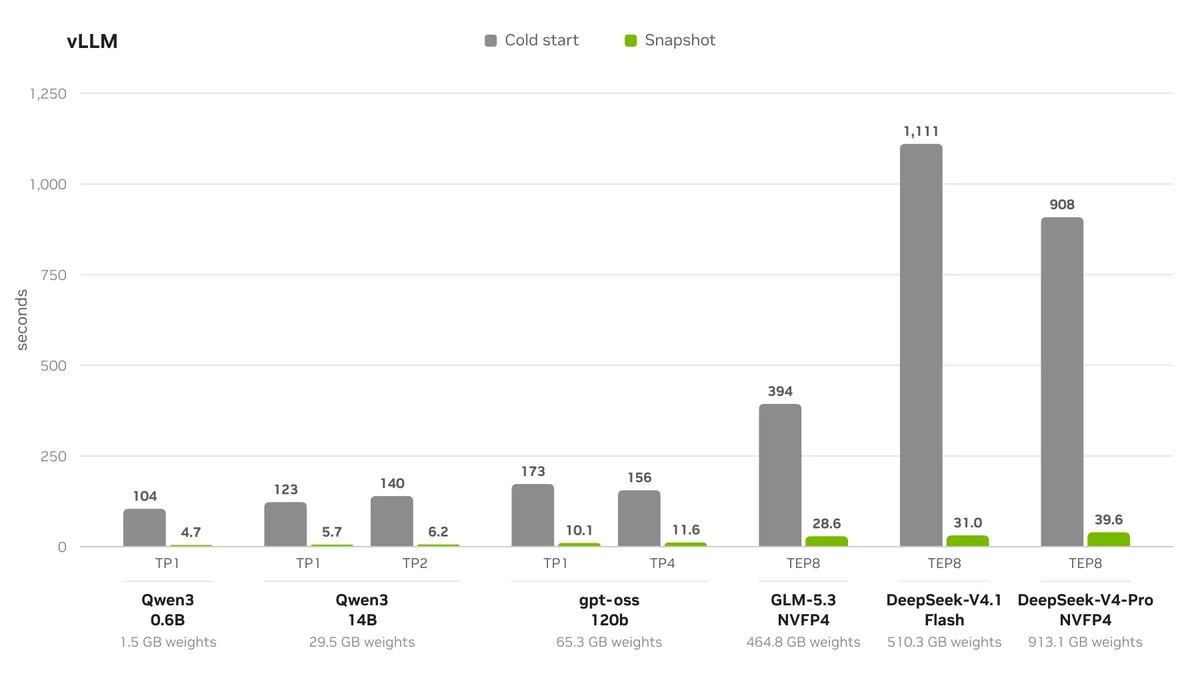
Die Benchmarks umfassen Modelle von 600 Millionen Parametern bis hin zu MoE-Modellen mit 1-TB-Checkpoints auf 8 GPUs; die Tests wurden auf identischer Hardware und identischem Software-Stack nach zwei Strategien durchgeführt: Kaltstart gegenüber Wiederherstellung aus Snapshot. In allen getesteten Konfigurationen bringt Snapshot eine Replik in weniger als 45 Sekunden zurück, 8- bis 36-mal schneller als ein Kaltstart. Nach Engines liegen die Wiederherstellungsbereiche so: vLLM - 4,7 bis 39,6 Sekunden, SGLang - 3,6 bis 42,7 Sekunden, TensorRT LLM - 7,79 bis 33,55 Sekunden. Beide Messungen berücksichtigen weder das Laden des Container-Images noch die Einrichtung der Container-Laufzeitumgebung, und die Freigabe des KV-Cache wird vor jedem Checkpoint ausgelöst, daher ist sie nicht Teil des Artefakts. Die Zeit zur Erstellung des Checkpoints und die Größe des Artefakts sind als einmalige Kosten pro Modell und Konfiguration angegeben.
Der Wiederherstellungspfad selbst besteht aus der Agent-Einrichtung, der CRIU-Wiederherstellung, der CUDA-Wiederherstellung und dem Aufwecken mit Neuzuordnung, und die Aufschlüsselung des Kaltstarts zeigt, welche Initialisierungsphasen die Wiederherstellung überspringt. Ursprünglich wurde Snapshot für die Inferenz-Worker von NVIDIA Dynamo entwickelt, ist aber für die Integration durch andere Inferenz-Engines, Scheduler, Controller und Plattformen gedacht. Benchmarking-Werkzeuge und Anleitungen zur Reproduktion liegen im Repository zusammen mit Installations- und Nutzungshandbüchern, und ein Dynamo-Benutzerhandbuch beschreibt die Wiederherstellung von Workern. Entwicklungspartner haben Snapshot zudem an ihren eigenen Workloads bewertet.